この記事のまとめ
TypeSafe AIは、文章を書く代わりに型の決まった判断と確率を返すモデル「Jev」を早期アクセスで公開しました。ChatGPTのような生成AIとは目的が異なり、ソフトウェアがそのまま扱える判断を迅速に返す役割を担います。押さえておきたいポイントは以下の3点です。
- Jevは選択肢・スコア・確率という決まった形式で回答し、文章は生成しません。同一の状況に対して複数の質問をまとめて評価できます。
- 公表値では応答時間が70〜500ミリ秒、入力100万トークンあたり0.042ドルで出力は無料です。自社評価の「193.6倍高速」という数値は、理論上の上限寄りとされています。
- 型どおりの出力であっても、意味上の誤りは起こり得ます。モデル構造や較正の詳細は非公開であるため、重大な判断には人間の確認が前提となります。
TypeSafe AIとJevの基本
TypeSafe AIとSystem Oneモデル
まず、TypeSafe AIが何を公開したのかを整理します。この発表に注目が集まるのは、「AIが判断を返す」という設計思想が、従来の生成AIとは根本的に異なるからです。
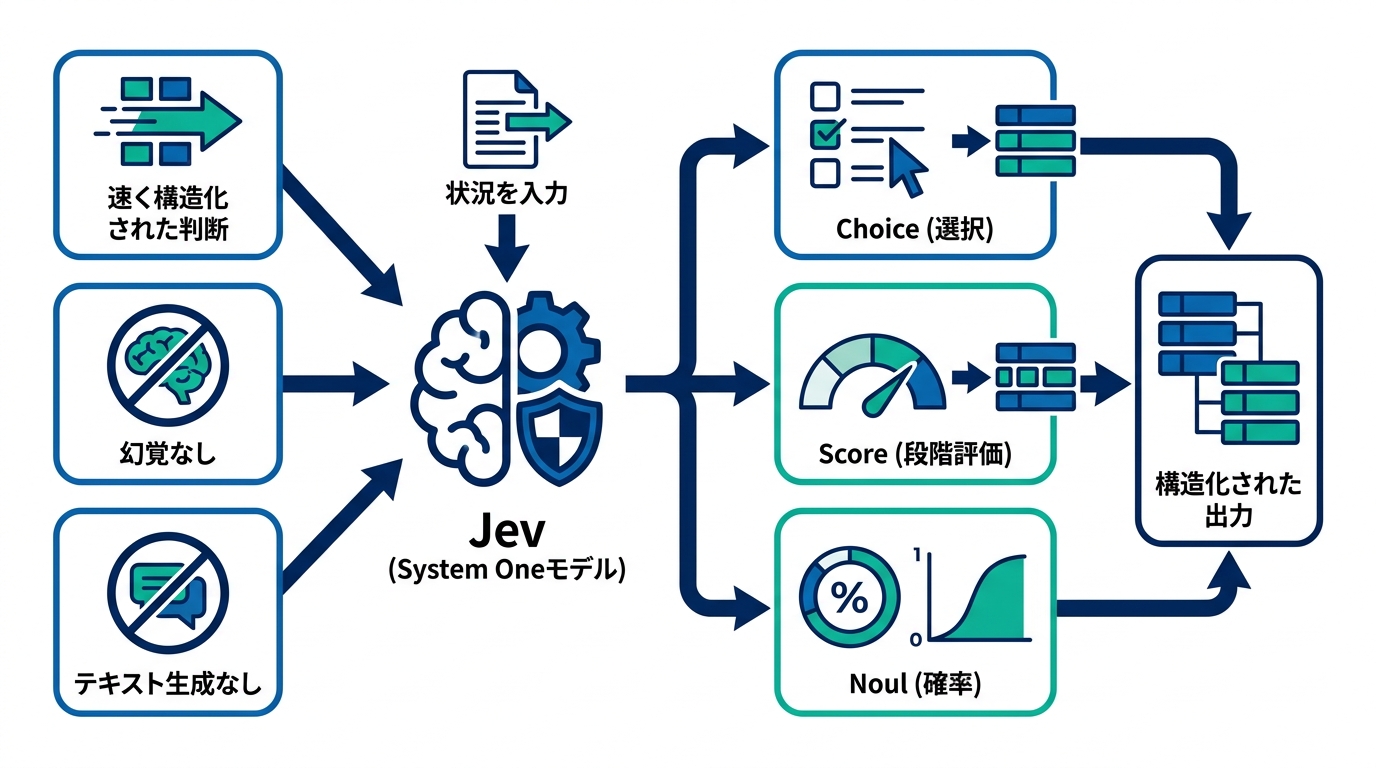
TypeSafe AIは、ソフトウェアがそのまま利用できる、高速で構造化された判断のための新しいモデル群「System Oneモデル」を発表しました。2年間のステルス期間を経ての公開であり、その第1号となるモデルがJevです。
同社は、JevがSystem Oneタスクにおいて既存のLLMと同等の知能水準に達しつつ、速度と効率は2桁上回ると述べています。テキスト生成を行わず構造化された出力に最適化されているため、ハルシネーション(幻覚)を起こさないと説明しています(参照*1)。
名前の由来も明確です。TypeSafe AIは、ダニエル・カーネマンの著書『Thinking, Fast and Slow』から着想を得て、高速で直感的な「System 1」の思考と、熟考を要する「System 2」の推論の区分をモデル分類の名前に採用しました。モデル名の「Jev」は、経済学者のウィリアム・スタンレー・ジェヴォンズにちなんでいます(参照*1)。
なお、この呼称は業界標準ではありません。kingy.aiのレビューでは、Jevは小型のチャットボットというよりも、汎用の意味分類器やリランカー、リスクゲートをプログラムから呼び出せるAPIとしてまとめたものに近いと説明されています。TypeSafeはこのカテゴリーをSystem Oneモデルと呼んでいますが、これは同社独自の用語であり、標準化されたモデル分類ではないと同レビューは指摘しています(参照*2)。
型付き判断と3つの質問
Jevの基本的な使い方は、コンテキスト(状況)を渡し、あらかじめ型の決まった質問を投げるという形式です。
質問の形式には以下の3つがあります。「Choice」は、事前に定義したリストから1つを選択します。たとえば問い合わせ内容を「請求」「技術」「営業」へ振り分けるようなケースです。
「Score」は、順序づけられた段階に当てはめて評価します。「落ち着いている」「いら立っている」「激怒している」といった感情の段階づけが典型例です。
「Noul」は、条件に合致する(はい/Yesである)確率を返します。「このメッセージは緊急性を示しているか」といった判定に利用できます(参照*3)。
返される値も形式が定まっています。Choiceでは選択された項目と各候補の確率が返され、Scoreでは定義した段階のどこに位置するかを示す数値が、Noulでは0から1までの確率値が返ります。
たとえば0.9であれば、「はい」である確率が90%という意味になります。これら3つの形式の質問は1回のAPIリクエストにまとめられ、各質問は同じ情報に対してそれぞれ独立して評価されます。Jevは最大255問まで並列で処理可能です(参照*3)。
ここで注意したいのは、質問同士の依存関係です。1回のリクエストに含まれる質問は、他の質問の回答を自動的には参照しません。2つ目の判断が1つ目の結果に依存する場合は、その結果を含めた別のリクエストをアプリケーション側から再度送信する必要があります(参照*3)。
Everyの記事では、自動化されたワークフローの次のアクションを決める「賢いif-then文」のようなイメージだと説明されています。たとえばカスタマーサポートの問い合わせに優先順位をつけるシステムにおいて、「この顧客は怒っているように見えるか」をモデルに判定させるとします。Jevが「0.9」と返答した場合、学習データに基づいて、該当する確率が90%と推定されたことを意味します(参照*4)。
ChatGPTなど既存AIとの違い
出力形式と学習目的の違い
違いは、「何を最適化しているか」と「何を返すか」に明確に表れます。生成AIを日常的に利用している立場から見ても、これは単なるAPIの仕様の違いにとどまらず、モデルが担う責任の範囲が根本的に異なると感じられます。
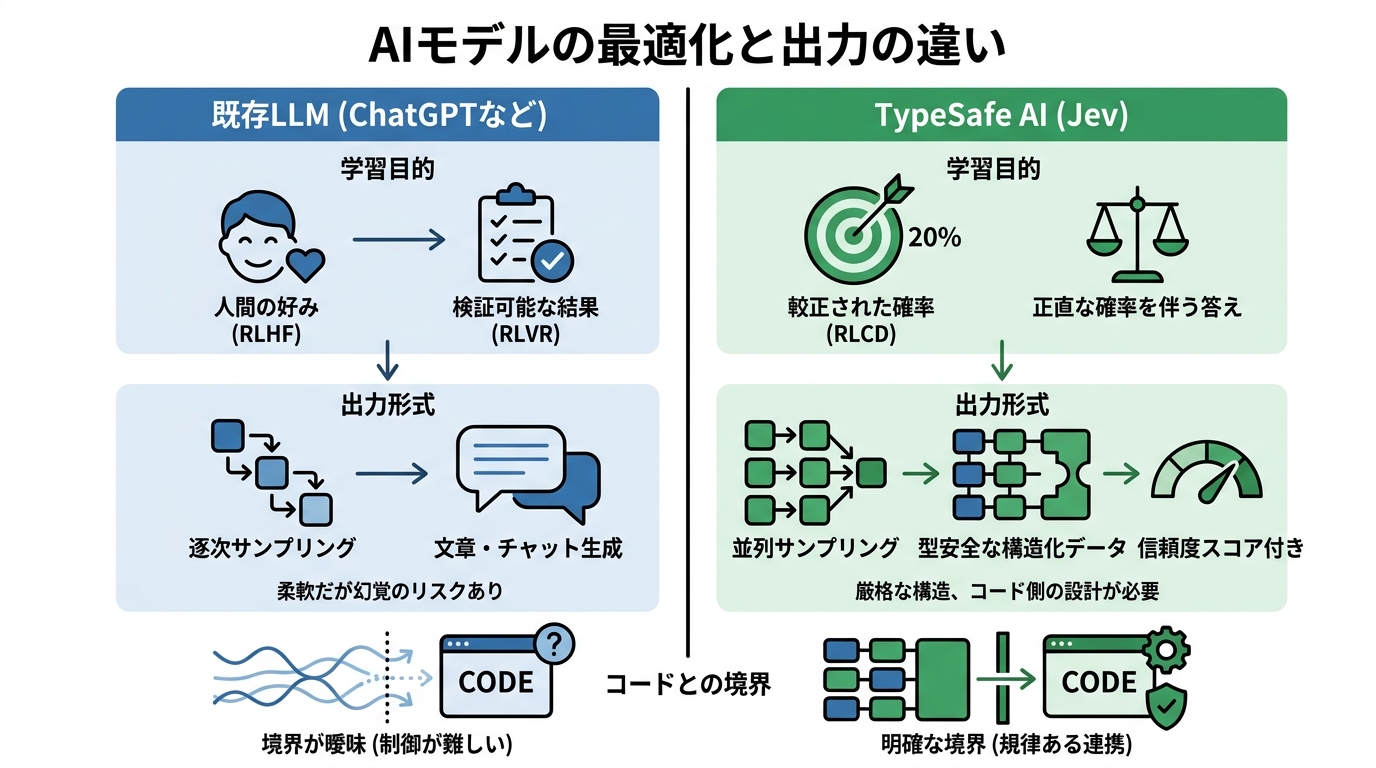
TypeSafe AIの整理によると、既存のLLMはRLHF(人間のフィードバックによる強化学習)やRLVR(検証可能な報酬による強化学習)によって最適化され、人間の評価者が好む自然な文章やチャットの応答、あるいはプログラムで検証可能な出力を目指しています。一方のJevはRLCD(較正された判断のための強化学習)によって最適化されており、System Oneタスクにおいて、認識として誠実かつ正確な確率を伴う回答を返すことを目指しています(参照*1)。
RLCDの狙いは、確率の信頼性を高めることにあります。RLHFは人間にとって好ましい表現を最適化し、RLVRは検証可能な結果に対して最適化を行います。
それに対してRLCDは、判断に付与される確率が、その判断が実際に正しい頻度と一致するように最適化を行うものとされています(参照*5)。ただし、これはあくまで学習上の目標であり、個々の回答が常に正しいことを保証するものではありません。
並列サンプリングと型安全
回答の生成プロセスや、出力形式の制約方法も異なります。
TypeSafe AIによると、既存のLLMのサンプリングは逐次処理で行われます。トークンを1つずつ生成し、それぞれが直前の出力内容を条件として次のトークンを決定します。
対してJevのサンプリングは並列処理であり、すべての出力を1回のクエリで生成する高効率かつハードウェアを意識した設計となっています。出力は型安全な構造化データであり、取り得る値とスキーマは事前に定義されています。モデルが型エラーを起こすことはなく、すべての回答に較正された確率と信頼度スコアが付与されます(参照*1)。
ただし、「型安全」であることは「常に正しい」ことを意味しません。axentiaの解説では、正解がtechnicalであるべきケースでも、Jevが正しい形式のままbillingと返してしまうことがあると指摘されています。TypeSafeの発表では「ハルシネーションを起こさない」と表現されることがありますが、妥当な解釈としては「出力が宣言された型に必ず準拠する」という範囲にとどまり、意味上の誤りや誤検知、バイアス、過信といった問題は依然として起こり得ます(参照*6)。
コードとの境界という強み
Jevの大きな強みは、モデルの役割を終える境界線が設計段階で明確に定められている点です。これは、生成AIの導入現場が最も悩まされる「どこまでをAIに委ねるべきか」という課題に、アーキテクチャの観点から応えようとするアプローチといえます。
kingy.aiのレビューでは、最も影響力が大きい特徴は速度そのものではなく、「不確実性がシステムに入り込む地点でモデルの処理が止まる設計」にあると評されています。しきい値の設定、条件分岐、権限管理、副作用の制御などはすべてコード側で管理し続けます。判断とアクションの両方を単一の言語モデルに任せる手法と比べ、規律あるアーキテクチャであるといえます(参照*2)。
一方で、この明確な境界線はシステム統合の手間も生み出します。同レビューは、開発チームが判断フローを設計し、ラベルやしきい値を定義し、確信度が低い場合のフォールバックを定め、自社データで精度を評価する必要があると指摘しています。Jevはトークンのオーバーヘッドを大幅に削減する一方で、ソフトウェア設計や評価に関わる工数を増加させる可能性があります(参照*2)。
もっとも、これは企業のAI導入において繰り返し見られる構図でもあります。ツール側が「判断の境界」を用意してくれたとしても、その境界をどこに置くかは最終的に開発チームが決定しなければなりません。Jevはその境界を明示的にコード側に残すことで責任範囲を曖昧にしませんが、「構造として扱いやすい反面、導入設計は決して容易ではない」という現実があります。
構造化出力を使うLLMとの比較
決まった形式で出力を受け取る仕組み自体は、既存のLLMにも存在します。この点は、Jev独自の価値を冷静に評価するうえで正しく理解しておく必要があります。
Microsoftのドキュメントによると、構造化出力(Structured Outputs)を利用することで、推論APIの呼び出し時に指定したJSON Schemaの定義にモデルを従わせることができます。Chat Completions APIとResponses APIの両方がこの機能に対応しています。これは従来のJSON modeとは異なり、単に有効なJSONであることだけでなく、指定スキーマへの厳密な準拠が保証されます(参照*7)。
したがって、両者の違いは「構造化データを返せるか」という形式ではなく、「どのように生成しているか」というアーキテクチャにあります。OpenAIやAnthropicなども構造化出力をサポートしており、OpenAIのStructured Outputsは制約付きデコードによってJSONスキーマの遵守を保証しています。
つまり、Jevが妥当な構造化データを返せること自体は、技術的に真新しいわけではありません。最大の違いは回答の生成プロセスにあります。従来のフロンティアモデルが出力トークンを1つずつ順番に生成するのに対し、TypeSafeによると、Jevは並列サンプラーを用いてトークンごとのテキスト生成を行わず、複数の構造化された質問を同時に評価します(参照*3)。
速度・価格と公開された評価
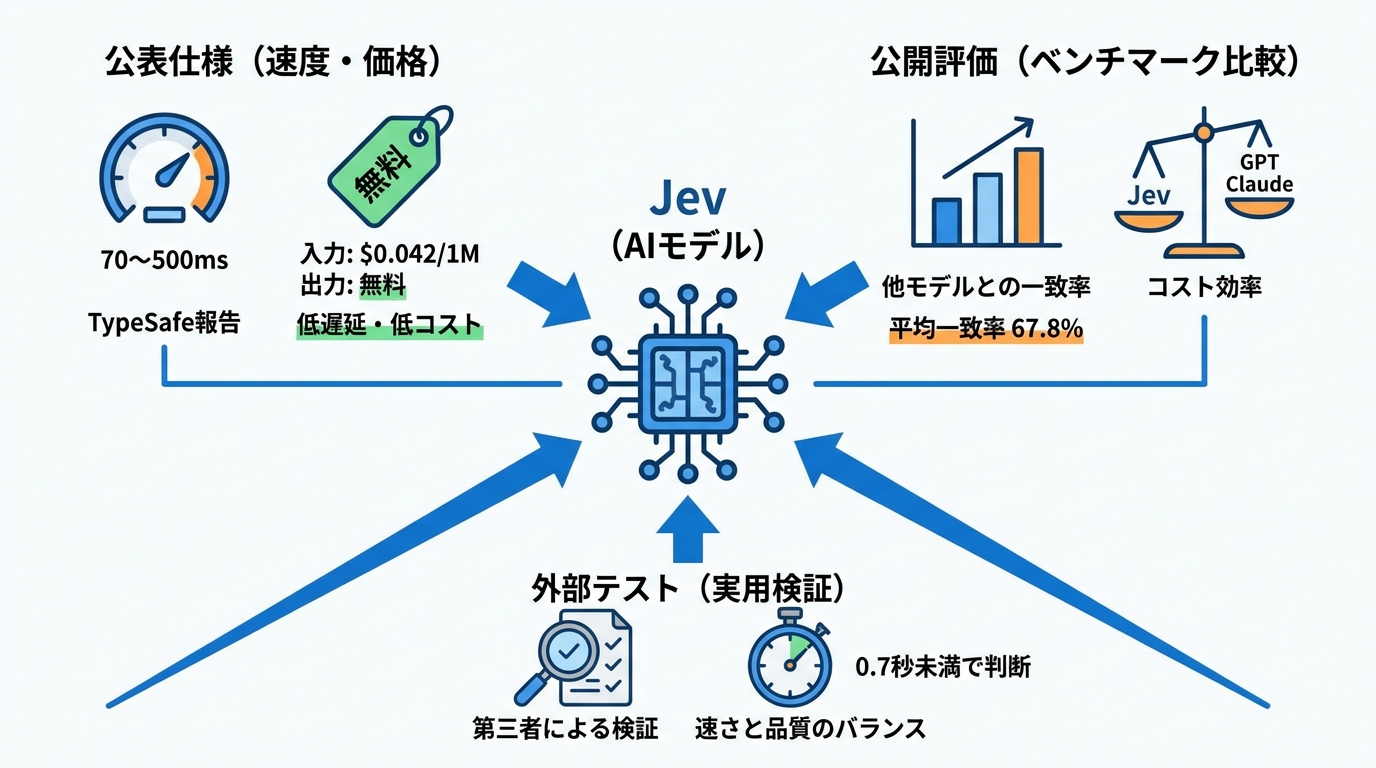
応答時間と料金の公表値
数値の前提条件を整理すると、本モデルの位置づけがより明確になります。新たなAIサービスを評価する際は、自社測定のデータがどのような条件下で算出されたかを確認することが重要です。
公表されている仕様によると、提供元はTypeSafe AIで、モデルはSystem Oneの第1弾となるJevです。学習手法にはRLCDが用いられ、料金は入力100万トークンあたり0.042ドル、出力は無料となっています。レイテンシーは70〜500ミリ秒とされ、早期アクセスとしてPythonおよびJavaScriptのSDK、ならびにHTTP APIが提供されています(参照*8)。
この速度と価格はTypeSafeの公表値です。axentiaの解説によると、TypeSafeはエンドツーエンドのレイテンシーを70〜500ミリ秒、入力コストを10億トークンあたり42ドルと発表しています。応答が長文テキストの生成ではなく軽量な数値やラベルの集合であるため、出力コストが無料に設定されているという説明です(参照*6)。
ワークフロー評価の中身
公開されているベンチマーク評価を見る際は、「何と比較した一致率なのか」を正確に把握する必要があります。
kingy.aiのレビューによると、TypeSafeが公開したワークフローダッシュボードは、4つのタスクにおける711ケースを対象としています。すべてのモデルが同一の検証基盤上でテストされ、GPT-6 AstraおよびClaude Fable 5.1の判断の平均をベースとした「参照ポリシー」との比較が行われています。つまり、報告された精度は第三者によって客観的に検証された正しさではなく、あくまで「基準とされた大規模モデルの出力との一致率」として捉えるべきだと指摘されています(参照*2)。
比較結果の詳細も公開されています。対象の4タスクにおいて、Jevは参照回答との一致率が平均67.8%、費用は1ケースあたり0.0004ドル、処理時間は0.4秒でした。
これに対し、GPT「Terra」は費用0.0304ドル、処理時間10.1秒で一致率は67.9%でした。Claude Sonnet 5の一致率も67.8%でしたが、費用とレイテンシーは大幅に増大しています。なお、最上位モデル群ではGPT「Sol」の一致率が74.1%、Claude Opus 5が73.1%を記録しており、特に請求書処理タスクではJevの61.8%に対してSolが79.1%と、最も大きな精度の開きが見られました(参照*5)。
TypeSafe AI自身も、公式サイトで掲げている「193.6倍高速」「444.6倍低コスト」という数字はこの評価データに基づくものであり、実環境での利得としては上限値に近いとの見解を示しています。検証用のワークフローは自社モデルに有利になるよう意図して選定されたものではなく、訓練データの分布にも含まれていないものの、自社のモデル性能評価チームが作成したデータセットであるため、一定の偏りが生じている可能性は認められています(参照*1)。こうした公表値を評価する際は、「自社に最も有利な条件が選ばれていないか」を常に意識し、193.6倍という数値を鵜呑みにせず、自社のタスク環境で検証することが欠かせません。
外部テストとデモで分かること
第三者による検証テストや公開デモからは、処理速度と品質のトレードオフが見えてきます。
Everyで評価を担当したMike Taylorの検証では、37件の文書に対して各21問、計777件の判断を0.7秒未満で取得でき、かかった費用は推定0.25セントでした。また、12件のテキストサンプルを用いた比較では、1件あたりの処理時間の中央値がJevの0.35秒に対してClaude Fable 5.1は8.83秒でした。一方で、あらかじめ設定されていた7つの不備のうち、Jevは6つを検出し、Fableは7つすべてを検出しました(参照*3)。
デモ動画や事例は、処理能力の特性を端的に示しています。TypeSafe AIによると、ゲーム『Doom』のプレイデモでは毎秒10回のクエリを処理し、1時間あたり約7ドルのコストに収まりました。ただし、これは画像処理ではなくテキストベースの構造化データを判定したものであり、AIを用いない専用ボットのほうがより上手にプレイできるとされています(参照*1)。
また、ブラウザ自動操作エージェントの検証では、同一モデル・同一設定で6回交互にテストした結果、双方とも3回すべてタスクを完遂しました。タスク所要時間の中央値は9.450秒から7.092秒へと約25%削減され、プロトコル呼び出しの中央値も1,092回から101回へと激減しましたが、これが一般的な信頼性ベンチマークではない旨も明記されています(参照*9)。
向いている使い方と試し方
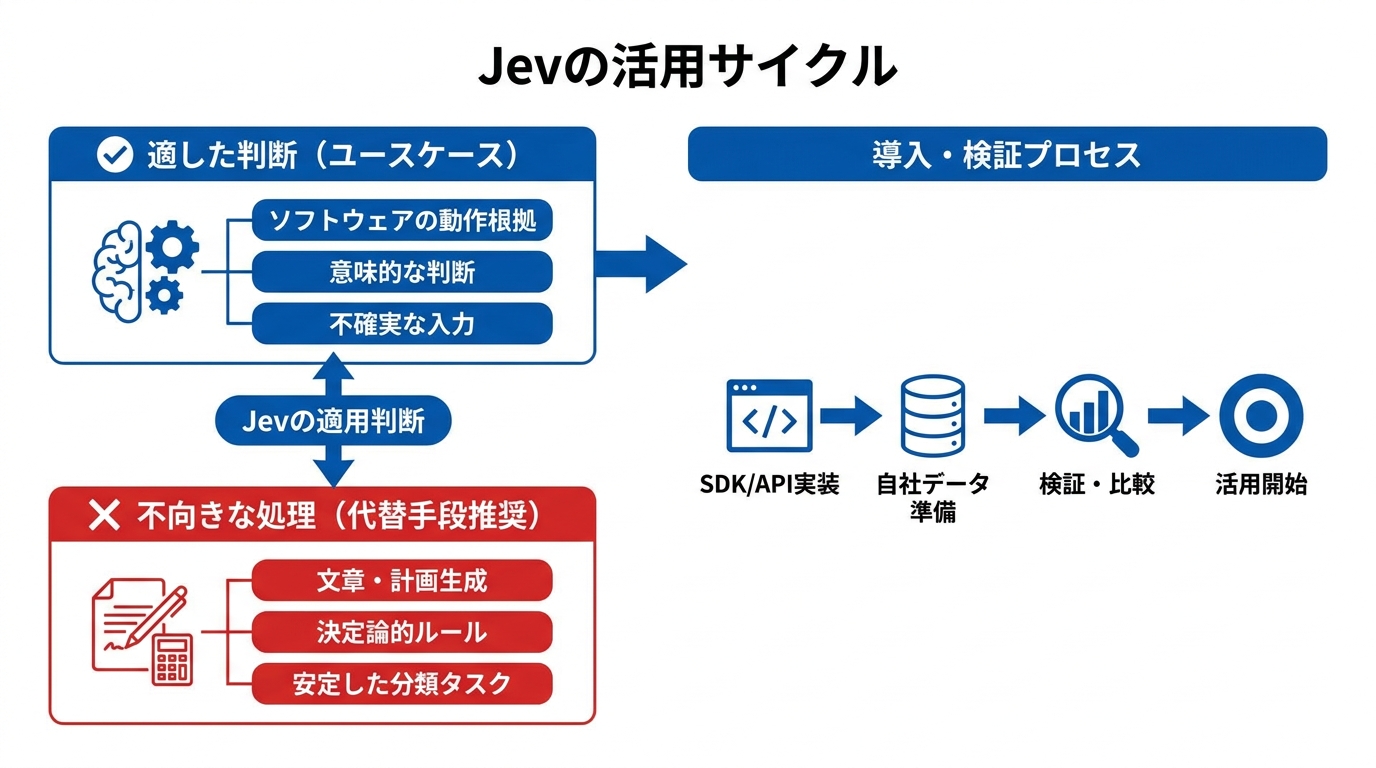
適したユースケース
公開されたベンチマークのタスクを見ると、Jevがどのような判断処理に適しているかが分かります。逆に言えば、これらの用途から外れるタスクに対して過度な期待を寄せるべきではありません。
TypeSafeの公開テストでは、以下の4つのワークフローでJevが検証されています。「セキュリティアラートの振り分け(クローズ、エスカレーション、封じ込め)」「サポート対応履歴から有人対応が必要かの判定」「請求書の処理方針(支払い、保留、差し戻し)の決定」、そして「カスタマーサポート用アシスタントの適切な応答方針の選択」です。これらはいずれも人が読む文章の作成ではなく、ソフトウェアが次のアクションを起こすための判断材料です(参照*8)。
具体的なシステムへの組み込み例も挙げられています。axentiaの解説によると、自律エージェントが適切な文脈を取得できているかの判定、提案されたアクションにリスクがないかのチェック、生成されたドラフトが要件に違反していないかのガードレールといった用途に適しています。
また、サポートシステムにおいて問い合わせキューを割り当てる前の「ユーザー意図」「緊急度」「不満度」の分類や、検索システムにおいて大規模モデルに渡す前に候補ドキュメントを絞り込むスコアリング処理などにも有用です(参照*6)。
向かない場面
一方で、別のソリューションを選んだほうがよい場面も明白です。
axentiaの解説によると、Jevはユーザーへの返信文を作成したり、インシデントの詳細を説明したり、プログラムコードを記述したり、自由形式の実行計画を立案したりすることはできません。ワークフローの成果物として文章が必要な場合は、定型テンプレートや生成AIモデルが引き続き不可欠です。また、すでに確定的なビジネスルールで処理できている領域にも向いていません。
たとえば「請求金額が上限設定を超えているか」といった判定は、モデルを呼び出すまでもなく従来のプログラムコードで直接計算すべきです。Jevが真価を発揮するのは、「入力データに不確実性があり、意味的な解釈を伴う判断」に限定されます(参照*6)。
分類タスクにおいても慎重な見極めが求められます。同解説では、すでに十分な教師データが存在する定常的な分類業務であれば、従来型の機械学習分類器やリランキングモデルを採用したほうがコストを抑えられ、監査が容易で、自社のオンプレミス環境や専用インフラで安全に運用できる可能性があると指摘されています(参照*6)。
SDKでの呼び出しと評価手順
検証を始める窓口としては、専用SDKとHTTP APIが用意されています。
JavaScript SDKを利用する場合、Node.js 20以降の環境でnpm install @typesafe-ai/sdkを実行して導入します。環境変数にTYPESAFE_API_KEYを設定し、@typesafe-ai/sdkからchoiceやTypeSafeClientをインポートしてクライアントを初期化する流れとなります(参照*10)。Python SDKも同様の設計思想であり、パッケージをインストール後、環境変数にTYPESAFE_API_KEYを設定して利用します。typesafe_sdkからChoiceやTypeSafeClientを読み込み、client.system_oneのstate引数に対象テキストを渡して実行するコード構成が提示されています(参照*11)。
導入検討にあたっては、自社の実データを用いた検証が不可欠です。axentiaの解説では、過去の実務データから正解ラベル付きの検証セットを作成し、既存システムとJevの性能を直接比較するステップが推奨されています。評価すべき指標は、チームが定義した正解ラベルに対する判断精度、信頼度スコアの較正具合、エンドツーエンドでのレイテンシー(p50およびp95)、フォールバックを含めた判断1件あたりのトータルコスト、そして誤検知や見逃しが発生した際の運用リスクコストです(参照*6)。
導入前に知る注意点
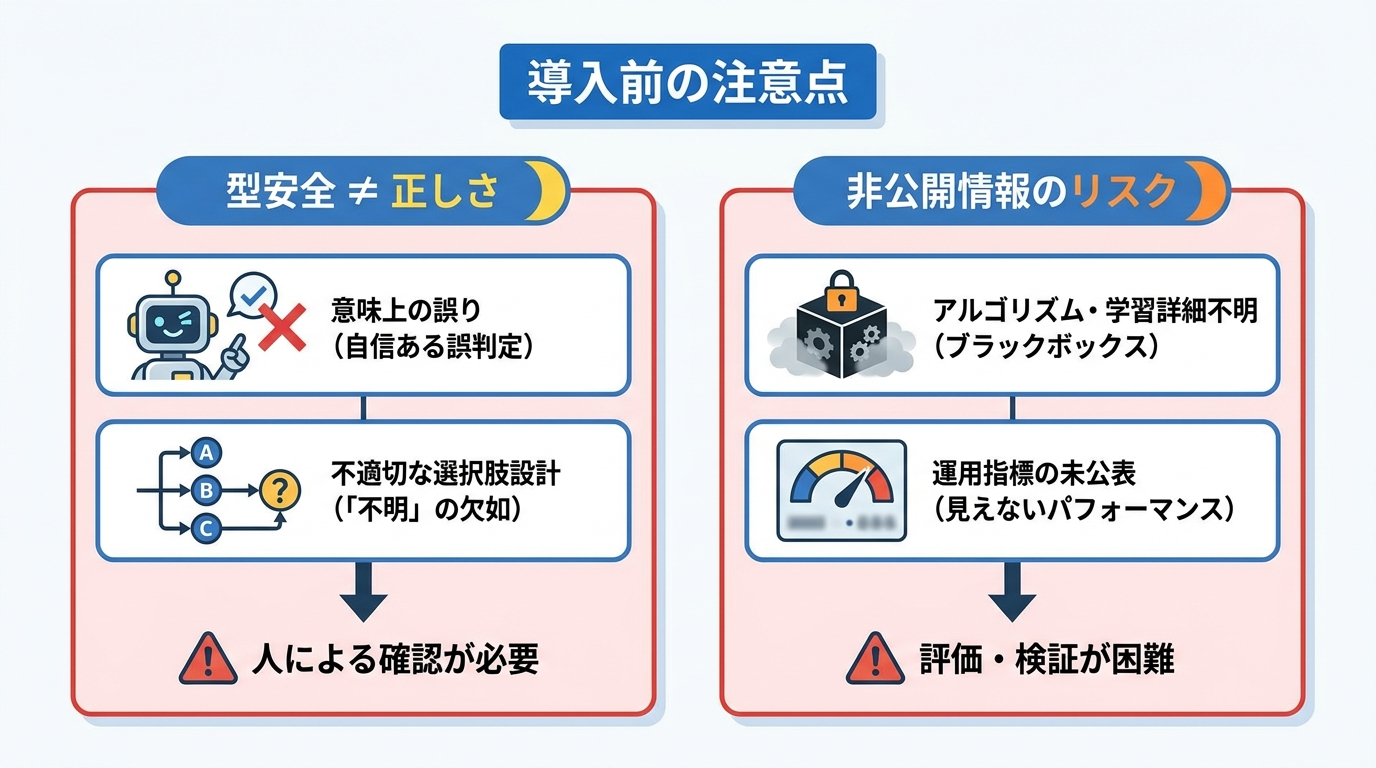
型安全と正しさの違い
「ハルシネーションを起こさない」という謳い文句は、あくまで出力形式の整合性に関する話にすぎません。これは公式発表を正しく理解するうえで極めて重要であり、「型として正しいこと」と「意味内容として正しいこと」は明確に区別して考える必要があります。
kingy.aiのレビューでも、型として妥当な出力であっても、意味的に誤っているケースは十分にあり得ると強調されています。たとえば本来の担当部署がtechnicalであるべきケースで、Jevがdepartment = billingという回答をもっともらしい確率分布とともに返してしまうことがあります。
誤ったChoiceが返されたとしても、それは型エラーではありません。高い確信度を持った誤判定は、長文の幻覚テキストとは外見が異なるものの、システム運用に深刻な支障をきたし得る「モデルの誤り」そのものであると指摘されています(参照*2)。
選択肢の設計不備も誤動作の原因となります。不適切に定義されたスキーマは状況を悪化させ、正しい選択肢が候補に含まれていない場合でも、モデルは残されたいずれかの選択肢に確率を割り振ってしまいます。開発者は「確率の低下によって設計不備に必ず気づける」と思い込むのではなく、「不明」「該当なし」「判定材料不足」といった例外用の選択肢をあらかじめ設計に組み込んでおく必要があります(参照*5)。
重大な結果を伴う判断には、より慎重な姿勢が求められます。axentiaの解説では、型付きの確率値は安全ガードのインターフェースとして非常に有用であるものの、重大な失敗リスクについて厳密に評価される前に、人の確認プロセスを完全に撤廃してよい理由にはならないと警告されています(参照*6)。
この課題は、生成AIの導入支援において頻繁に直面するものと本質的に同一です。出力の形式が整っているほど、現場のユーザーは「AIが正しく判断してくれた」と過信しがちになります。確率付きの構造化データとして整然と返されるJevにおいては、その傾向がさらに強まるリスクがあります。ミッションクリティカルな判断においては、引き続き人間によるレビュー体制を前提として設計すべきです。
公開されていない情報
外部から検証可能な情報には明確な制限が存在します。
kingy.aiのレビューでは、現時点で不明な重要論点が整理されています。「並列サンプラー」という表面的な説明を超えて、モデルの内部構造が自己回帰型言語モデルとどのように異なるのか。RLCDが具体的にどのように実装され、どのような報酬体系やスコアリング基準を用い、較正精度をどのように計測しているのか。
また、公表された確率の正確性が、入力データの偏りや敵対的なプロンプト、出現頻度の低いラベルに対しても維持されるのか。さらに、本番環境におけるp95やp99のレイテンシー、最大同時実行数、レート制限、リトライ発生率、サービス可用性の保証水準など、実運用に不可欠な指標も明らかになっていません(参照*2)。
特にRLCDの詳細は非公開となっています。2026年9月15日時点において、TypeSafeはRLCDのコンセプトこそ説明しているものの、第三者がアルゴリズムとして客観的に検証できるレベルの情報は開示していません。報酬関数、ネットワーク構造、学習手順、較正手法はすべてブラックボックスであり、較正曲線やピアレビューを受けた論文も公開されていないと報告されています(参照*5)。
加えて、Jevはモデルの重みが非公開(クローズドウェイト)の早期アクセスモデルとして提供されており、TypeSafeはパラメータサイズ、学習データセット、SLA(サービス水準合意)、レート制限、本番レイテンシーのパーセンタイル分布などを明らかにしていません(参照*6)。
おわりに
Jevの本質は、「応答が速いChatGPT」ではありません。kingy.aiのレビューが指摘するように、Jevは一般的な意味での自律型エージェントではなく、型安全な意味的判断を大量かつ迅速に処理し、不確実性の指標を返し、制御の主導権をソフトウェア側へ戻すために設計された特化型モデルおよびAPIです(参照*2)。
同レビューは、本製品が派手なプロモーションの文句より機能範囲は限定的であるものの、実運用システムにとってはより実践的で有用な選択肢になり得ると評しています(参照*2)。生成AIの実務活用を推進してきた経験からも、「何でもできるツール」よりも「担う役割が明確なツール」のほうが、業務基盤に定着しやすい傾向があります。文章生成ではなく「判断の高速処理」を任せるコンポーネントとして、自社の業務データを用いて小さくPoC(概念実証)を進めるのが堅実なアプローチです。モデルの詳細が非公開である以上、公表されたベンチマーク数値を過信せず、自社環境での検証を最優先に進めるべきでしょう。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事した後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にWebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書『頭のいい人が話す前に考えていること』が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Introducing System One Models & Jev
- (*2) Kingy AI – TypeSafe Jev Review: The AI Model That Doesn’t Generate Text
- (*3) Mohammed Shehu, PhD – AI strategist – What Is Jev? A Practical Guide to Typesafe AI’s Decision Model
- (*4) Mini-Vibe Check: TypeSafe's Jev Judged Everything I’ve Written in 0.7 Seconds
- (*5) Jev: The Language Model That Won’t Talk
- (*6) Axentia – Jev AI Explained: A Decision Model Built for Software, Not Chat
- (*7) Docs – How to use structured outputs with Azure OpenAI in Microsoft Foundry Models – Microsoft Foundry
- (*8) AI/TLDR – Jev – TypeSafe's model returns typed decisions,…
- (*9) GitHub – GitHub – browser-use/jev-ultrafast · GitHub
- (*10) GitHub – typesafe-ai/typesafe-sdk-js: The official TypeScript/JavaScript library for the TypeSafe API · GitHub
- (*11) GitHub – typesafe-ai/typesafe-sdk-python: The official Python library for the TypeSafe API · GitHub