この記事のまとめ
政府は2026年8月25日、生成AI事業者に透明性の確保と知的財産権の保護を促す「プリンシプル・コード」を策定しました。罰則や法的拘束力は設けず、原則を遵守するか、遵守しない理由を説明するかを求める形式です。
あわせて、日本のIP保有者が事前に利用条件を提示し、その範囲内で生成を認めて収益を還元する民間の仕組みも動き始めています。主なポイントは以下の3点です。
- プリンシプル・コードは法改正ではなくソフトローであり、「コンプライ・オア・エクスプレイン」の手法を採用しています。
- モデルと学習データの概要開示、権利者からの照会、AI利用者からの照会という3原則が定められていますが、学習データの全件公開を求めるものではありません。
- 権利者側では、誰がどのIPをどのような条件で利用したかを数値化し、ライセンス管理と収益分配を目指す仕組みが発表された一方、国による対価還元の枠組みはまだ検討段階にあります。
罰則を置かない指針という選択
プリンシプル・コードの目的と位置づけ
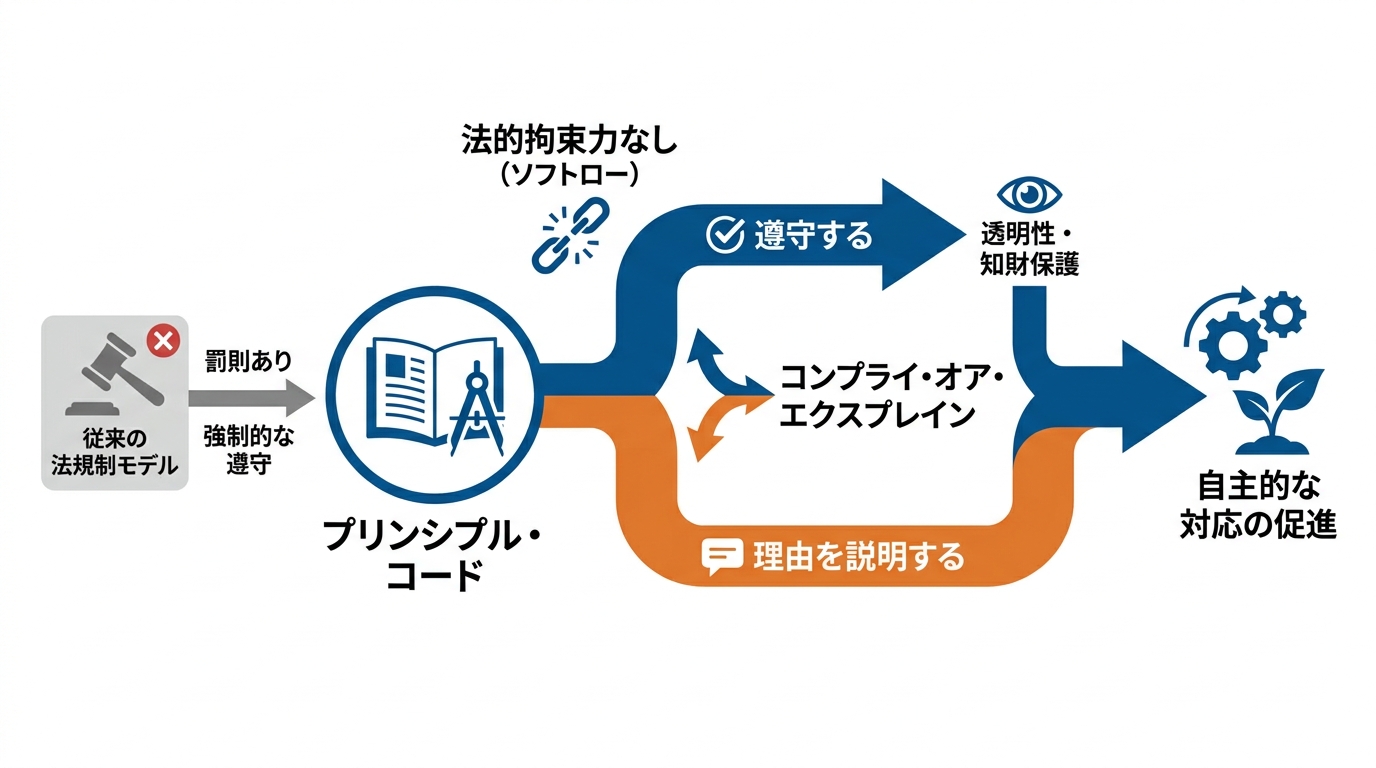
プリンシプル・コードは、生成AI事業者が取り組むべき透明性の確保と知的財産権保護の措置について、基本原則をまとめた文書です。法律ではなく、いわゆるソフトローとして整備されたところが最大のポイントです。
政府は8月25日、生成AI事業者向けに透明性の確保と知的財産権の保護を促すプリンシプル・コードを策定しました。AIモデルに関する情報の公表や権利者からの照会対応などを定めており、法的な拘束力を伴わない形で事業者の自主的な対応を促しています(参照*1)。
この文書は、人工知能関連技術の研究開発及び活用の推進に関する法律(令和七年法律第五十三号)の趣旨を踏まえたものです。生成AI技術の進歩促進と知的財産権の適切な保護の両立、そして権利者や利用者にとって安全・安心な利用環境を確保することが目的に掲げられています(参照*2)。
誤解されがちですが、このコードの策定によって著作権法などが改正されたわけではありません。法律によって新たな権利義務や罰則を定めるのではなく、事業者の自発的な対応を促すソフトローとして整備されました。AIの学習段階における著作物の利用については、引き続き著作権法第30条の4などに基づいて判断されます(参照*3)。私が生成AIコンサルティングの現場で受ける相談でも、「コードが出たから何かが変わった」と思い込んでいるケースは少なくありません。しかし実態は、ルールの性質が変わったのではなく、事業者に「説明責任を求めるチャネルができた」という理解が正確です。
コンプライ・オア・エクスプレインの仕組み
罰則を設けない代わりに採用されたのが、原則を遵守するか、遵守しない理由を説明するかという進め方です。コーポレートガバナンスの世界では定着した手法ですが、生成AI規制に持ち込まれたのは今回が初めてに近く、実効性の評価が分かれる部分でもあります。
「コンプライ・オア・エクスプレイン」とは、原則を実施するか、実施しない場合にはその理由を説明するよう求める手法を指します。個別具体的な事情に照らして実施が適切でない原則がある場合、その理由を十分に説明することで、一部の原則を実施しないことも認められています。
ただし説明を行う際は、生成AIの利用者や権利者から十分な理解を得られるよう工夫することが求められます。この手法は、コーポレートガバナンス分野におけるスチュワードシップ・コードなどの取組を参考にしたものです(参照*2)。
私自身、企業への生成AI導入支援をしていて実感するのは、「守れない理由を説明する」というプロセス自体が、組織に相当の言語化負担をかけるという点です。ルールへの準拠状況を外部に説明できる形で整理するには、まず業務を分解し、どこでどうAIを使っているかを記述しなければなりません。便利に使っていても、その実態を文書化している企業はまだ少ない。コンプライ・オア・エクスプレインは「罰則がない分、緩い」と見えますが、真面目に取り組むほど準備コストは低くないのです。
また、開示の範囲にも一定の線引きがなされています。生成AI事業者に帰属する機微な情報、すなわち営業秘密や安全性・セキュリティに関わる情報の強制開示を求めるものではなく、法的拘束力を持つ規範でもありません(参照*2)。
対象となる事業者と対象外の範囲
誰が対象になるのかは、公衆に向けて提供されているかどうかによって分かれます。
適用対象は、文章や画像などを生成するAIモデルを構築する「システム開発者」と、自社サービスにAIを組み込んで公衆に提供する「サービス提供者」の双方です。国内に拠点を持たない海外事業者であっても、日本向けにシステムやサービスを提供している場合は等しく対象となります。規制の枠組みとしては、直接的な罰則や法的拘束力を伴わないソフトローの形式が採られています(参照*4)。
一方で、対象外となるケースも存在します。第三者の権利を侵害する成果物が生成される恐れが極めて低い生成AIシステムを開発する場合などは、対象から除外されています(参照*1)。
自社の業務内でChatGPTを利用しているだけのようなケースも対象外です。適用されるのは、生成AIシステムを構築して公衆に提供する開発者や、生成AIを組み込んだサービスを公衆に提供する事業者に限られており、公衆提供を伴わない社内利用などは含まれません(参照*5)。
三つの原則が開く三つの入口
モデルと学習データの概要開示
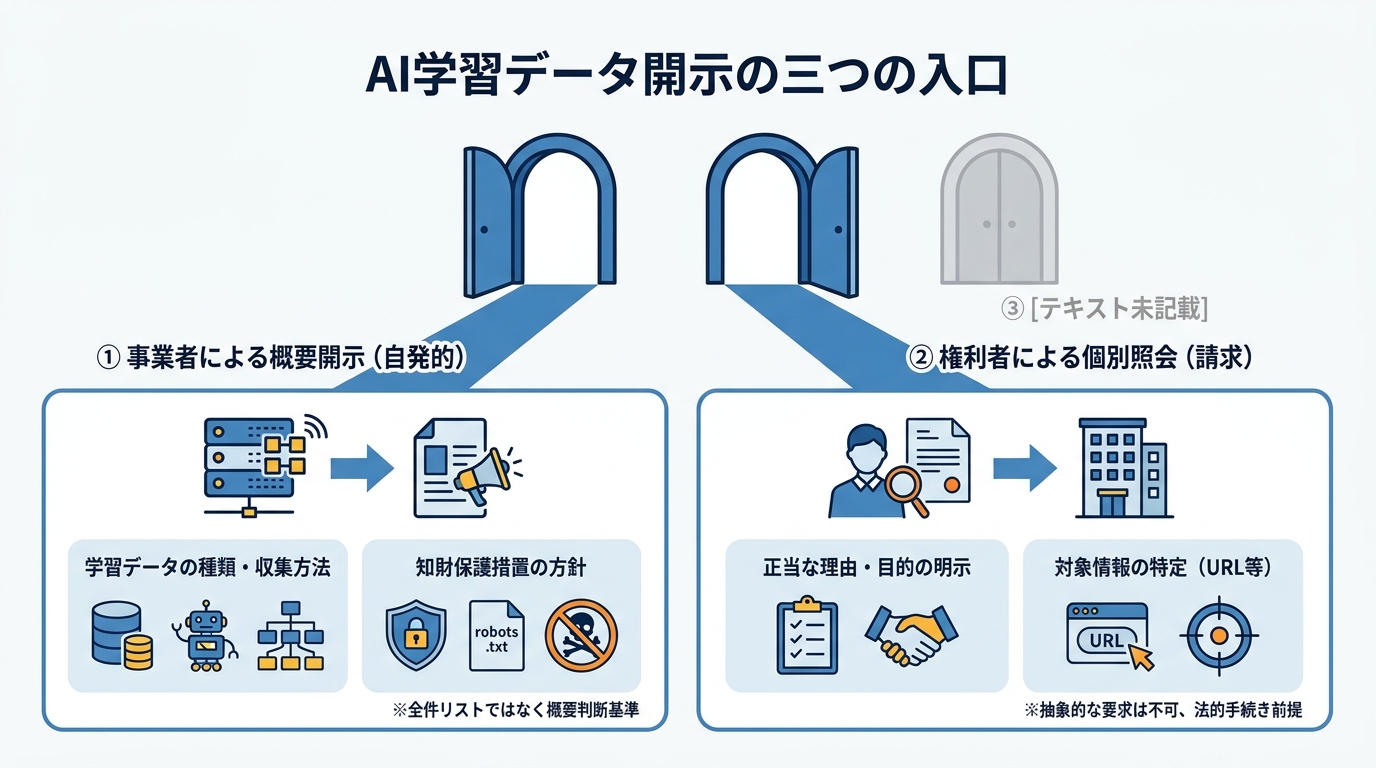
1つ目の入口は、事業者が自発的に公表する概要情報の開示です。
学習データに関しては、学習や検証などに用いられたデータに関する事項が挙げられています。データの種類にはRAG(検索拡張生成)で用いるものも含まれ、ウェブクローリングや第三者から取得した非公開データセット、公開データセット、その他の手段で収集されたデータ、合成データの利用有無や目的などが並びます。クローラについても、目的、収集期間、名称・識別子、第三者クローラの利用有無やその識別子などが対象です(参照*2)。
さらに、知的財産権を保護するための措置も示されています。ペイウォール等のアクセス制限やrobots.txtなどの機械可読な指示に従うクローラの採用、ユーザーエージェントごとの措置の公開と変更時の通知、学習ログの一定期間保持、海賊版サイト等へのクロール回避への取組などが含まれます(参照*2)。
ここで求められているのは、学習データの全件リストやモデルの内部構造をすべて公開することではありません。データの種類や取得手法、クローラの運用方針、知財保護措置などの概要を、権利者や利用者が判断できる水準で明らかにすることが主眼となっています(参照*3)。
権利者による照会の条件
2つ目の入口は、権利者が個別に開示を請求する手段であり、これにはいくつかの要件が定められています。
開示請求が満たすべき事項として、原則2開示要求者に該当することを示す理由の提示や、回答の利用目的の明示、およびその目的外で利用しない旨の誓約が挙げられます。さらに、原則2対照情報を示したうえで、その情報との関係において事業者に開示を求める正当な理由を特定することも求められます(参照*2)。
注意すべきは、「自身の作品が学習されたかどうか調べてほしい」といった抽象的な要求ができる制度ではない点です。開示を求める側があらかじめ、事業者が容易に確認できるURLなどを提示する必要があります。また原則として、権利者が開示を求める際には、法的手続きを行っているか、その準備を進めていることを示さなければなりません(参照*3)。
AI利用者による照会の条件
3つ目の入口は、コンテンツを生成したAI利用者からの照会です。
これは利用者による開示請求への対応を定めたものです。画像生成AIサービスでコンテンツを出力したユーザーが、既存の創作物と同一または類似しているものを発見し、当該サービスに用いられたAIモデルの学習データを確認するといった場面が想定されています。ただし、この開示請求には法的手続きに利用しないことなどの制限が付されています(参照*1)。
この条件はガイドライン上にも明記されています。回答の利用目的を明示することに加え、原則3開示要求者がその目的以外、あるいは訴訟の提起、調停の申立て、ADR(裁判外紛争解決手続)の申立てに用いない旨を誓約することが義務づけられています(参照*2)。
届出と一覧公表という実効性の担保
罰則が設けられていない代わりに用意された仕組みが、受入れの表明と届出、そして事業者一覧の公表です。「遵守しているかどうかを外部から見える状態にする」という構造で、実効性を担保しようとしています。
事業者が基本原則を受け入れる際は、自社のウェブサイトで公表したうえで政府に届け出を行い、対応状況を「コンプライ・オア・エクスプレイン(遵守するか、できない理由を説明するか)」の方式で提示することが求められます。政府側は、受入れを表明した事業者の一覧および各社の公開情報へのリンクを公表します(参照*6)。
届出先は内閣府知的財産戦略推進事務局であり、コーポレートサイトでの受入れ表明と各原則の実施状況の公表が期待されています。事務局は届出のあった事業者一覧と各社の公表ページへのリンクを案内し、業界全体への届出を促します。ただし、事務局自身が届出内容の審査を行わず、第三者からの照会にも応じないと明記しているため、認証や格付けを目的とした制度ではありません(参照*5)。
この点は、正直に言えば「緩い」と感じる部分です。審査も認証も行わず、届出の内容が実態に即しているかの検証主体も明確でない。つまり、善意のある事業者が誠実に対応する一方で、そもそも届け出ない事業者を止める手段がほとんどありません。日本新聞協会が「実効性の逆選択」を懸念するのは、こうした構造を見てのことであり、私もその懸念は妥当だと考えています。
先に条件を書く民間の仕組み
ライセンス管理と収益配分の考え方
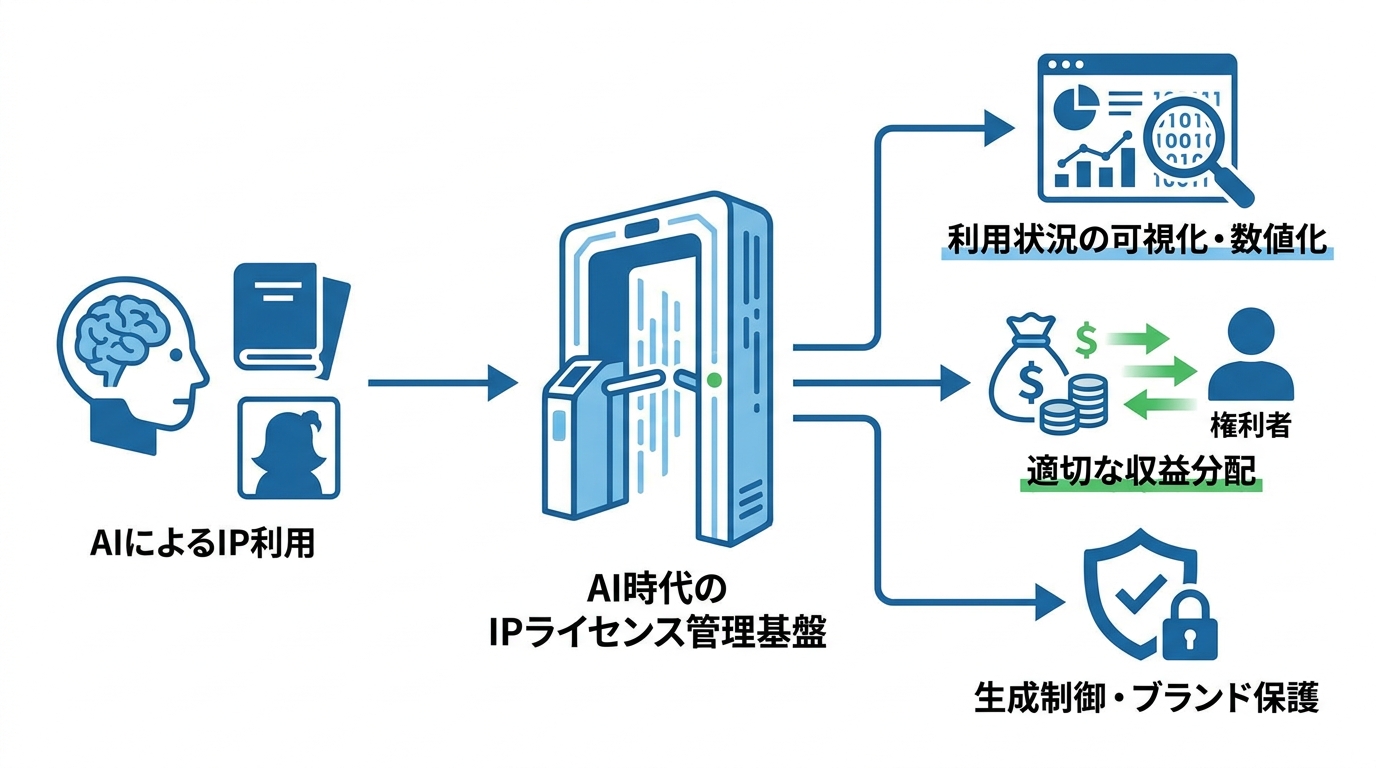
政府側の指針と並行して、権利者側からあらかじめ利用条件を提示し、その許諾範囲内でAIに活用してもらう仕組みづくりも民間で進んでいます。事後的に照会・交渉するより、事前に条件を「書いておく」ほうが合理的だという発想で、私もこの方向性には共感しています。
ネクシィーズグループの発表によると、同社が手がける「Kagami Gate」は、AI時代における知的財産利用の「改札ゲート」として機能します。高速道路のETCや金融市場の証券取引所のように、誰がどのIPをどのような範囲や条件で利用したかをリアルタイムに数値化し、適切なライセンス管理と収益分配を実現する位置づけです(参照*7)。
参画の輪については、現時点では賛同が集まりつつある段階と説明されています。同社は、PoC(実証実験)に先立つ「IP/AI共創宣言」に対してすでに複数のAI企業やIPホルダーからの賛同を得ており、今後は世界中のAI企業に加え、日本を中心とした原作者、出版社、放送局、芸能事務所などのIPホルダーが加わっていく見通しを示しました(参照*7)。
キャプテン翼のPoCが示した範囲
先行事例として、『キャプテン翼』を題材とした動画生成のPoCが実施されました。
KAGAMIAI Holdingsの発表によると、このPoCの実装では、システムがPixVerse上でのIP利用状況を正確に監視し、各AIモデルやエージェントが特定のIPをどの程度利用しているかを定量化することで、透明性の高い利用管理を実現します。同時に、IP保有者であるTSUBASAおよび原作者の意向に沿った生成制御を行い、商用の二次利用やファン作成コンテンツの制限、収益化を伴う公開の可否など、ユーザーが生成可能な範囲を管理してブランドを保護するとしています(参照*8)。
なお、この提供は期間を限定した取り組みでした。ファンは7月26日までの間、KAGAMI Gateとのライセンス提携を通じ、PixVerse上で『キャプテン翼』のキャラクターを登場させたオリジナルコンテンツの作成が可能とされていました(参照*9)。
国の側で進む対価還元と取引基盤の検討
クリエイターに対価を還元する枠組みについて、国の文書では依然として検討段階にあると記されています。
政府の計画文書では、「生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード(仮称)」を制定して国内外への周知を図るとともに、クリエイター等への対価還元を促す枠組みの構築を推進する必要があると示されました(参照*10)。
また経済産業省の資料では、学習データとして利用されるコンテンツの取扱い、AI生成物による権利侵害リスク、権利者の許諾のもとで創出された価値の適切な還元方法などが課題として整理されています。コンテンツの利用実態を権利者が把握するのは容易ではなく、利用状況の可視化や対価還元の仕組みが未だ十分に確立されていないことから、まずは課題の整理と対応策の検討を進める方針が示されています(参照*11)。
学習されたか、を知る手段の限界
照会で分かることと分からないこと
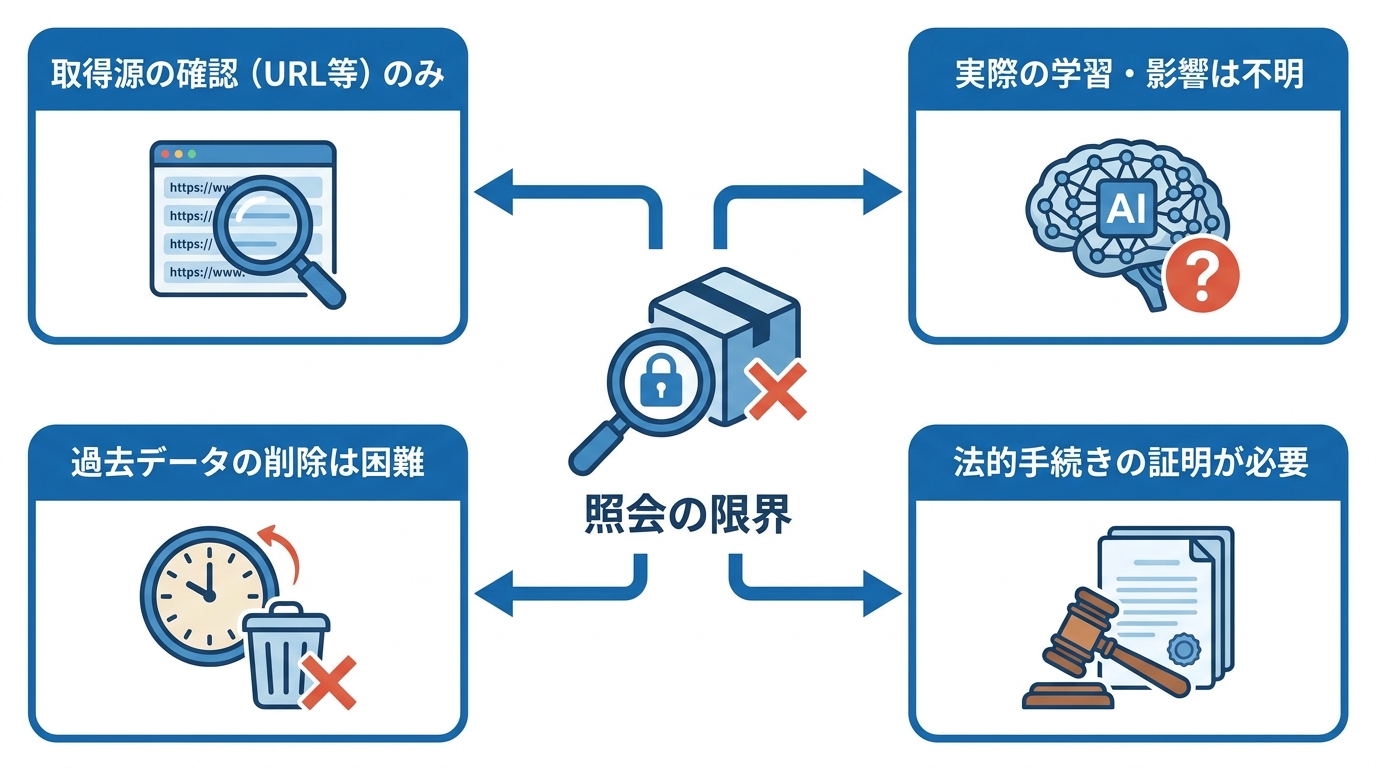
照会を行ったとしても、自身の作品が学習されたかどうかを完全に把握できるわけではありません。
開示の対象となるのは、事業者が容易にアクセス・確認できるURLなどが学習データの取得源に含まれているかどうかが中心です。そのため、作品そのものが実際に学習されたのか、あるいはモデルの出力結果にどの程度影響を及ぼしたのかまで判明するとは限りません。さらに権利者が開示を求めるには、原則として法的手続きを行っているか、その準備を進めていることを証明する必要があり、単なる関心や懸念だけで広範な情報開示を求められる仕組みではないのです(参照*3)。
また、過去に収集されたデータについても一定の制約があります。ウェブ上から作品を削除したり、robots.txtでクローリングを拒否したりしたとしても、過去にすでに収集されたデータまで遡って自動的に削除されるわけではありません(参照*3)。
意思表示の場としての登録の仕組み
事後的に照会するだけでなく、あらかじめ利用に関する意向を示しておく公的な登録システムも用意されています。
文化庁の資料によると、このサービスの目的は著作物等の利用可否に係る意思表示を行う場を提供し、権利者探索に資する枠組みを構築することです。対象著作物は未管理公表著作物等で、すべての分野を対象とし、登録によって新裁定制度からのオプトアウトが可能となります(参照*12)。
報告書によれば、登録者向けと検索者向けの2種類の利用規約を作成し、2026年2月26日に運用を開始したシステム上で公開されました。登録を行った著作者等の57%が利用可否として「利用不可」を選択しており、その背景には、作品の世界観やイメージを厳格に保持したい意向や、生成AIによる学習・出力に利用されることへの強い懸念が存在すると分析されています(参照*13)。
海外大手が乗るかという分岐点
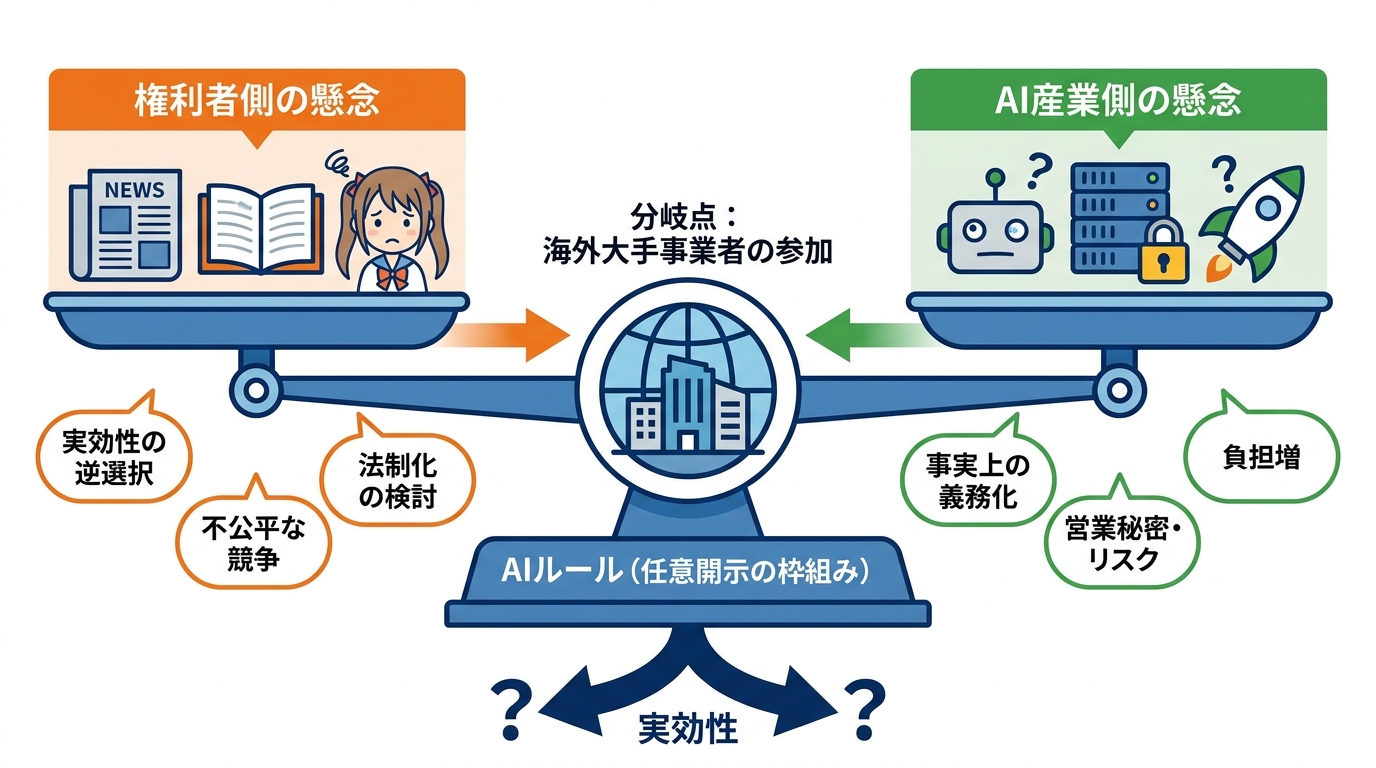
任意開示の枠組みに海外の大手事業者がどこまで応じるかが、本制度の実効性を大きく左右する論点です。ここが、私がこの制度設計に対して最も慎重に見ている部分でもあります。
日本新聞協会はコード案への意見書において、法定ルールではなく強制的な開示や罰則も伴わない点から、事業者が実効性をもって遵守するかは不透明だと懸念を示しました。加えて、文化庁が示したAIと著作権に関する考え方などを遵守していない疑いのあるサービスが海外事業者を中心に見られる現状に触れ、ルールを守る事業者との間で公正な競争が損なわれかねないと指摘しています。そのため同協会は、影響力の大きい海外事業者へ遵守を積極的に働きかけることや、改善が見られない場合には速やかな法制化を検討することを政府に求めました(参照*3)。
関係者の評価は二分しています。まとめられた資料によると、新聞・アニメなどの権利者側は権利行使を助ける透明性の向上を歓迎する一方で、任意規範であるために悪質な事業者ほど参加しない「実効性の逆選択」を懸念しています。これに対してAI産業側は、公開リストや政府の後押しを伴うことで任意規範が事実上の義務へと転化しかねない点や、営業秘密やサイバーセキュリティ上のリスク、スタートアップへの負担増、個別URL照会の技術的実現性、著作権法30条の4との整合性などを問題視しています(参照*14)。
適用の範囲自体は文書に明記されています。読売新聞の報道によれば、対象は文章や画像などを生成するAIのシステム開発者とサービス提供者であり、海外企業であっても日本向けに展開されている場合は等しく適用対象に含まれるとされました。同紙は、米国のグーグルやオープンAIなどを念頭に置いたものだと伝えています(参照*15)。
私の見立てでは、OpenAIやGoogleといった大手が自発的に届出を行い、詳細な説明を公開するかどうかは、日本市場の重要度と政治的プレッシャーの組み合わせで決まります。技術的な性能競争が激化している今、日本の規制対応コストが低ければ応じるインセンティブはありますが、営業秘密の観点から開示に消極的な姿勢を取り続ける可能性も十分あります。罰則なしのソフトローは「外交的に始める」ためには有効ですが、それだけで大手の行動を変えるには力不足です。改善が見られない場合の法制化の道筋を、政府はあらかじめ用意しておく必要があると考えています。
おわりに
プリンシプル・コードは、国が事業者に自発的な対応を促す指針であり、罰則も法的拘束力も持ちません。対照的に、Kagami Gateやキャプテン翼IP側の取組は、権利者が事前に利用条件を定めて活用を管理しようとする民間主導の試みです。主体も性格も異なる2つのアプローチが、奇しくも同時期に始動しました。私は、この「ソフトロー×民間インフラ」の組み合わせ自体は方向性として間違っていないと思っています。ただし、それが機能するかどうかは、海外大手が応じるかどうかと、対価還元の仕組みが実態として動くかどうかにかかっています。
いずれの取り組みも端緒についたばかりです。国による対価還元の枠組みづくりは必要性が叫ばれつつも検討段階にとどまり、十分な仕組みが確立されたとは言えません。それでも、利用条件をあらかじめ明示して確認できる経路が存在することの意義は小さくない。私自身、15年近くコンテンツを発信してきた立場から言えば、「後から文句を言う」より「先に条件を書く」仕組みのほうが、クリエイターにとっても事業者にとっても、はるかに議論のスタート地点として健全です。制度が実効性を持つかどうかは、今後の運用と法制化の動向を継続して見ていく必要があります。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) ITmedia AI+ – 政府、AI事業者向け「知財保護ルール」策定 対象範囲・運用方針は?(1/2 ページ)
- (*2) https://www.cas.go.jp/jp/seisakukaigi/titeki2/ai_kentoukai/kaisai/pdf/ai_principle_code.pdf
- (*3) nazumi-office – 【著作権/AI】AIは何を学んだのか――政府が「学習データの透明性」を求める新たな原則”プリンシプル・コード”を策定
- (*4) ビジネス+IT – AI事業者は学習データ開示、政府が知財保護基本指針案を発表 法的拘束力のないコンプライオアエクスプレイン方式採用|ビジネス+IT
- (*5) 株式会社仁頼 | 横浜のデジタルマーケティング会社。GEO対策(AI検索最適化)・SEO・コンテンツ制作・広告運用・AI導入支援を提供。9,000記事以上の制作実績、70名超のライターネットワーク。 – 生成AIのプリンシプル・コードとは?学習データ開示と罰則なしの理由
- (*6) しんぶん赤旗|日本共産党 – 生成AI規制骨抜き/罰則なし 権利保護置き去り
- (*7) 株式会社NEXYZ.Group(ネクシーズグループ) – AIとIPをつなぐ世界標準インフラ「Kagami Gate(カガミゲート)」
- (*8) PixVerse | Create Amazing AI Videos from Text & Photos with AI Video Generator – Captain Tsubasa x PixVerse: KAGAMI Gate PoC Launches for FIFA World Cup 2026
- (*9) PixVerse | Create Amazing AI Videos from Text & Photos with AI Video Generator – Captain Tsubasa Fans Can Now Bring Their Favorite Football Moments to Life With PixVerse
- (*10) https://www.cas.go.jp/jp/seisakukaigi/titeki2/260612/keikaku_all.pdf
- (*11) https://www.meti.go.jp/shingikai/mono_info_service/entertainment_creative/pdf/20260820_1.pdf
- (*12) https://www.bunka.go.jp/tokei_hakusho_shuppan/tokeichosa/chosakuken/pdf/94193701_01.pdf
- (*13) https://www.bunka.go.jp/tokei_hakusho_shuppan/tokeichosa/chosakuken/pdf/94377001_01.pdf
- (*14) https://yorozuipsc.com/uploads/1/3/2/5/132566344/e80dd9e4651158d3c6ad.pdf
- (*15) 読売新聞 – 読売新聞