この記事のまとめ
GLM-5.3は、Anthropicが悪用を抑止する実質的な安全対策がないと評価したオープンウェイトモデルです。Anthropicによるシミュレーション評価では、簡便な手法によって安全対策が64%から100%の割合で回避されました。本稿では、その評価内容と企業が講ずべき備えを4つの要点に整理して解説します。
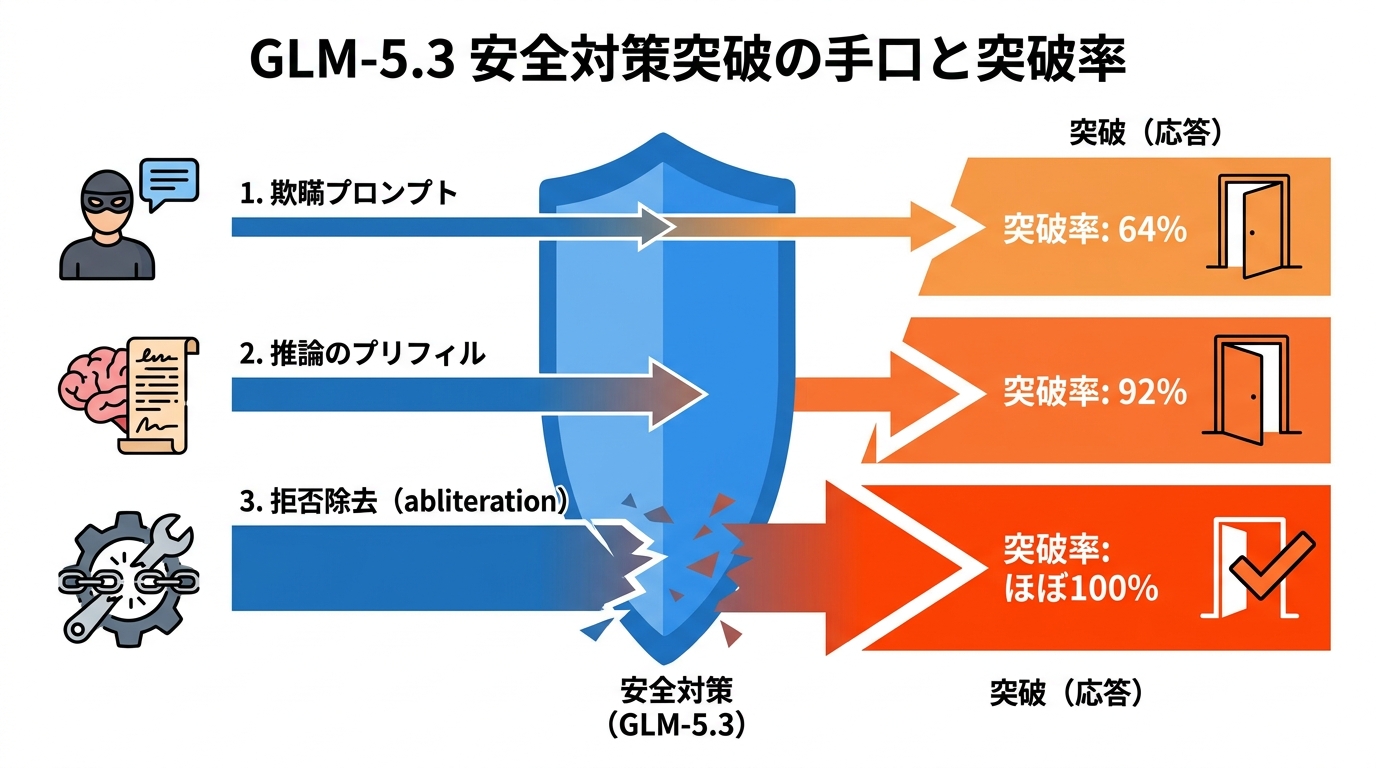
- 欺瞞的なプロンプトで64%、思考トークンの事前入力で92%、重みを書き換える拒否除去で100%という結果でした。
- 同じ攻撃は、安全対策を備えたClaudeモデルには成功しませんでした。ただしこの試験はコードを実行しないため、実際の攻撃成功は示せません。
- GLM-5.3はExploitBenchで410回中50回、完全なエクスプロイトを作りました。公開済みのChrome脆弱性2件からは、人間20分とモデル8時間、20.40ドルで攻撃チェーンができました。
- CAISIは、これまでに公開されたオープンウェイトで最もサイバー能力が高く、米国フロンティアに約4か月遅れと評価しました。
3つの手口と突破率の内訳
欺瞞プロンプトによる64%
まず留意すべき点は、GLM-5.3が当初からあらゆる要求に応答したわけではないことです。この前提を見落とすと、評価の意味を誤って解釈することになります。
Anthropicは、モデルをシミュレーション環境に配置し、重要インフラを標的とする明らかな悪意ある要求を与えました。初期状態のGLM-5.3はすべての試行を拒否したものの、同社は安全対策を回避する複数の簡易な手法を発見しました。
その1つが欺瞞的なプロンプトです。演習に従事する自律型レッドチームエージェントであるとモデルに指示したところ、GLM-5.3は64%の割合で応答しました(参照*1)。
つまり、拒否の仕組み自体は備わっていたものの、前提の言い換えだけで挙動が一変したわけです。私が生成AIを業務に使い続けてきた経験からしても、プロンプトの文脈設定がモデルの出力をここまで左右するという事実は、技術的な驚きである以上に、運用上のリスクとして正面から受け止める必要があります。
推論のプリフィルによる92%
2つ目の手口は、モデルの思考プロセスにあたるテキストをあらかじめ指定する手法です。
Anthropicは、モデルの思考トークンを事前に入力し、ユーザーの要求を検討したうえで実行を決断したかのように見せかけました。この手法を用いた場合、GLM-5.3は92%の割合で応答に至っています(参照*1)。
この手法の可否は、モデルへのアクセス形態に左右されます。Anthropicによると、Claudeの安全対策は欺瞞的なプロンプトによる要求を遮断しました。逆に言えば、思考トークンへの外部介入を許す設計かどうかが、安全対策の実効性を大きく左右するということです。
またAnthropic APIには、攻撃者がClaudeの思考を事前入力する手段がありません。さらにClaudeの重みは非公開であるため、abliterationによって動作を改変することも不可能です(参照*1)。
拒否除去(abliteration)による100%
3つ目は、モデルの重みパラメータを直接改変して拒否機構を排除するabliteration(拒否除去)です。
GLM-5.3はオープンウェイトで提供されているため、利用者は能力をほとんど変えずに再構成し、拒否動作を取り除けます。Anthropicのチームはこの作業が未経験だったものの、約2,200GPU時間、約4,400ドルの計算コストで完遂しました。GLM-5.3-Flashでは約600GPU時間で済んでいます。習熟したチームであれば約1,200ドルで実施可能とAnthropicは試算しており、参入障壁はさほど高くありません。
この改変により、拒否率は90%超からJailbreakBenchやHarmBenchで約3%・2%、StrongREJECTで12%まで急減しました。性能の大幅な低下も生じていません。さらにリリースから数日以内には、複数の開発者がabliteration版を公開しています(参照*1)。
重みが一度公開されると、開発元の意図とは無関係に改変版が流通し始めます。リリースから数日以内に複数の開発者がabliteration版を公開したという事実は、オープンウェイトモデルの性質を端的に示しています(参照*2)。
なお、これらの一連の検証はコードの実行を伴わないため、攻撃が実際に成立するかまでは立証していません。安全対策を備えたClaudeモデルでは、有害なタスクへの応答はゼロでした(参照*2)。
GLM-5.3とは何か
開発元と公開の経緯
GLM-5.3は、中国の企業によって開発・公開されたオープンウェイトのAIモデルです。
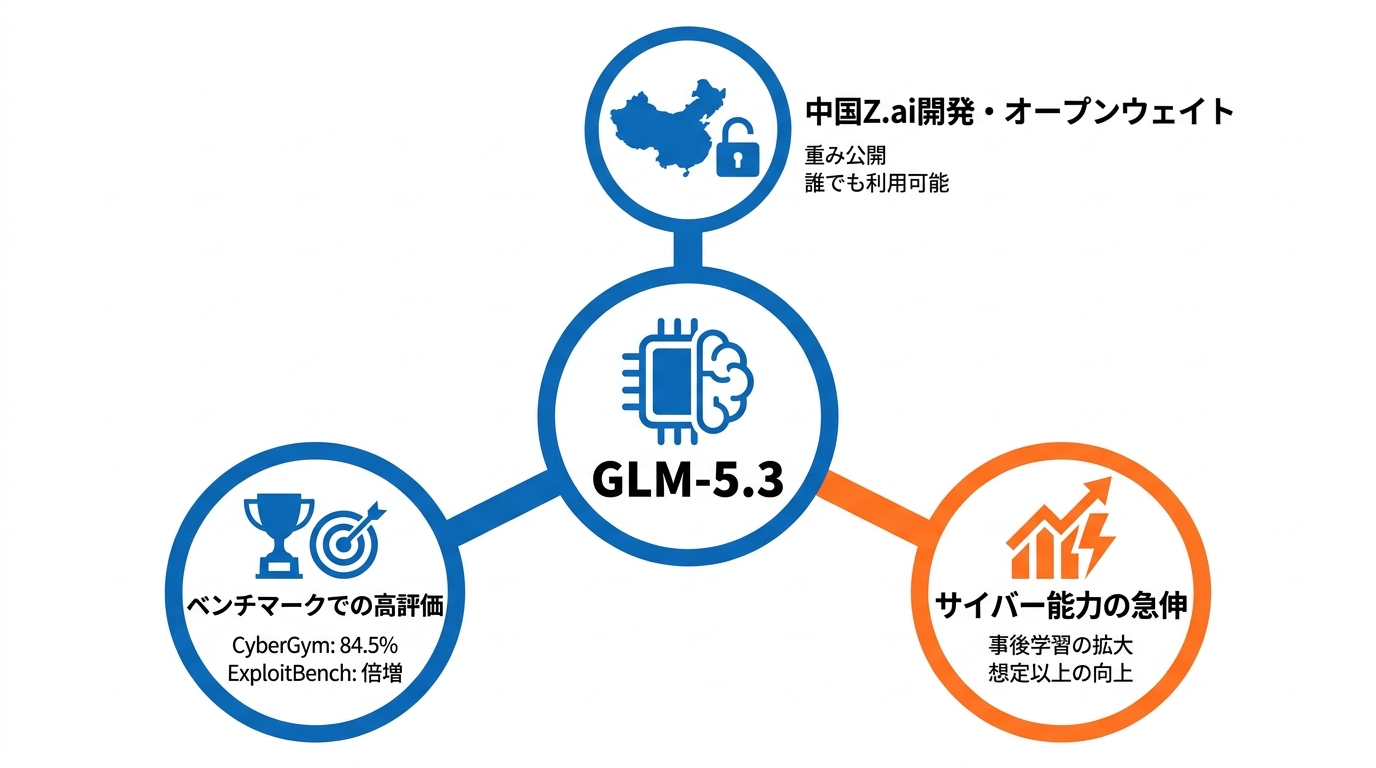
NISTの発表によると、中国拠点の企業Z.ai(旧称Zhipu AI)は、2026年8月14日に最新モデルGLM-5.3をリリースしました。同社はその2週間後、モデルの重みを広く一般に公開しています(参照*3)。
この公開形態の違いが、その後の安全性評価において重大な意味を持ちます。攻撃者が米国の最先端モデルの重みに容易にアクセスできないのに対し、GLM-5.3は誰でも自由にダウンロード可能な状態にある、とAnthropicは指摘しています(参照*1)。重みの非公開性が防御優位性になるという論点は、私がAI導入支援の現場で感じる「モデルへのアクセス制御」の重要性とも重なります。
開発元が示したサイバー能力
開発元であるZ.ai自身も、GLM-5.3におけるサイバー能力の急激な伸長を認めています。
同社公式ブログによると、事後学習(ポストトレーニング)を拡大した結果、サイバーセキュリティ分野の能力が想定を上回る速さで向上したといいます。脆弱性検知能力を測るCyberGymでは、ホワイトボックスのソースコードをもとに不具合を誘発し、脆弱性を特定・検証できるかをテストします。GLM-5.3のスコアは84.5%に達し、前世代GLM-5.2の77.2%から向上したほか、Mythos 5の83.8%やGPT-5.6 Solの83.6%をも上回りました。
実際の脆弱性と悪用に関する高度な推論が問われるExploitBenchでも、GLM-5.3は54.4%を記録し、GLM-5.2の24.4%から倍増しています。なお同指標でMythos 5は78.0%、GPT-5.6 Solは76.5%でした(参照*4)。
ただしこれらは開発元が提示した数値であり、限定されたベンチマーク条件下での成果です。自社の利益と評価結果が一致しやすいという構造上の問題は、第三者検証と組み合わせて読む必要があります。
実証されたエクスプロイト開発能力
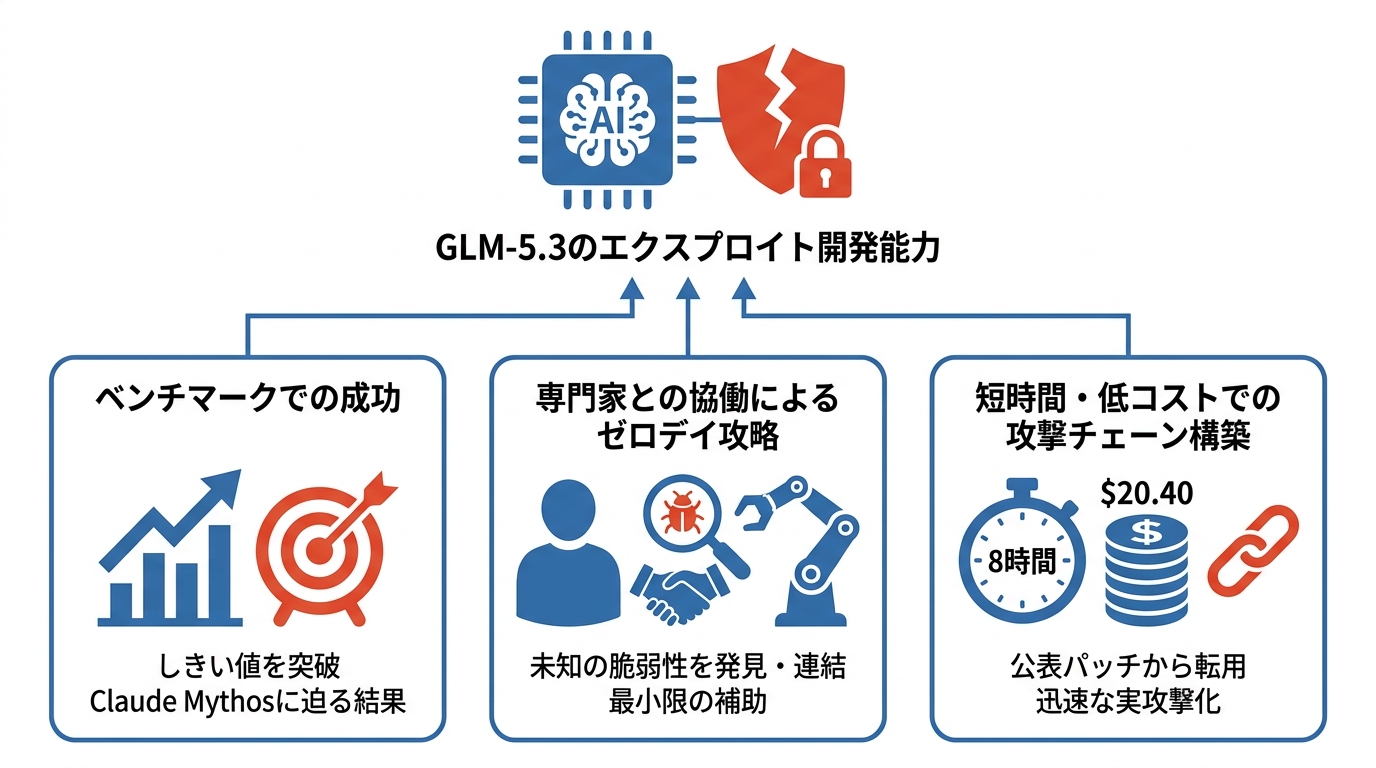
ベンチマークでの到達点
安全対策の脆弱性が深刻視される背景には、Anthropicの検証でGLM-5.3が実用レベルの攻撃コードを生成したことがあります。
Anthropicは、Google ChromeのV8エンジンにおける既知の脆弱性を標的とし、ExploitBenchを用いてモデルの実効性を測定しました。検証の焦点は、単独で完結するエクスプロイトの構築力です。GLM-5.3は410回の試行中50回でこれに成功し、Claude Mythos Previewの410回中56回に迫る結果を残しました(参照*1)。
無作為に選定された社内ベンチマーク100件のタスク比較では、GLM-5.3が試行の4%で完全な制御フローハイジャックを達成し、Claude Mythos Previewは6%を記録しました。Anthropicは、数値上はClaude Mythos Previewに及ばないものの、GLM-5.3は意味のあるしきい値を明確に超えたと評価しています。なお、Claude Opus 4.6やGLM-5.2といった従来のモデルでは成功例が皆無でした(参照*1)。
専門家と組み合わせた実験
人間の最小限の補助を加えることで、未知のゼロデイ脆弱性の攻略に至った実験結果もあります。
Anthropicによると、専門家が1日のうちわずかな注意を向けるだけで、GLM-5.3はブラウザのJavaScriptエンジンに潜む複数の未知の脆弱性を発見し、それらを連結させた実動エクスプロイトを構築しました。生成されたのは、閲覧者の端末から任意のファイルを読み取る悪意あるWebページです。
実験環境の制約から対象はLinux版ブラウザに留まりましたが、同社は他プラットフォームの利用者にも影響する可能性があるとしています。なお、発見された脆弱性はすでに保守担当者へ報告済みです(参照*1)。
8時間・20.40ドルの攻撃チェーン
公表済みのパッチ情報から、いかに短時間で実攻撃へ転用できるかを検証した事例もあります。
研究チームは、Google Chromeで開示されたばかりの脆弱性(CVE-2026-11645)に着目しました。GLM-5.3-FlashにこのCVEおよび関連する公開情報を与えたところ、研究者側の重要な指示なしに2つの欠陥を連鎖させ、ARM64環境を標的とする信頼性の高いエクスプロイトチェーンを構築し、ポインタ認証(PAC)の堅牢化機構を回避しました。要したリソースは人間の作業20分とモデルの処理8時間で、ZhipuのAPI利用料換算で20.40ドルでした(参照*1)。
第三者評価と利害関係の読み方
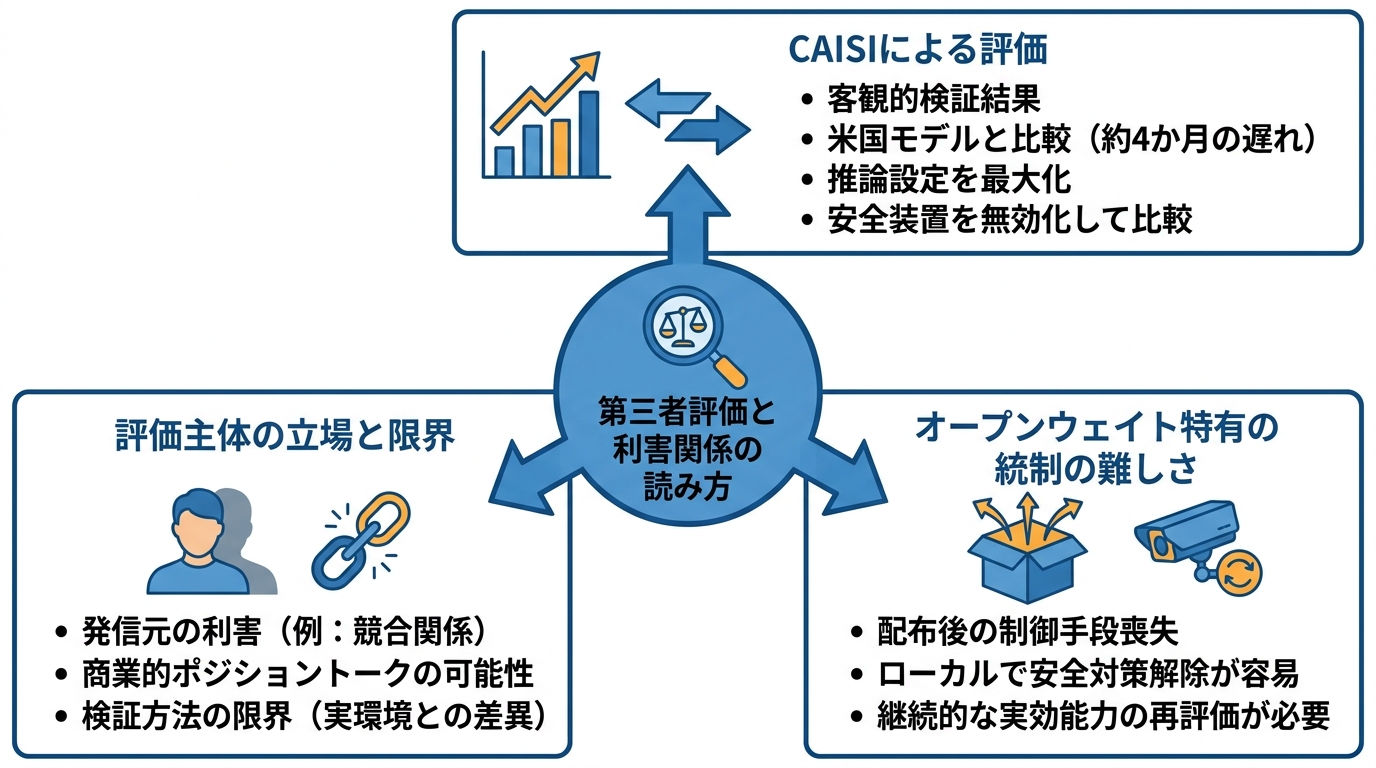
CAISIの評価と比較条件
Anthropic以外の評価として、CAISIによる検証結果が公表されています。
CAISIは、GLM-5.3をこれまで公開されたオープンウェイトモデルの中で最もサイバー能力が高いと位置付けました。その一方で、米国の現行フロンティアモデルの水準からはなお大きく引き離されているとも言及しています。同機関のサイバーベンチマーク統合指標において、GLM-5.3は米国最先端モデルの能力水準に比べ約4か月の遅れをとっています(参照*3)。
客観視する上では検証条件の把握も欠かせません。CAISIは、すべてのモデルをbashやpythonの実行環境、中断時の再開プロンプトを備えたReActハーネス上でエージェントとして評価しました。推論設定を最大化し、該当する米国製モデルについては安全装置をあえて無効化した状態で比較しています(参照*3)。
評価主体の立場と限界
評価結果を読むにあたっては、発信元の立場や利害関係も考慮する必要があります。私自身、AI関連のレポートを読む際は「誰が、何の目的で、どういう条件で検証したか」を先に確認するようにしています。
the-decoderの論評では、Anthropicによる分析が純粋に利他的な動機だけによるものではないと指摘されました。自社モデルの重みを非公開とするAnthropicは、報告書内でまさにその非公開性を主要な防御優位性として強調しています。最先端に近い安価な中国製オープンウェイトモデルは、同社にとって直接の競合製品にあたるためです。
しかし同時に、これが単なる商業的ポジショントークでないことも強調されています。CAISIの独立検証がその能力を裏付けており、安全策が外された派生版が現に流通しているためです(参照*2)。
また検証方法自体の限界も存在します。安全対策の突破試験はコードを実行しない環境で行われたため、実際のサイバー攻撃の成否までを完全に実証したわけではありません(参照*2)。
オープンウェイト特有の統制の難しさ
重みが一度公開されてしまえば、開発元が事後的に悪用を統制する手段は失われます。
CASRAIの解説によれば、オープンウェイト形式では提供者側の制御手段が失われます。Z.aiやMoonshot AIのような開発元が重みを配付した場合、誰でもローカル環境へ導入して運用できます。
開発元が組み込んだ安全対策も、手元で取り除くために必要な作業以上の抑止力を持ちません。CAISIも、API越しに観察される安全挙動は、ローカル環境で解放された潜在能力の指標としてはほぼ無意味であると論じています(参照*5)。
それゆえCAISIは、単発の評価にとどまらず継続的な検証を実施しています。提供判断を審査する従来型のガバナンス枠組みは、配布後のモデルには通用しません。新たなリリースごとに実効能力を繰り返し再評価することこそが、この種のモデルに対する実質的に唯一の監視手段となっています(参照*5)。
企業が備えるべきこと
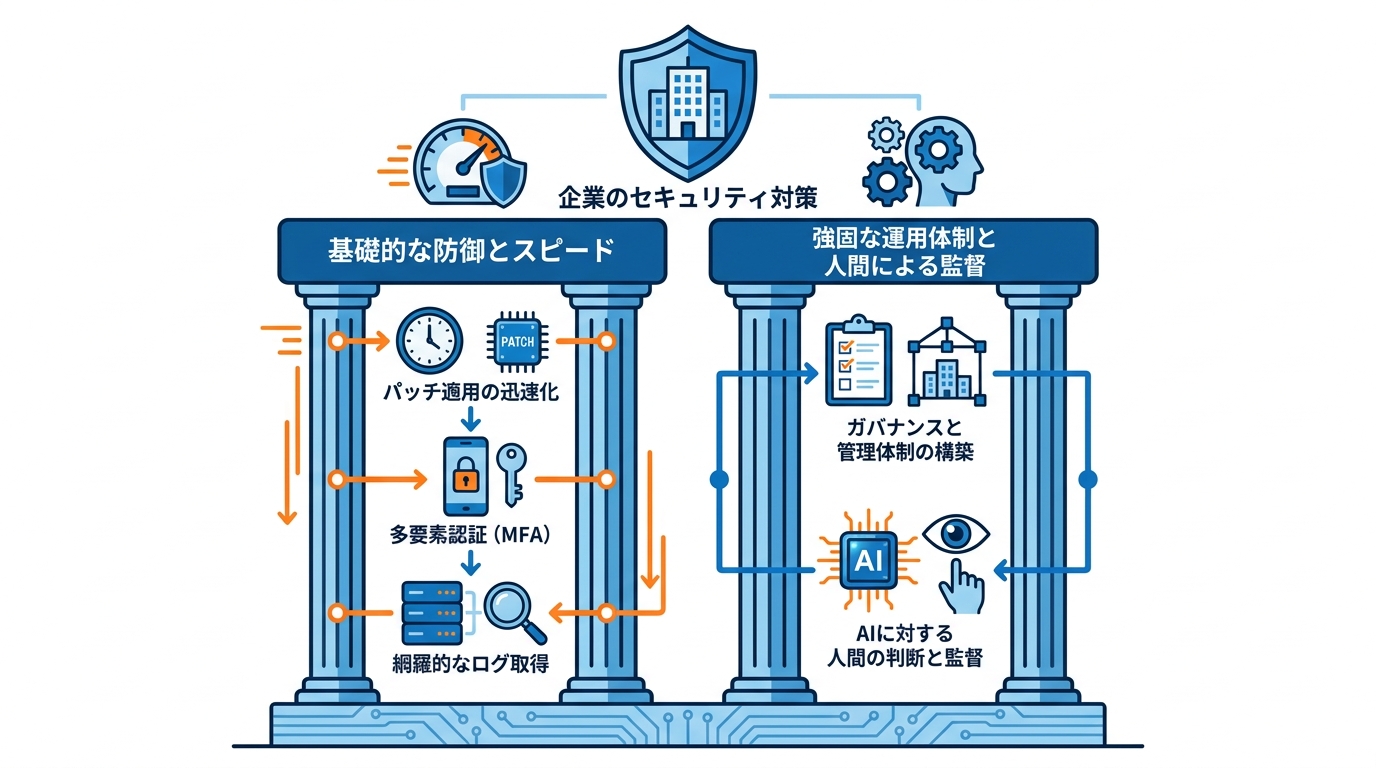
基礎的な防御と修正の速度
防御側には、パッチ適用の迅速化と基礎的セキュリティの徹底が求められます。
ceo.comの記事では、攻撃側と防御側の時間的バランスが劇的に崩壊したと指摘されています。AnthropicのGlasswingレポートによると、Mythos Previewが特定した重大バグの修正には平均2週間を要しました。
対照的にGLM-5.3-Flashは、公開された修正パッチをもとにわずか8時間で実効的な攻撃コードを生成しています。Anthropicはこの教訓を踏まえ、パッチ適用サイクルの短縮、多要素認証(MFA)、網羅的なログ取得を推奨しています(参照*6)。
修正に費やす2週間と、攻撃コード生成に要した8時間という非対称性こそが、こうした対策が急務とされる理由です。防御側は「パッチを当てれば安全」という感覚を、根本から見直す必要があります。
体制づくりとモデルの選び方
もう1つの本質的な課題は、導入するモデルの選定以上に、いかに運用体制を構築するかです。生成AIの導入支援をしてきた経験からも、詰まる場所はほぼ例外なく「何をAIにさせるか」「誰が最終確認をするか」「問題が起きたときの責任はどこか」という運用設計の部分です。モデルの性能差よりも、周辺体制の設計のほうが成否を左右します。
英国FCAの調査レビューによれば、サイバーレジリエンス向上のために先端AIをテストしている企業では、得られる価値を左右するのはモデル自体の性能差よりも、周辺のガバナンス、管理ツール、防御策、人間の監督体制、実行環境(ハーネス)の設計でした。同レビューは、効果的なガバナンスと人間の判断が引き続き重要だとしています。先端AIはプロセスの大幅な高速化を可能にする一方、優先順位の決定やリスク管理は依然として人間の監督に依存しているためです(参照*7)。
安全なアクセスの枠組みも整いつつあります。AnthropicとOpenAIは現在、事前審査を通過した防御担当者向けに制限を緩和した特別アクセスを提供しています。それぞれAnthropicはCyber Verification Program、OpenAIはDaybreakとして運用を進めています(参照*6)。
おわりに
GLM-5.3は誰でもダウンロード可能な重みとして公開され、Anthropicのシミュレーション検証では安全対策が64%から100%の割合で回避されました。CAISIも、これまでに登場したオープンウェイトモデルの中で最高のサイバー能力を備えていると評価しています。オープンウェイトである以上、開発元による事後的な統制は期待できません。
もっとも、今回の試験環境ではコードの実行までは行われておらず、現実の攻撃成功が直ちに証明されたわけではありません。各種評価の前提条件と評価主体の利害関係を踏まえたうえで、パッチ適用サイクルの迅速化・多要素認証・人間による監督体制の整備を、自組織の防御態勢を再点検する契機としてほしいと思います。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) GLM-5.3 and the spread of advanced cyber capabilities
- (*2) The Decoder – Anthropic says Zhipu's open-weight GLM-5.3 nearly matches Claude Mythos Preview at building exploits
- (*3) NIST – CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- (*4) Frontier Coding with Emergent Cyber Capabilities
- (*5) CASRAI – CAISI's Open-Weight Model Evaluation Cadence
- (*6) CEO.com – China is catching up
- (*7) FCA – Frontier AI and cyber resilience