この記事のまとめ
EmbeddingGemma 2は、テキストやコード、画像、動画、音声を同一の768次元ベクトル空間で扱う埋め込みモデルです。パラメータ数は7億4,000万で、一般的なGPUやCPU環境でもローカルかつオフラインで動作します。本記事では、実現できる機能と仕様、業務での活用シーン、検索拡張生成(RAG)への効果という3つの観点から整理します。
- 画像のキャプション生成や音声の文字起こしを介さずに、テキストの検索語から画像や音声を直接比較できます。
- 必要なエンコーダーのみを読み込む設計により、Pixel 11 Proではテキスト専用の重みで約191MB、全体でも567MBのアクティブRAMで動作すると報告されています。
- 次元を768から128へ削減すると保存容量は6分の1に抑えられますが、画像・動画・音声の検索精度は約75%まで低下するため、導入前の事前検証が欠かせません。
4モダリティ統合で何ができるか
統一ベクトル空間の意味
「統合」とは、異なる種類のデータを単一の物差しの上に揃えて配置することを指します。私がこれを重要だと思うのは、これまでのマルチモーダル処理の複雑さを根本から変えるアプローチだからです。
埋め込みとは、文章や画像などの内容を数値の並びへと変換する処理です。変換後の数値同士の距離を測定することで、意味の近い情報を検索できます。これがベクトル検索の基盤技術です。
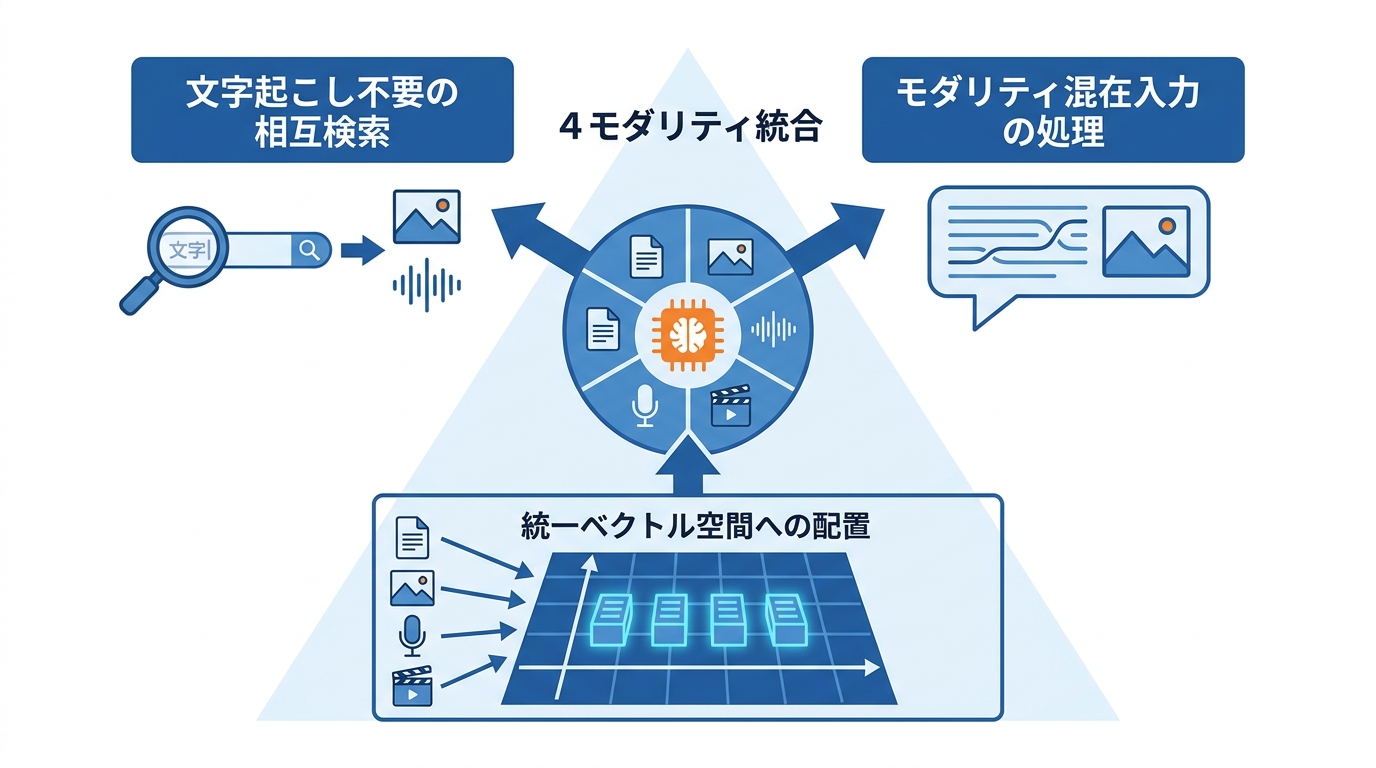
EmbeddingGemma 2は、テキスト、画像、音声、動画を共通の768次元ベクトル空間へ変換します。パラメータ数は7億4,000万で、Gemma 4のデコーダーアーキテクチャを基盤としています。マルチモーダルRAG、セマンティック検索、ゼロショット分類といった高負荷なクロスモーダル処理を、一般的なGPUやCPU上でローカルかつオフラインで実行可能です(参照*1)。
EmbeddingGemma 2は、複数のモデルを連結する方式に代わり、共通の768次元空間に写像するモジュール式エンコーダーを採用しています。各モダリティは専用エンコーダーで処理されますが、すべての入力が共通のバックボーンを通過するため、生成された埋め込みは同一の次元空間上に整列します(参照*2)。
従来のマルチモーダルシステムは、「画像認識モデルで説明文を生成し、その文章をテキスト埋め込みモデルに渡す」という複数モデルの連結が前提でした。連結が増えるほど遅延は積み重なり、エラーの原因も分散します。EmbeddingGemma 2がこの構造を一本化したことは、技術的な性能向上だけでなく、実務上の導入コストを下げるという点でも意味が大きいと私は考えています。
文字起こし不要の横断検索
すべてのデータが同一空間に配置されるため、中間の変換処理を挟むことなく相互に比較できます。
EmbeddingGemma 2は、多様なコンテンツを「埋め込み」と呼ばれる数値表現へと変換します。これらは同じ空間にマッピングされるため、アプリケーションはテキストの検索クエリと画像や音声クリップの類似度を直接比較可能です。Googleによれば、この手法により、画像キャプション生成、音声テキスト変換、テキスト埋め込みの各モデルを連結する構成で生じていた遅延やメモリ負荷を大幅に軽減できます(参照*3)。
ローカル検索やメディア検索機能を開発する際も、3つのモデルを連携させる必要がないため、レイテンシとメモリ消費を低く抑えられます。端末上での実行とプライバシー保護を重視するアプリ向けに設計されており、テキスト、画像、音声に対応しながらもパラメータ数は7億4,000万にとどまります(参照*4)。
モダリティ混在入力の扱い
1つの入力の中に、文章と画像や音声をまとめて含められます。
単一の入力において、共有された8,192トークンのコンテキスト内で、テキスト、画像、動画、音声を混在させて処理できます。各メディアの挿入位置は、モデルの語彙に含まれるプレースホルダートークンによってテキスト中に指定します。画像の配置場所は`<|image|>`、動画は`<|video|>`、音声は`<|audio|>`で表します(参照*5)。
テキスト内の各プレースホルダーには、対応するキーのデータが順番に割り当てられます。この処理呼び出しによって、テキスト、画像、動画を統合した単一の埋め込みベクトルが返されます。生成された埋め込みは、「トレイルランニング用の防水シューズ」といったテキストのみのクエリなど、他のEmbeddingGemma 2の埋め込みと直接比較できます(参照*5)。
モデルの仕組みと主な仕様
モジュール式エンコーダーと必要メモリ
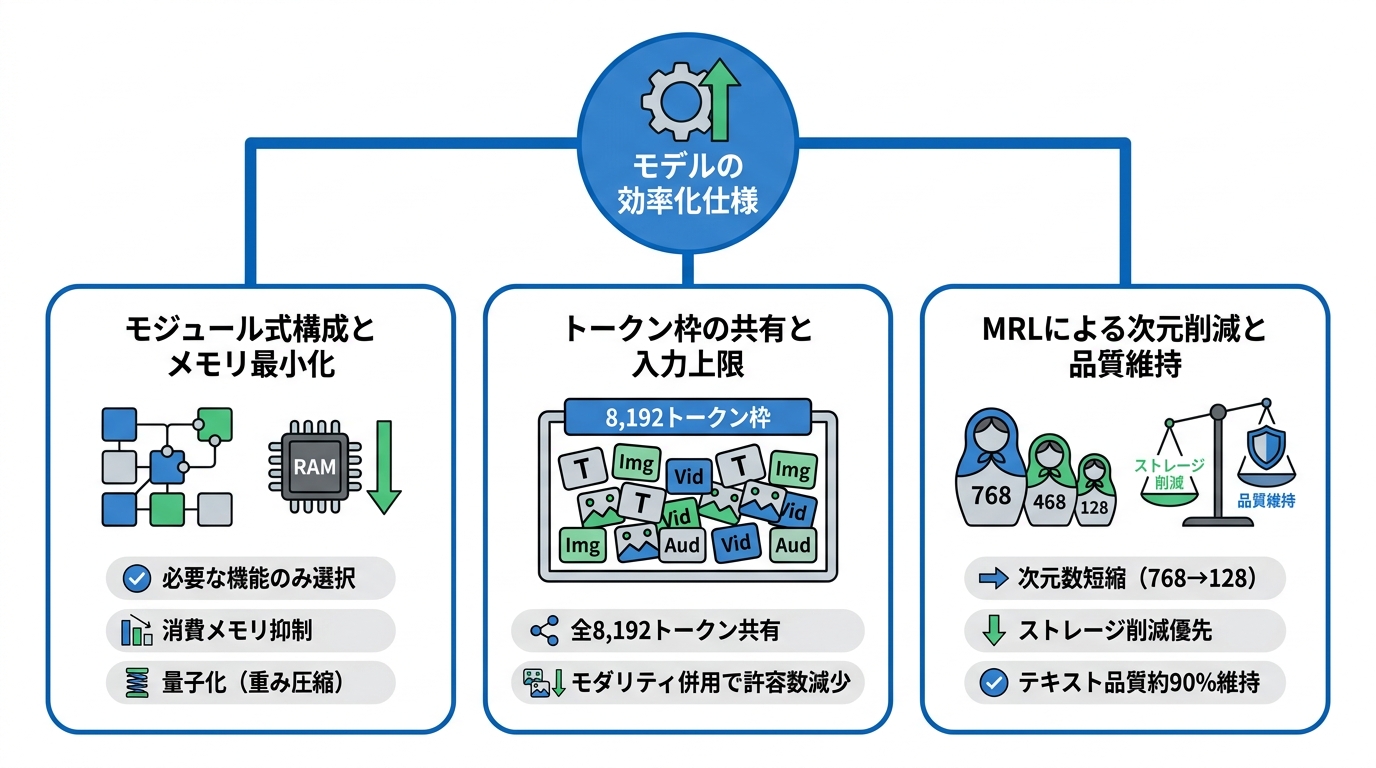
使用する機能だけを選択して読み込めるため、消費メモリを最小限に抑えられます。
実行時には、用途に応じて必要なエンコーダーだけを読み込み可能です。構成は、テキスト・コード向けの2億7,000万、テキスト・画像向けの4億4,000万、テキスト・音声向けの5億7,000万、全モダリティ向けの7億4,000万パラメータという4種類が用意されています。いずれの構成も、互換性を持つ同一のベクトル空間へと写像されます(参照*2)。
Googleの報告によると、Pixel 11 ProにおけるアクティブRAM使用量は、量子化されたテキスト専用の重みで約191MB、マルチモーダルモデル全体でも567MBです。量子化とはモデルの重みを圧縮する処理を指します。ただしこれらはGoogleが特定端末で測定した値であり、すべてのスマートフォンで同一の消費量になることを保証するものではありません(参照*3)。
コンテキスト長と入力の上限
入力可能なデータ量は、全体で共有される8,192トークンの枠によって決まります。
モダリティごとのトークン消費量と最大入力数は、モデルカードに明記されています。テキストはサブワードあたり1トークンを消費し、上限は最大8,192トークンです。
画像はデフォルトで1枚あたり280トークン、最大で約29枚まで入力できます。動画は1フレームあたり140トークンで約58フレーム、音声は1秒あたり25トークンで約327秒に達します(参照*6)。
これらの最大値は、テキストを併用せず単一のモダリティのみを投入した場合の数値です。混在入力では共通のトークン枠を分け合う仕様のため、複数のモダリティを組み合わせると、それぞれの許容入力数は減少します(参照*6)。
MRLによる次元の切り詰め
ストレージ容量を優先したい場合は、Matryoshka Representation Learning(MRL)により埋め込みの次元数を短縮する運用を選択できます。
出力次元は768、512、256、128から指定可能です。圧縮率は768次元を1:1とすると、512次元で1:1.5、256次元で1:3、128次元では1:6となります。
大規模テキスト埋め込みベンチマーク(MTEB、多言語、v2)の平均スコアは768次元で61.36、512次元で61.17、256次元で60.41、128次元で57.89でした。一方、大規模マルチモーダル埋め込みベンチマーク(MMEB、v2)の総合スコアは768次元の59.01に対し、128次元では45.65となっています(参照*7)。
128次元はストレージ使用量を6分の1に削減できるため、大規模なテキスト専用インデックスの構築や、再ランキング前の候補絞り込みに適しています。テキストやコードでは約90%の品質を保ちますが、画像、動画、音声の検索品質は約75%まで低下します。マルチモーダル検索で128次元を採用する際は、事前に実際のデータを用いた検証が必要です(参照*2)。
次元を切り詰めた後は、再正規化を行わなければなりません。単位長ベクトルをスライスしても単位長は維持されないため、短縮後のベクトルはコサイン類似度の算出前にL2正規化を施します。
この手順を怠ると、エラーは発生せず一見正常なスコアが返るものの、ランキングの精度が知らぬ間に低下します。さらに、クエリと文書の次元数は一致している必要があり、768次元のクエリを128次元のコーパスと照合することはできません(参照*5)。
ビジネスでの活用シーン
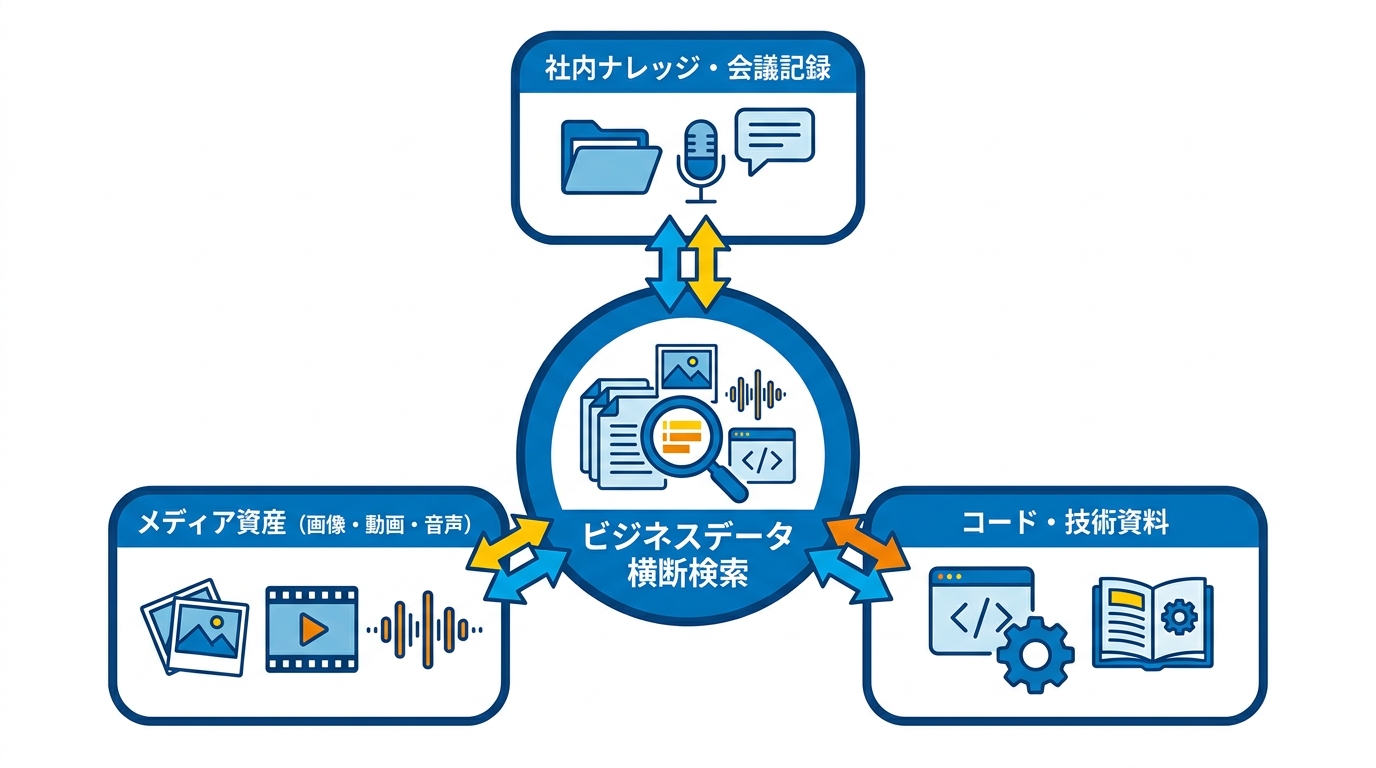
社内ナレッジと会議記録の検索
社内に蓄積された文書資料や会議ログを、自然な言葉で横断検索する用途が想定されています。企業のコンテンツ資産がテキストだけで完結していないことを考えると、この用途は実務上の需要と合致しています。
モデルカードには、主要な想定用途として検索処理が挙げられています。テキスト、コード、画像、動画、音声を対象とするセマンティック検索用埋め込みであり、文書検索、企業ナレッジベースを活用したRAG、自然言語クエリによるコード検索、音声アーカイブに対する音声クエリ検索などを網羅します(参照*6)。
GoogleはMac向けにGoogle AI Edge Foresightの提供を開始しました。これは文脈を理解する会議アシスタントを端末上で直接実行する実験的アプリケーションです。AI処理を完全にローカルで実施し、会話の文字起こしや個人ファイルのメモ作成、インデックス化、検索を支援します。
システムのオーディオやマイク入力に直結するため、完全オフライン環境を含め、あらゆる会議ツールで即座に機能します。自然言語で画像、ドキュメント、文字起こし、メモを横断検索できるうえ、機密データを端末内に保持でき、回線状況に左右されずクラウド利用料も発生しません(参照*4)。
私自身、会議の議事録や録音データを後から検索する作業の非効率さを長年感じてきました。「あの会議でどんな判断をしたか」を探すために、文字起こしを読み返したり、録音を早送りしたりする時間は、積み重なると相当なコストになります。EmbeddingGemma 2のようなオンデバイス・マルチモーダル検索が実用化されれば、こうした検索の手間は大幅に削減できるはずです。ただし、便利さと導入のしやすさは別の話です。実際に業務へ定着させるには、インデックス設計や更新運用の仕組みを別途整える必要があります。
写真・動画・音声資産の検索
端末内に蓄積されたメディア資産を、説明文を入力して素早く見つけ出すアプローチです。
「Instant Media Search」というデモでは、自然言語やサンプル画像を用いて端末内メディアから特定の写真や動画を検索できます。入力されたクエリとメディア資産をオンデバイスで埋め込みベクトルに変換し、メディア側のベクトルはローカルのSQLiteデータベースへ保存します。
そのうえでコサイン類似度が最も高い対象を返却します。文字入力中にもリアルタイムで反応する、インタラクティブな検索インターフェースを実現しています(参照*4)。
動画検索では、ユーザーがホームビデオやスポーツ映像などを指定すると、オンデバイスエンジンが音声チャンクとともに映像をインデックス化し、埋め込みを生成します。「子どもが笑っている」「犬がフリスビーをキャッチしている」といった具体的な文言を入力すれば、エンジンがプロンプトの埋め込みを算出して動画フレームの埋め込みと照合します。一致する場面の正確なタイムスタンプが即座に提示されます(参照*4)。
コード検索と分類・意思決定
ソフトウェア開発におけるコード検索や、入力内容のルーティング処理にも応用できます。コードベースが大きくなるほど、「あの処理がどこに書いてあるか」を探す時間は膨大になります。セマンティックなコード検索はその問題に直接効きます。
ソースコードはテキストと同様、2億7,000万パラメータのベースモデルによって処理されます。Googleによれば、EmbeddingGemma 2のMTEB Codeスコアは78.68に達し、初代EmbeddingGemmaの68.76から向上しました(参照*8)。
コード検索や技術資料の探索においてEmbeddingGemma 1を大きく上回る性能を発揮するため、ローカルリポジトリのインデックス化やAIエージェントによるコード検索に適しています(参照*2)。
EmbeddingGemma 2は、極めて低遅延なオンデバイス意思決定エンジンとしても機能します。学習データやファインチューニングを必要とせず、ユーザーの入力を分類ラベルや説明文と直接照合することで、わずか数ミリ秒でゼロショットの意図ルーティングを実行します(参照*4)。
Googleが提示した検証例では、チェスのターンごとに500通りの選択肢を評価するMediaPipe Decision Taskが100ミリ秒未満で完了しました(参照*9)。
RAGとオフライン検索の広がり
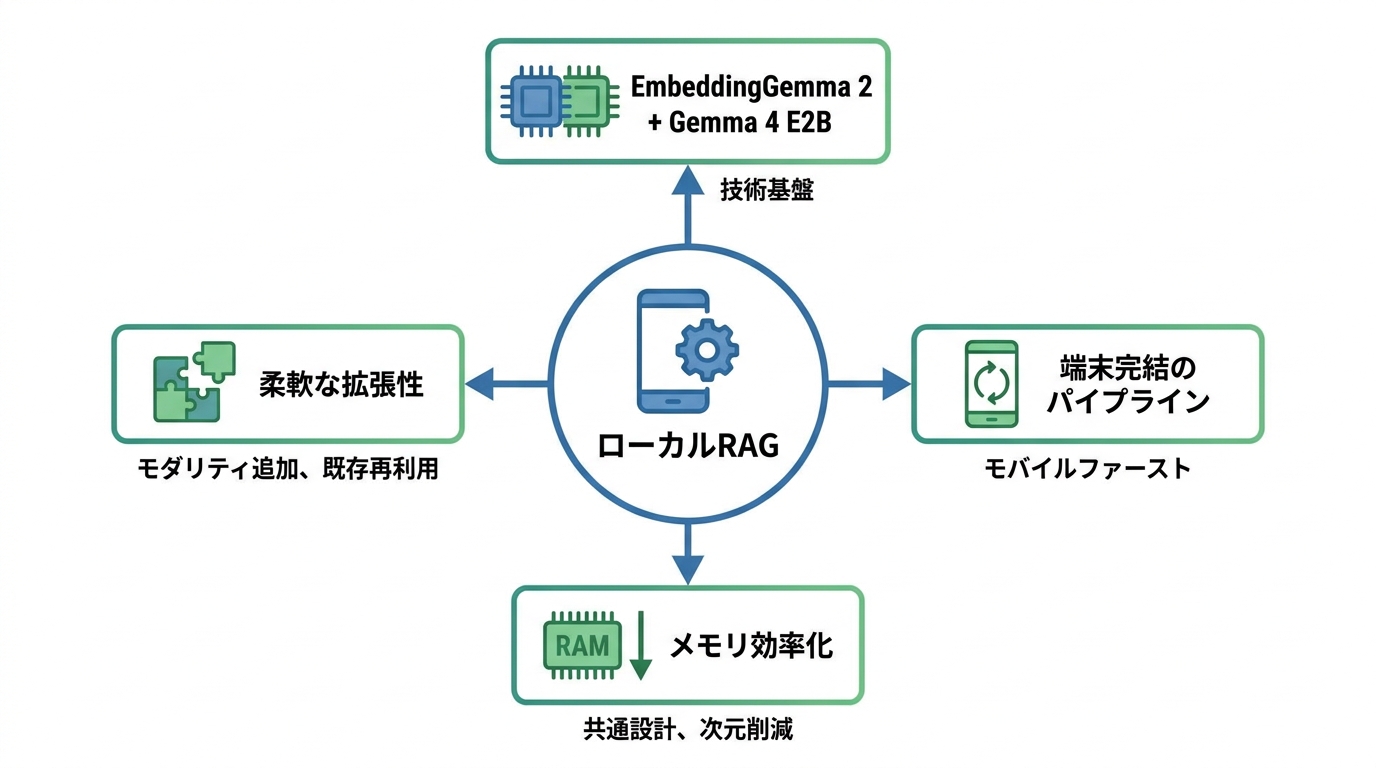
ローカルで動くマルチモーダルRAG
生成モデルと組み合わせることで、端末ローカルで完結するRAGシステムを構築できます。クラウドに依存しないRAGは、機密情報を扱う企業や、通信環境が安定しない現場での利用において実質的な選択肢になり得ます。
EmbeddingGemma 2をGemma 4 E2Bと組み合わせれば、文脈に応じたモバイルファーストなRAGパイプラインや対話型ボットを構築可能です(参照*1)。
本モデルはGemma 4のテキストトークナイザーと音声エンコーダーの設計を継承しているため、両モデルを端末上で同時に動かす際もメモリ消費を少なく抑えられます。現時点でGoogleは自社製フラッグシップ機での動作確認を公表した段階であり、大規模なインデックスや他社製端末、多様な実務アプリにおける挙動は今後の検証課題とされています(参照*8)。
ここで重要なのは、「ローカルで動く」という特性が単なるコスト削減にとどまらない点です。生成AIの業務導入で最初に問われるのは、情報漏洩リスクとデータの管理範囲です。クラウド型のAPIを使う場合、どのデータが外部に送られるかを法務・コンプライアンス部門に説明する手間が必ずかかります。オンデバイスで完結するモデルは、その説明コストを大きく下げます。ただし、Googleが動作確認を公表したのは現時点では自社製フラッグシップ機に限られている点は念頭に置く必要があります。
非対称検索やRAGのパイプラインでは、クエリが短い質問文であるのに対し、ドキュメントは長文で構成されます。インデックスの照合精度を高めるため、テキストには専用のプレフィックスプロンプトを付与します。検索クエリ側には`prompt_name="Retrieval-query"`を指定して`"task: search result | query: "`を適用し、文書側には`prompt_name="Retrieval-document"`で`"title: none | text: "`を付加します。文書のタイトルを含めたカスタムの`prompt`文字列を渡すことも可能で、タイトルを明示すると検索精度が一段と向上します(参照*10)。
インデックス拡張とストレージ運用
モダリティを後から追加できる柔軟性を備えており、スモールスタートに適した構造です。「まずテキストだけ試して、必要になったら画像や音声を追加する」という段階的な導入が可能な点は、実務的に重要です。
テキストのみのインデックスから運用を開始し、後から画像や音声の埋め込みを追加する場合でも、対象のエンコーダーを有効化してモデルを再ロードするだけで対応できます。すでに算出した既存の埋め込みデータを再計算する必要はありません(参照*2)。
保存容量もベクトルの次元数で柔軟にコントロールできます。bfloat16精度の場合、768次元ベクトルを100万件保存するには約1.5GBのメモリが必要ですが、128次元へ削減すれば250MBに抑えられます。この6倍の圧縮効率により、同一メモリ容量に6倍のデータを保持できるようになり、大規模インデックスのオンデバイス展開が容易になります(参照*2)。
256次元を選択した場合、100万件のインデックス容量は約500MBに収まります。Googleの発表によれば、短縮した埋め込みはテキストやコードにおいて元のサイズに近い精度を維持し、画像・動画・音声の検索でも約95%の性能を保ちます(参照*8)。
導入手段と注意点
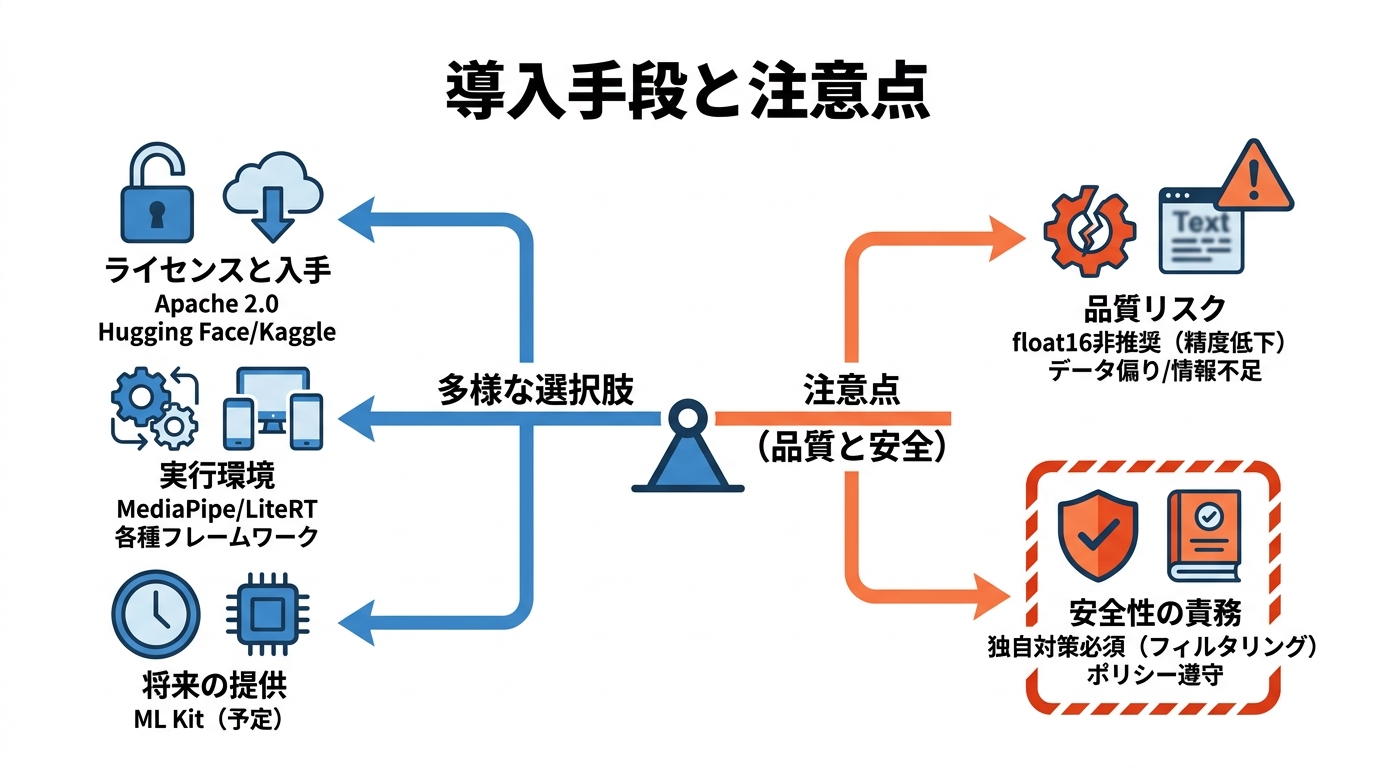
ライセンスと実行環境の選択肢
入手方法と実行環境の両面で、多様な選択肢が提供されています。
本モデルは7億4,000万パラメータで構成され、Gemma 4を基盤としています。商用利用が認められた寛容なApache 2.0ライセンスで公開されており、モデルの重みはHugging FaceやKaggleからダウンロード可能です。Googleの開発者向けガイドでは2つの統合手法が紹介されています。
定型処理を手早く扱いたい開発者向けのMediaPipe Tasksは前処理とローカル検索を担い、LiteRTはカスタムアプリ向けに細かな実行制御やハードウェアアクセラレーションを提供します。加えてTransformers、llama.cpp、Ollama、MLXといった普及している各種推論フレームワークにも対応しています(参照*3)。
マネージドサービスでの利用を検討しているAndroidエンジニアは、少し待つ必要があります。Googleは今後数週間以内にML Kit経由での提供を予定しています。
これによりモデルの自動更新や、対応端末におけるNPU(ニューラル・プロセッシング・ユニット)による処理加速が利用可能になります。この公式統合は、現時点で配布されている重みファイルや開発ツールとは独立した形で展開されます(参照*3)。
品質と安全性の制限
設定や利用法を誤ると、エラーなしに検索精度が低下する可能性があります。この「エラーが出ない」という点が、実務上もっとも注意が必要なポイントです。
モデル推論時にはbfloat16またはfloat32の利用が推奨され、float16の使用は避けるべきとされています。EmbeddingGemma 2内部の活性化値がfloat16の表現可能範囲を超過するためです。
float16を用いた場合、明確なエラーを吐かずにNaNが出現したり品質の劣る埋め込みが生成されたりするため、不具合に気付きにくくなります。また、テキスト処理において推奨されるタスク接頭辞を省略すると、埋め込み精度が損なわれる原因になります(参照*6)。
私がAIの導入支援で繰り返し見てきたパターンが、まさにこれです。出力が「それらしく見える」ために問題に気づかず、本番環境に出てから初めて品質の低さが露呈する。EmbeddingGemma 2の場合、float16の使用やタスク接頭辞の省略がその典型的な落とし穴になります。導入前に、意図的に誤った設定を試して品質差を確認しておくことをお勧めします。
トレーニングデータの品質と多様性は、モデルの性能上限に直結します。学習データの偏りや情報不足によって、出力精度に制約が生じる場合があります。たとえばEmbeddingGemma 2は100以上の言語をサポートしていますが、言語ごとの性能水準が一律とは限りません。
開発者およびシステム導入者は、本番システムの用途に応じて検索結果のフィルタリングや公平性テストといった安全対策を独自に実装する責務を負います。導入にあたってはGemma禁止利用ポリシーの遵守が必須です(参照*6)。
おわりに
EmbeddingGemma 2は、テキスト、コード、画像、動画、音声を同一の768次元空間へ写像し、個別の変換モデルを連結することなく横断検索を実現するモデルです。オンデバイスで完結させれば、機密データを手元に保ったまま、ネットワーク環境に左右されない検索やRAG環境を構築できます。技術的な設計の方向性は明確で、実務での活用イメージも十分に描けます。
一方で、公表されたPixel 11 ProのRAM消費量は特定端末による測定結果であり、128次元へ削減した場合はマルチモーダル検索の品質が約75%まで低下します。float16使用時のサイレントな品質劣化も、現場では気づきにくいリスクです。まずはテキストのみのインデックスから始め、次元数やシステム構成を実データで検証する。この手順を省いた導入は、後から修正コストが跳ね上がります。便利なモデルほど、検証設計を丁寧に組む必要があります。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Google AI for Developers – Google AI for Developers
- (*2) EmbeddingGemma 2: The Developer Guide
- (*3) Superpower Daily – Google Releases EmbeddingGemma 2 for Offline Search Across Photos, Audio and Video
- (*4) Bring multimodal semantic search to the edge with EmbeddingGemma 2
- (*5) google/embeddinggemma-2 · Hugging Face
- (*6) Google AI for Developers – EmbeddingGemma 2 model card
- (*7) embeddinggemma-2
- (*8) The New Stack – Your phone's vector index might be bigger than the AI model running it
- (*9) Bring multimodal semantic search to the edge with EmbeddingGemma 2
- (*10) Google AI for Developers – Generating Embeddings with EmbeddingGemma 2 and Sentence Transformers