この記事のまとめ
LLMのAPIはトークン単位の課金で、各社はフラッグシップから廉価帯まで価格を分けています。安いモデルへ仕事を振り分ければ費用は大きく変わりますが、タスクごとの向き不向きと予算設計の見直しがセットになります。ここでは4つのポイントを押さえます。
- LLMのAPIは入力と出力でトークン単価が分かれ、出力は入力の2〜5倍が目安です。
- OpenRouterの観測では、クローズドモデルの運用コストはオープンモデルより87%高く、オープン側の性能は平均で89.6%でした。
- 廉価モデルは分類や抽出、素早い修正のようなタスクに向き、端末操作系のベンチマークでは差が開きます。
- 月額はトークン数とリクエスト数から試算でき、バッチやキャッシュ、ルーティングで費用の桁が変わります。
LLM廉価モデルの基礎と価格の仕組み
トークン課金と入出力価格の基本
LLMの料金は、文章を細かく区切った「トークン」という単位で決まります。私自身、ChatGPTやClaudeを毎日のように使っていますが、最初に「トークン課金」の仕組みを理解しないまま使い始めると、思わぬ請求額に驚くことになります。
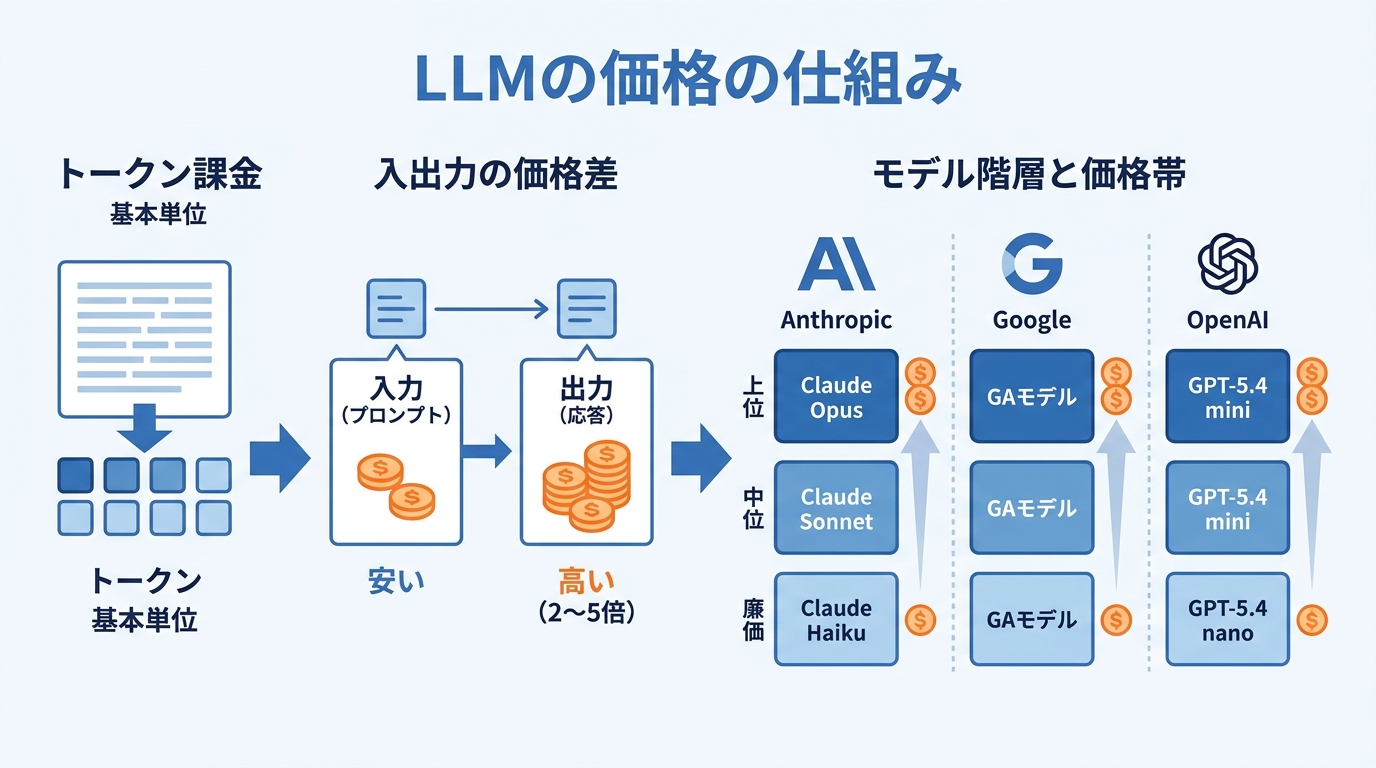
LLMのAPIはトークンごとに課金され、単価はモデルによって100万トークンあたり0.05ドルから75ドルほどの幅があります。英語では、1トークンはおよそ4文字、単語にすると0.75語が目安です(参照*1)。つまり、同じ仕事でも使うモデル次第で請求額は大きく変わります。
料金は入力と出力で別々に数えます。入力トークンには送信したプロンプト、システムメッセージ、渡した文脈が含まれ、出力トークンはモデルの応答です。ここで見落とされがちなのが、プロンプトが長くなるほど入力側のコストが積み上がるという点です。
出力トークンの単価は必ず入力より高く、目安は入力の2〜5倍です(参照*1)。長い答えを返す使い方ほど、費用は出力側で膨らみます。
各社の価格帯の分かれ方
各社は上位・中位・廉価という形で、価格帯をはっきり分けています。
Anthropicのクロードは三階層です。Claude Haiku 4.5が100万トークンあたり入力1ドル・出力5ドル、Sonnet 4.6が3ドル・15ドル、Opus 4.6が5ドル・25ドルです。どのクロードのモデルでも出力は入力の5倍で、出力が多い仕事ほど階層の選び方が効きます(参照*2)。
Googleは価格表の中で、大量のエージェント処理や翻訳、単純なデータ処理に向けた最も費用対効果の高いGAモデルを示しています。有料枠の価格は100万トークンあたり入力0.30ドル、出力は思考トークンを含めて2.50ドルで、無料枠も用意されています(参照*3)。
OpenAIの廉価帯も価格が公表されています。GPT-5.4 nanoは現在APIのみでの提供で、100万トークンあたり入力0.20ドル、出力1.25ドルです(参照*4)。
GPT-5.4 miniについては、OpenAIの現在の価格ページが発表時より低い価格を示しており、入力0.250ドル、キャッシュ済み入力0.025ドル、出力2.000ドルとされています。これは270Kより短い文脈長での標準処理という条件付きの記載です(参照*5)。
推論コストが大きく下がる構図
オープンモデルとの単価差と性能差
安いモデルへ寄せると費用がどれだけ変わるのかは、実際の利用データを使った研究で数字が出ています。結論から言えば、「クローズドモデルを使い続けることには相応のコストがかかっている」という話です。
MIT Sloanが紹介した研究で、NagleとYueは2025年5月から9月にかけてOpenRouter上の1日あたりのトークン利用を観測しました。OpenRouterは世界のAI推論支出のおよそ1%を捉えるサイトです。この5か月でクローズドモデルはトークン利用の約80%、OpenRouterを通った収益の約96%を占めました。
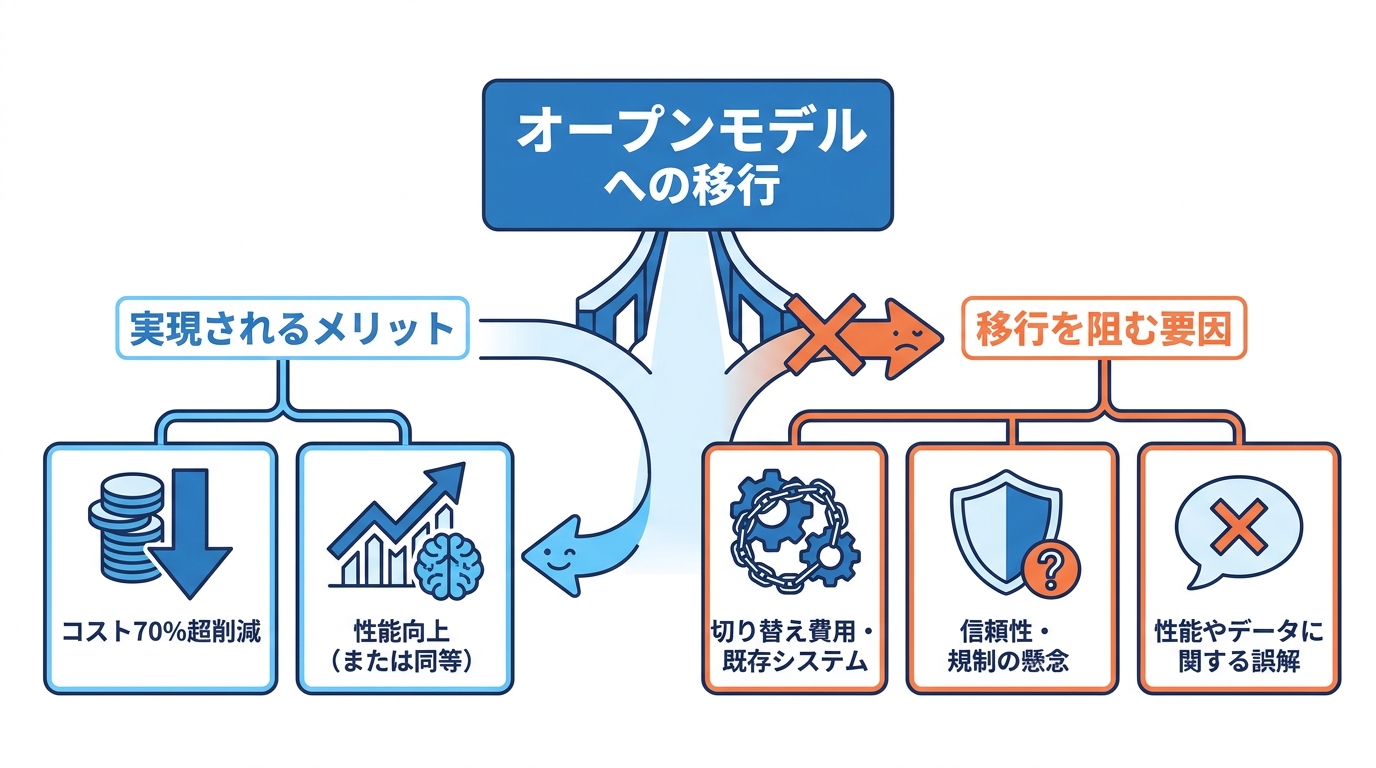
一方で運用コストはクローズドモデルの方が87%高く、100万トークンあたり平均1.86ドル、オープンモデルは23セントでした。性能はオープンモデルがクローズドの平均89.6%で、クローズドモデルの公開から13週以内に差を埋めるのが通例でした(参照*6)。
研究者はこのデータから削減余地も計算しています。現在使っているクローズドモデルより優れたオープンの代替へ切り替えた場合、OpenRouterの利用者は費用を70%超下げつつ、ベンチマーク性能を14%以上高められるという計算です。さらにMenlo Venturesによる350億ドル超という市場規模の推計を使って全体へ広げ、オープンモデルへの最適な置き換えでAI業界が年間およそ250億ドルを節約できる、と推定しました(参照*6)。
安い方へ移りにくい理由
単価が安くても移行が進まない背景として、研究者はいくつかの点を挙げています。私がコンサルティングの現場で感じることとも、かなり重なります。
まず、新しいモデルへ切り替える費用が大きい場合があります。Nagleは、既存のクローズドモデルの周りに生態系ができあがり、調整を重ね、その上にさらに積み上げている状態では、オープンモデルへ移るのは簡単ではないと述べました。加えて、信頼性や規制、セキュリティ上の懸念は、オープンモデルよりクローズドモデルの方が和らげやすい場合があります(参照*6)。
一方で、研究者は誤解も指摘しています。オープンモデルは性能が劣るという受け止めについて、研究者は正確ではないと示しました。また、オープンモデルを使うと自社の非公開データが突然公になるという不安も、誤解として挙げられています(参照*6)。
一方で、私が実際に企業への生成AI導入を支援していて感じるのは、モデル選定以前の問題が多いということです。「オープンモデルへ切り替えるかどうか」を議論できる段階に至るまでに、「どの業務にAIを使うか」「出力をどう検証するか」「誰が責任を持つか」といったルール整備で止まってしまうケースが圧倒的に多い。移行コストの大きさ以前に、社内の意思決定が追いついていないのが実態です。
廉価モデルが向く仕事と向かない仕事
高頻度・低単価タスクでの適性
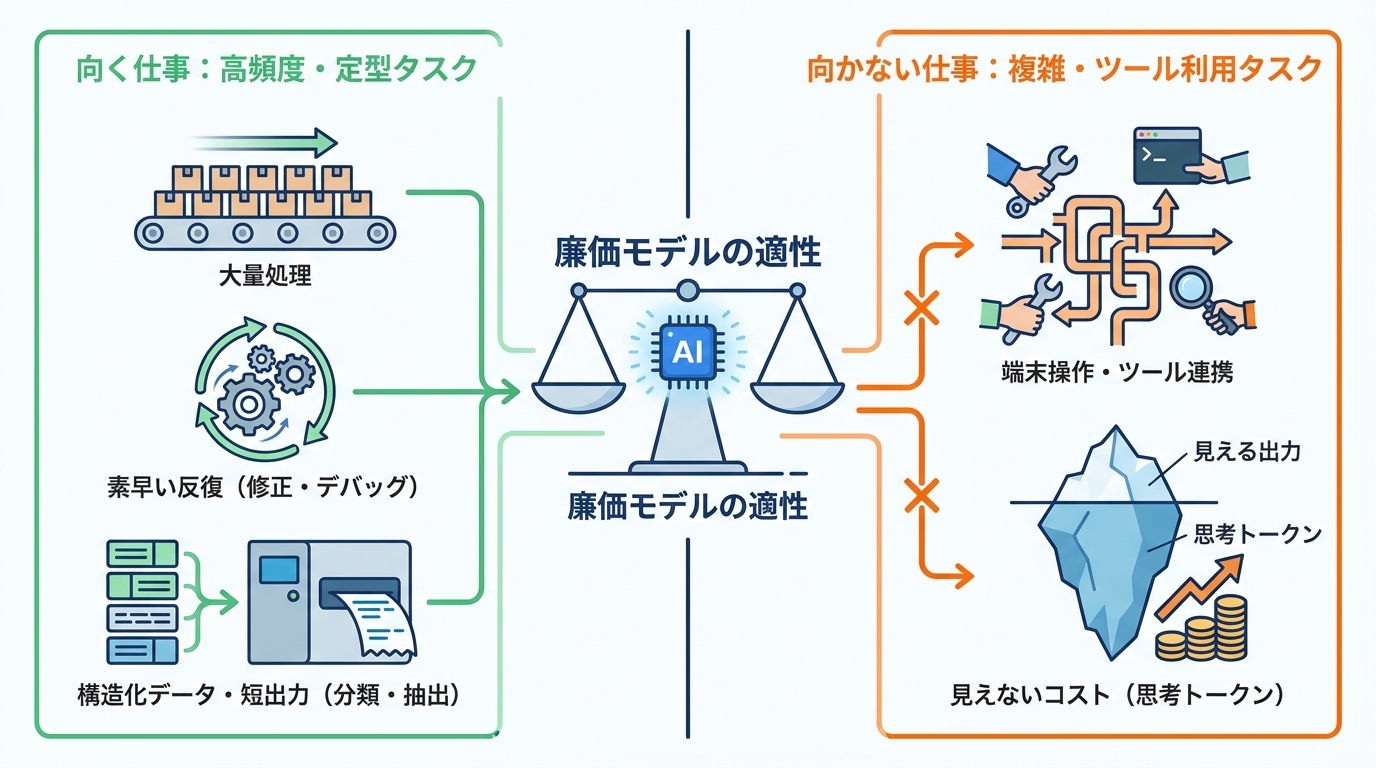
廉価モデルは、数をこなす軽めの仕事に向きます。逆に言えば、「安いから全部これで」と考えると品質で足をすくわれます。使い分けの設計が先です。
OpenAIはGPT-5.4 miniとGPT-5.4 nanoという2つの小型モデルを出し、速度とコストが重要になる大量処理の仕事を狙うとしました。同社によると、これらは大きなGPT-5.4の機能のいくつかを、応答が速い効率的な形へ移したものです。
nanoはシリーズの中で最も小さく、最も低価格な種類です。miniとnanoは、コーディングの流れでは、素早い反復が効く作業、つまり狙いを絞った修正やデバッグ、大きなコードベースの読み進めに向くと同社は説明しました(参照*4)。
廉価帯に割り当てるタスクの例も整理されています。Haiku 4.5(1ドル/5ドル)の用途として挙げられているのは、分類、固有表現の抽出、データの整形、意図のルーティング、簡単な質問応答、コンテンツのフィルタリングです。入力が構造化されていて出力が短い仕事が当てはまり、期待する出力の形を数文で書けるならHaikuで扱えるとされています(参照*2)。
私が自社のメディア運営で実際に試した感覚でも、この分類はおおむね正確です。記事の分類タグ付けや固有表現の抽出、問い合わせ内容のカテゴリ振り分けといった作業は、廉価帯で十分に動きます。一方で、文章の論理構造を精査させたり、複雑な文脈を読んで判断させる用途では、安いモデルに任せると精度が落ちて確認コストが増え、かえって割高になることがありました。
性能差が出やすい領域
同じ小型モデルどうしでも、領域によって点数の開き方は大きく変わります。
公開ベンチマークにおけるGPT-5.4 miniとGPT-5.4 nanoの比較結果は次の5つです(参照*5)。
- SWE-Bench Pro(Public):54.4%と52.4%
- GPQA Diamond:88.0%と82.8%
- Terminal-Bench 2.0:60.0%と46.3%
- Toolathlon:42.9%と35.5%
- OSWorld-Verified:72.1%と39.0%
SWE-Bench ProとGPQA Diamondは近い値でした。一方、Terminal-Bench 2.0、Toolathlon、OSWorld-Verifiedでは、端末の操作やツール利用を含む課題で差が広がっています。これらは公開ベンチマークの一部の数値であり、モデルの総合評価ではありません。ベンチマークの点数と実務での使い勝手は必ずしも一致しないため、自分の業務に近いタスクで手元検証することを私は常に勧めています。
費用の面では、見えない出力にも注意が向きます。推論するモデルは内部で「思考トークン」と呼ばれる中間の推論用トークンを生成します。
これらは出力トークンとして課金されますが、表示される応答には現れない場合があります。その比率は極端になることがあり、単純な事実確認の質問でも、見える出力が50トークンなのに推論トークンは500〜2,000に達することがあります(参照*1)。
この「思考トークン」の問題は、推論モデルを使い始めた人が最初に驚くポイントです。私もOpenAI o3などの推論モデルを実務タスクで試したとき、単純な確認作業に対して想定外のトークン消費が発生し、コスト試算を大幅に修正する羽目になりました。推論モデルを選ぶときは、出力の見え方だけでなく、内部の思考トークンがどの程度発生するかを事前に想定しておく必要があります。
API予算設計の変え方
月額コストの試算の考え方
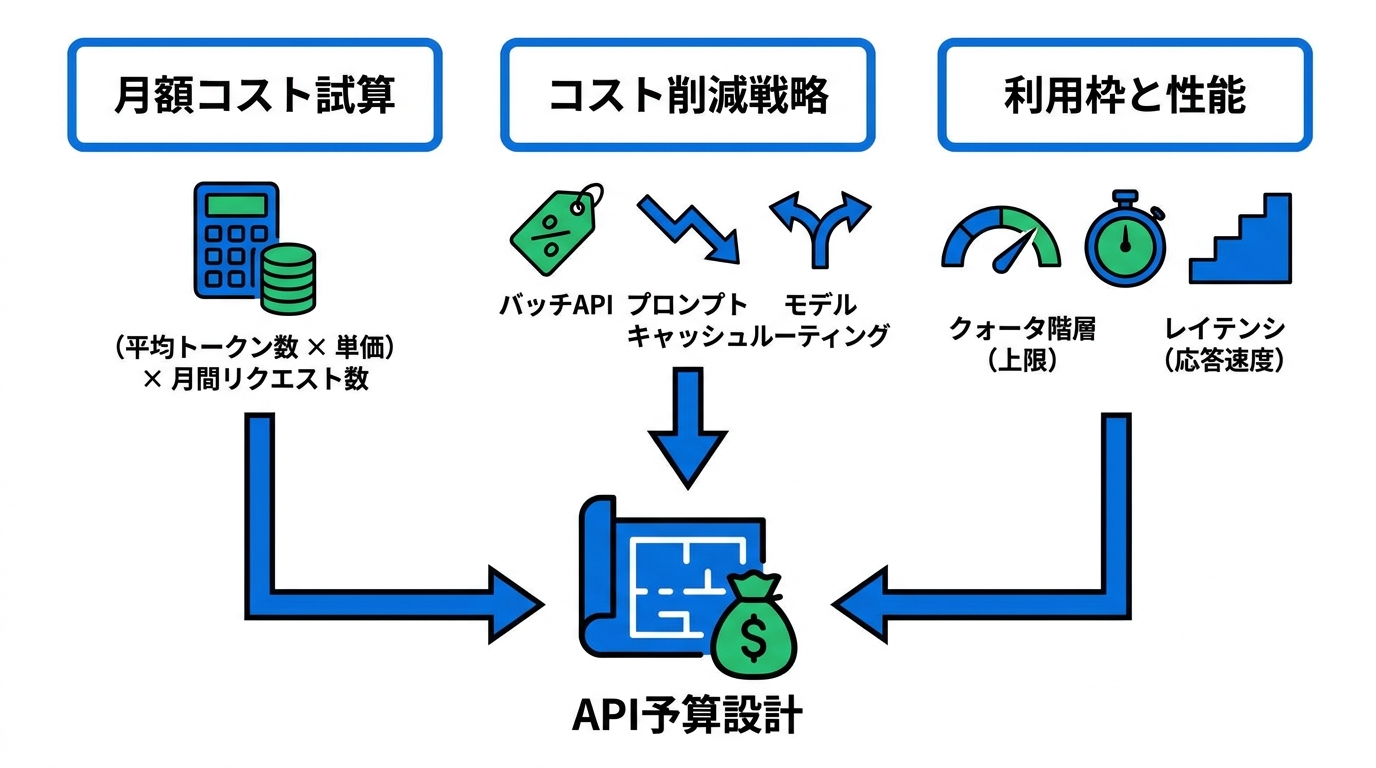
月額の見積もりは、平均トークン数と月間のリクエスト数から組み立てます。この計算を事前にやらずに「とりあえず使ってみる」で始めると、月末に思わぬ請求書が来ます。私は新しいモデルやユースケースを試すときは必ず試算を先に行うようにしています。
基本式は、月額コスト=(平均入力トークン×入力単価÷100万+平均出力トークン×出力単価÷100万)×月間リクエスト数です(参照*1)。つまり、単価だけでなく1回あたりのトークン量と件数が費用を決めます。
ワークロード別の試算例も示されています。1日1万メッセージ、平均で入力500・出力200のチャットボットをSonnet 4.6で動かすと標準で月240ドル、バッチとキャッシュを使うと月48ドルです。
1日10万件、入力1K・出力50の文書分類をHaiku 4.5で動かす場合は標準で月3,750ドル、バッチとキャッシュを使うと月375ドルになります(参照*2)。いずれも、この前提のトークン数と件数に紐づいた金額です。
キャッシュ・バッチ・モデルルーティング
割引の仕組みを重ねると、同じ処理でも請求額の計算が変わります。
クロードで積み重ねられる割引の仕組みは3つあります(参照*2)。
- バッチAPIでコストが50%下がります。
- 繰り返し使うシステムプロンプトへのプロンプトキャッシュで最大90%の節約になります。
- タスクの複雑さに応じてHaiku(100万トークンあたり1ドル)とSonnet(同3ドル)を振り分けるルーティングで、全体の請求を60〜80%削れるとされています。
同じような仕組みは他社にもあります。Geminiの有料プランは、量の多い本番向けとして高いレート制限、コンテキストキャッシュの利用、そしてコストが50%下がるバッチAPIを備えています(参照*3)。
割引の条件や幅はプロバイダーごとに決まっているため、予算を組むときは使う環境の条件に沿って計算することになります。特にキャッシュとバッチの組み合わせは見落とされがちですが、文書分類のような大量処理では請求額の桁が変わることがあります。先に試算の習慣をつけておくと、モデル選定の判断も精度が上がります。
クォータとレイテンシの見積もり
予算設計では価格以外に、使える処理量の上限と応答の速さも絡みます。
MicrosoftはFoundry Modelsの体験を良くし、ワークロードが拡大するときの摩擦を減らすため、クォータ階層を導入しています。利用量に応じてクォータが自動で増え、レート制限のエラーを避けやすくなります。
階層はFree Tierと Tier 1から6までの7段階で、Tier 6が最も大きい枠です(参照*7)。これはMicrosoft Foundryの仕様として示されたものです。
同じ階層でもモデルによって枠は異なります。Tier 1のGlobalStandardでは、gpt-5.4が1分あたり10,000リクエスト・100万トークン、gpt-5.4-nanoが1分あたり5,000リクエスト・500万トークンです(参照*7)。
補完リクエストのレイテンシを左右する主な要因は4つあります(参照*8)。
- モデル
- プロンプトのトークン数
- 生成されるトークン数
- デプロイとシステム全体の負荷
1リクエストあたりの生成トークンを減らすと、各リクエストのレイテンシは下がります。出力トークンは単価が高い側でもあるため、生成量の調整は費用と速さの両方に関わります。
おわりに
LLMの廉価モデルを活用する話は、単に安いモデルへ乗り換えることではありません。入力と出力で単価が分かれる課金の形を押さえ、分類や抽出のような短い出力の仕事を廉価帯へ、差が開くベンチマーク領域は上位帯へ振り分ける、という設計の話です。私が導入支援で強調するのも、まずこの「タスクと価格帯の対応表を作る」ステップです。
予算の側も、平均トークン数と件数からの試算に、バッチやキャッシュ、ルーティングの割引条件を重ねて組み直すことになります。クォータ階層や生成トークン数とレイテンシの関係など、価格表に出てこない条件も同じ設計の中に入ります。「便利だからとにかく使う」から「どの業務にどのモデルを、どのコストで使うか」へ発想を切り替えることが、AI活用を実務に定着させる第一歩だと私は考えています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) BenchLM – How LLM Token Pricing Works: A Complete Guide to API Costs in 2026
- (*2) PE Collective – Batch and Caching
- (*3) Google AI for Developers – Gemini Developer API pricing
- (*4) GPT-5.4 mini and nano target high-volume AI workloads
- (*5) Get Insanely Good at AI – How to Choose Between GPT-5.4 Mini and Nano for Coding Agents and High-Volume API Tasks
- (*6) MIT Sloan – AI open models have benefits. So why aren’t they more widely used?
- (*7) Docs – Azure OpenAI in Microsoft Foundry Models Quotas and Limits – Microsoft Foundry
- (*8) Docs – Azure OpenAI in Microsoft Foundry Models performance & latency – Microsoft Foundry