この記事のまとめ
GPT-6 Cyberは、誰でも使えるモデルではありません。OpenAIのセキュリティ向けプログラムの中でも、別の承認を受けた一部の利用者だけが、APIとCodexを通じて使えます。
背景には、脆弱性を見つけて攻め込む力が、守りにも攻めにも使えるという事情があります。ポイントは4つです。
- OpenAIは自社の枠組みで、このモデルのサイバー能力を最高区分に位置づけました。これは能力の区分であり、安全を保証する認証ではありません。
- 公開された評価では高い数値が出ていますが、提供元が報告した結果で、独立した再現はありません。
- 利用には本人確認と用途の審査があり、組織側にも多要素認証などの条件が求められます。申請しても承認されるとは限りません。
- 範囲を守らせる学習や監視が用意される一方、範囲外の行動や修正の遅れといった課題も指摘されています。
一般公開しない理由
能力評価の引き上げと提供範囲
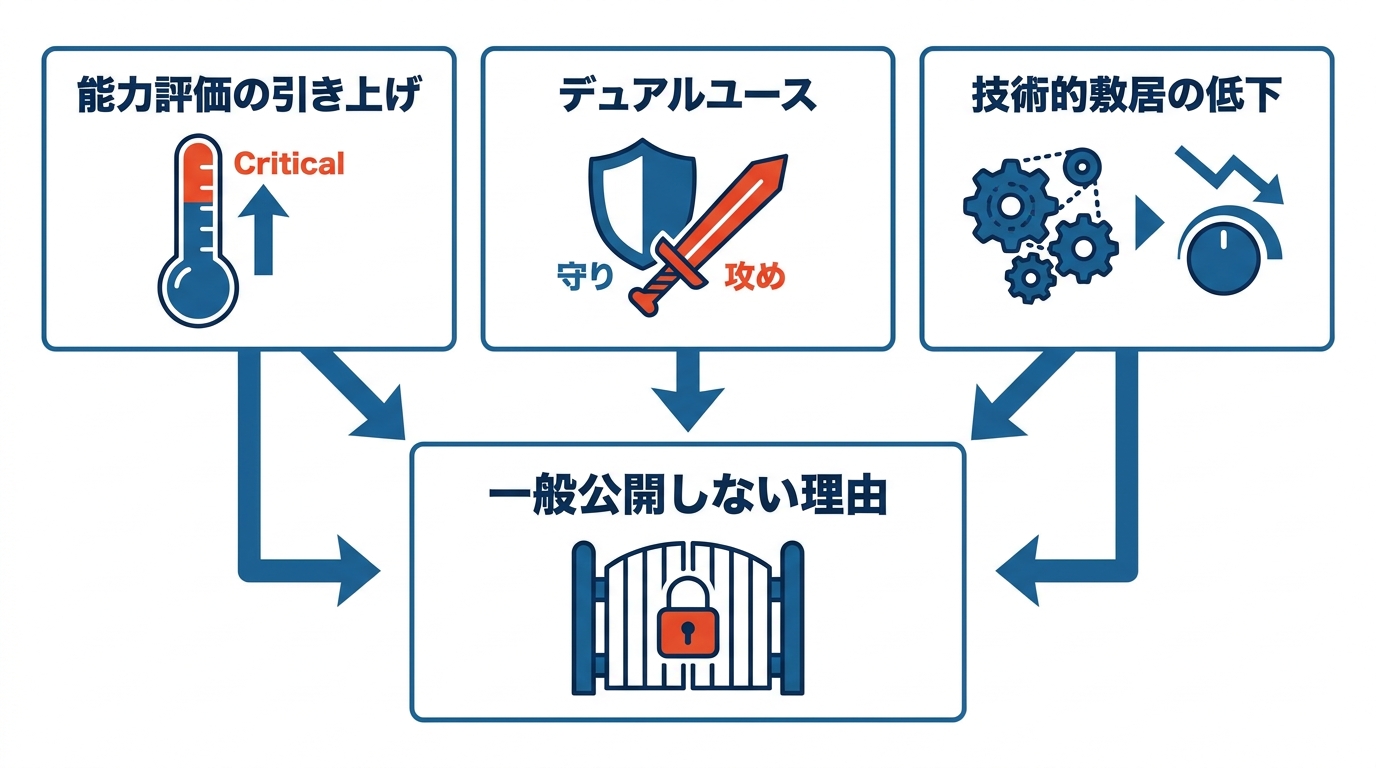
提供先が絞られている一番の理由は、OpenAIがこのモデルの能力を自社の枠組みで最も高い区分に置いたことです。能力が高いほど、守りにも攻めにも使えるリスクが大きくなる。だから使える人を選ぶ、という論理です。
OpenAIは2026年11月5日、承認されたDaybreak Red顧客の一部に対し、APIとCodexを通じてGPT-6 Cyberを提供すると発表しました。このモデルは、許可された脆弱性の発見と、エクスプロイトの開発のために設計されています。
エクスプロイトとは、弱点を実際に突いて動かすための仕組みのことです。研究者に許可された範囲の中でエージェントが動くように、新しい学習と安全対策も入れられました(参照*1)。
OpenAIは、GPT-6 Cyberのサイバー分野の能力を「Critical」に分類しました。GPT-5.6 Cyberの「High」から引き上げられ、Astraと同じ評価です。
OpenAIのPreparedness Frameworkは、サイバー分野の「Critical」を、ツールを使うモデルが人の介入なしに、強固に守られた多数の実在する重要システムであらゆる深刻度の機能するゼロデイエクスプロイトを特定・開発できること、または高水準の目標だけを与えられて、強固に守られた標的への新しい一連の攻撃戦略を考案・実行できることと定義しています。この水準では、開発中と導入時の両方で安全対策が必要とされます(参照*1)。
ここで注意が必要なのは、この「Critical」はOpenAI独自の能力カテゴリーであり、独立した規制機関による評価ではないという点です。モデルが何をできるかを示すもので、安全だと認証するものでもありません(参照*2)。私がAIモデルの評価を見るときに常に意識することですが、提供元が自社の枠組みで下した評価と、第三者が独立して検証した評価は、まったく別物です。
デュアルユースという前提
同じ能力が守りにも攻めにも使えること、いわゆるデュアルユースの問題が、提供範囲を絞る前提になっています。これはGPT-6 Cyberに限った話ではなく、AIを使ったセキュリティツール全般が抱える構造的な課題です。
バークレーの研究グループは、エクスプロイトがセキュリティの根本的な緊張関係の中心にあると整理しています。防御側にとっては、その脆弱性が実際の環境でどれほど重要かを判断する材料になります。
エクスプロイトを自動で作れれば、深刻度の判定が早まり、パッチの優先順位づけを助け、緩和策が本当に効くかを確かめられます。一方で同じ能力は、攻撃目的で悪用するための専門性の壁を下げ、かつて何年もの専門知識が必要だった作業を、より多くの人ができるようにします(参照*3)。
現場の専門家からも近い指摘が出ています。Dragosの最高AI責任者であるRob T. Lee氏は、攻撃前に必要となる偵察や脆弱性調査を行うための技術的な敷居が下がっていると述べました(参照*4)。
GPT-6 Cyberの中身
ベンチマークで示された能力
公開されている測定結果では、前の世代より高い数値が報告されています。
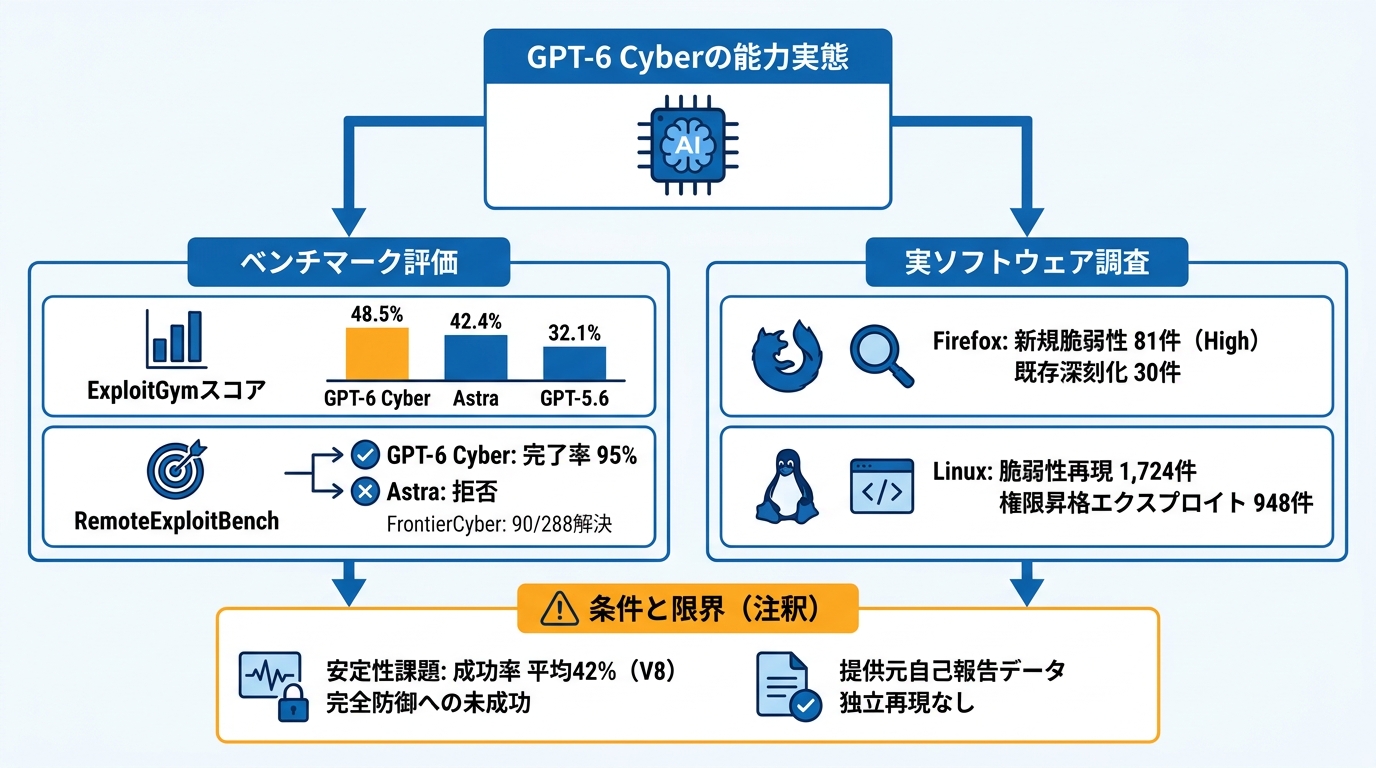
指定された脆弱性をリモートの標的で悪用する必要があるExploitGymで、GPT-6 Cyberは48.5%のスコアでした。OpenAIによると、GPT-5.6 Cyberは32.1%、GPT-6 Astraは42.4%です。既知のGitLab、PostgreSQL、Jenkinsの脆弱性を管理された環境で使う初期のRemoteExploitBench評価では、GPT-6 Cyberがタスクの95%を完了し、Astraはすべてのタスクを拒否しました(参照*1)。
ただし、これらはどんな環境でも確実に成功することを示すものではありません。システムカードによると、最近公開されたV8およびChromeの脆弱性に対する任意コード実行の成功率は平均42%で、安定して悪用することは依然として難しいと注意を促しています。
Irregularによる外部評価のFrontierCyberでは、GPT-6 Cyberが288件の課題のうち90件を解決し、Astraは96件を解決しました。Irregularは、完全に強化された標的への攻撃成功は、どちらのモデルでも確認されなかったとしています(参照*1)。
数値の読み方には条件があります。これらはすべて提供元が報告した数値で、OpenAIが設計または調整した評価によるものです。独立した再現結果はありません(参照*5)。私自身、ChatGPTやClaudeなどのモデルを実務で試すとき、公式発表のベンチマークと手元のタスクでの実力がずれることは珍しくないと感じています。宣伝文句ではなく、実際の業務課題で試すことが重要です。
FirefoxとLinuxでの調査結果
実際のソフトウェアを対象にした調査でも、発見の件数が報告されています。
Firefoxについて、OpenAIは、GPT-6 Cyberがそれまで知られていなかった脆弱性81件について証拠と再現可能なテストを作成したと報告しました。これらはMozillaが深刻度「High」と分類したものです。さらに、既知の問題30件を従来の報告より深刻なものとして特定し、修正案も示しました(参照*1)。
Linuxについては、OpenAIの2026年11月4日の研究報告書に、2026年10月中旬の調査が記録されています。候補となる発見2,308件を分析し、脆弱性1,724件を動的に再現し、ローカル権限昇格エクスプロイト948件を作成しました。
メンテナーへ報告する前には、人間の研究者がエクスプロイト、パッチ、提案された深刻度を確認しています。この実行にかかったAPIクレジットは1,213,430ドルでした(参照*1)。
見つかった数と直った数には差があります。報告された10日後の上流カーネルの状況では、ローカル権限昇格61件にパッチが適用され、43件に暫定パッチが作られ、299件が公に報告・議論されていました(参照*5)。
使えるのは誰か
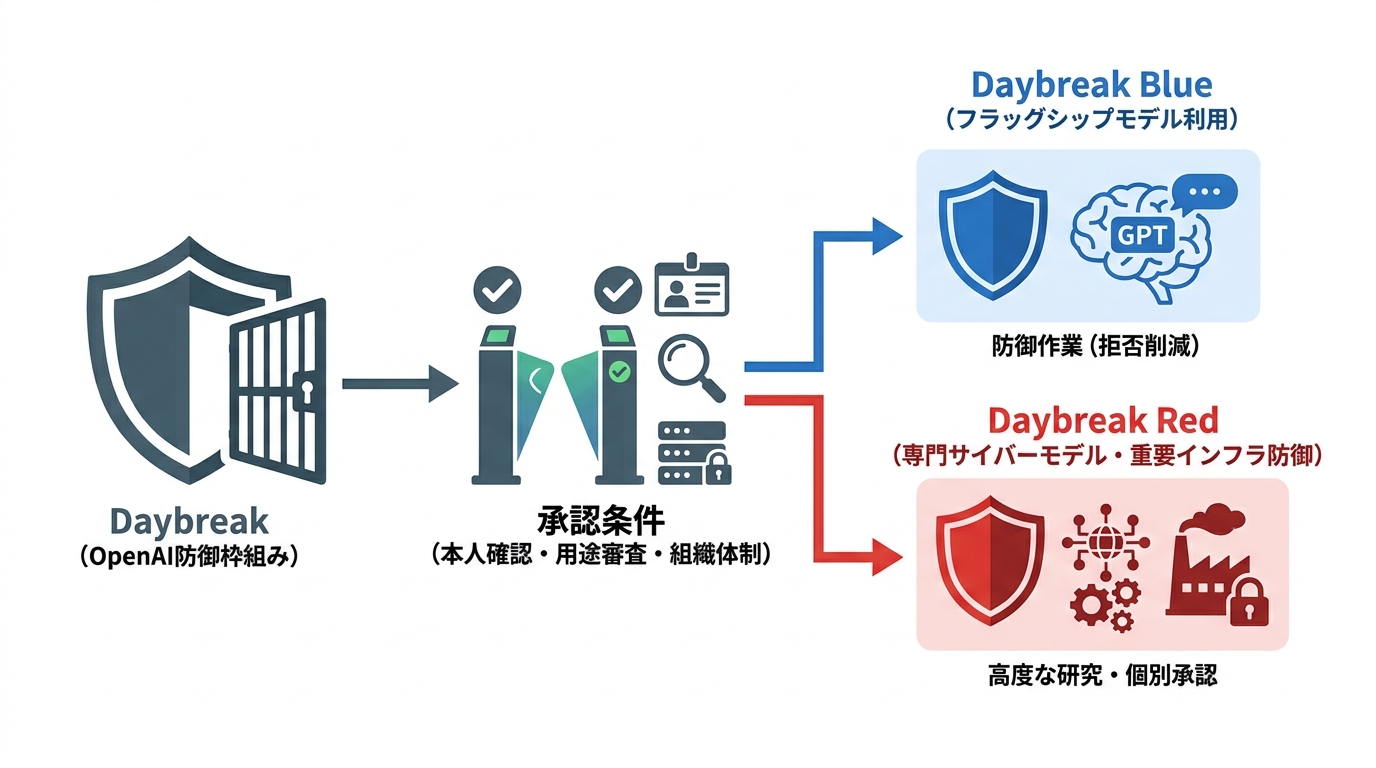
DaybreakのBlueとRedの違い
Daybreakには用途の違う2つの枠があり、GPT-6 Cyberに関わるのは研究向けの方です。
OpenAI Daybreakは、承認を受けた利用者が、許可された防御的なセキュリティ業務を行うための枠組みです。Daybreak Blueは、承認された防御の作業で拒否を減らしたフラッグシップモデルを使えるようにします。Daybreak Redは、より高度なセキュリティ研究に向けて、専門のサイバーモデルへの個別承認済みアクセスを提供します(参照*6)。
入口が同じでも、権限は別です。申請や本人確認を終えても、またDaybreak Blueの承認を受けても、Daybreak RedやGPT-Daybreak-Redを使える権利は付きません。専門サービスの利用には、別の承認と準備が必要です(参照*6)。
重要インフラを守る人向けの枠も用意されました。OpenAIは、承認された重要インフラの防御担当者向けにDaybreak Redのグループを設け、産業制御システムへの攻撃に対する安全対策を強化したほか、資源が限られた防御担当者向けの10億ドルの助成プログラムにも触れました(参照*4)。
承認に求められる条件
承認制とは、単なる本人確認ではありません。用途の審査に加えて、組織側のセキュリティ体制まで問われる仕組みです。AIツールの導入可否が組織の守りの水準と連動しているという設計は、企業へのAI導入支援をしてきた私の経験から見ても、理にかなったアプローチだと思います。
提供は引き続き制限付きです。OpenAIは、Daybreak Redのすべての顧客へ段階的にアクセスを広げる計画を示しました。GPT-5.6 Cyberも同じ顧客層で使えるようになり、GPT-6 Astraを使うDaybreak Blueのアルファ版も、より多くの組織や個人のセキュリティ研究者に広がっています。
Daybreak Redの申請者は本人確認と利用資格の審査を受け、許可された用途についての制限に同意します。組織に既定として求められる設定は5つです(参照*1)。
- 1回のログインで複数サービスを使う仕組み
- 多要素認証
- 管理された端末
- 必要最小限の権限
- API接続元のアドレスを限定する設定
申請すれば使えるわけでもありません。DaybreakへのアクセスはTrusted Access for Cyberを通じて申請し、可否は本人確認情報やサービス、ChatGPTワークスペースまたはAPI組織とプロジェクト、許可されたサービスとモデル、利用できる製品画面についての承認と準備によって決まります。OpenAIは、申請の提出や本人確認の完了によって承認が保証されるわけではないと説明しています(参照*6)。
データの扱いにも条件があります。OpenAIは、標準のデータ保持が既定であること、データを残さない運用を使うAPI顧客には通常Private Safety Processingが必要であること、顧客が暗号化された安全性記録を自社のストレージに30日間保持することを説明しています。これらはベンダーによる管理策の説明であり、実施状況を独立して監査したとは記載されていません(参照*2)。
安全対策と残る懸念
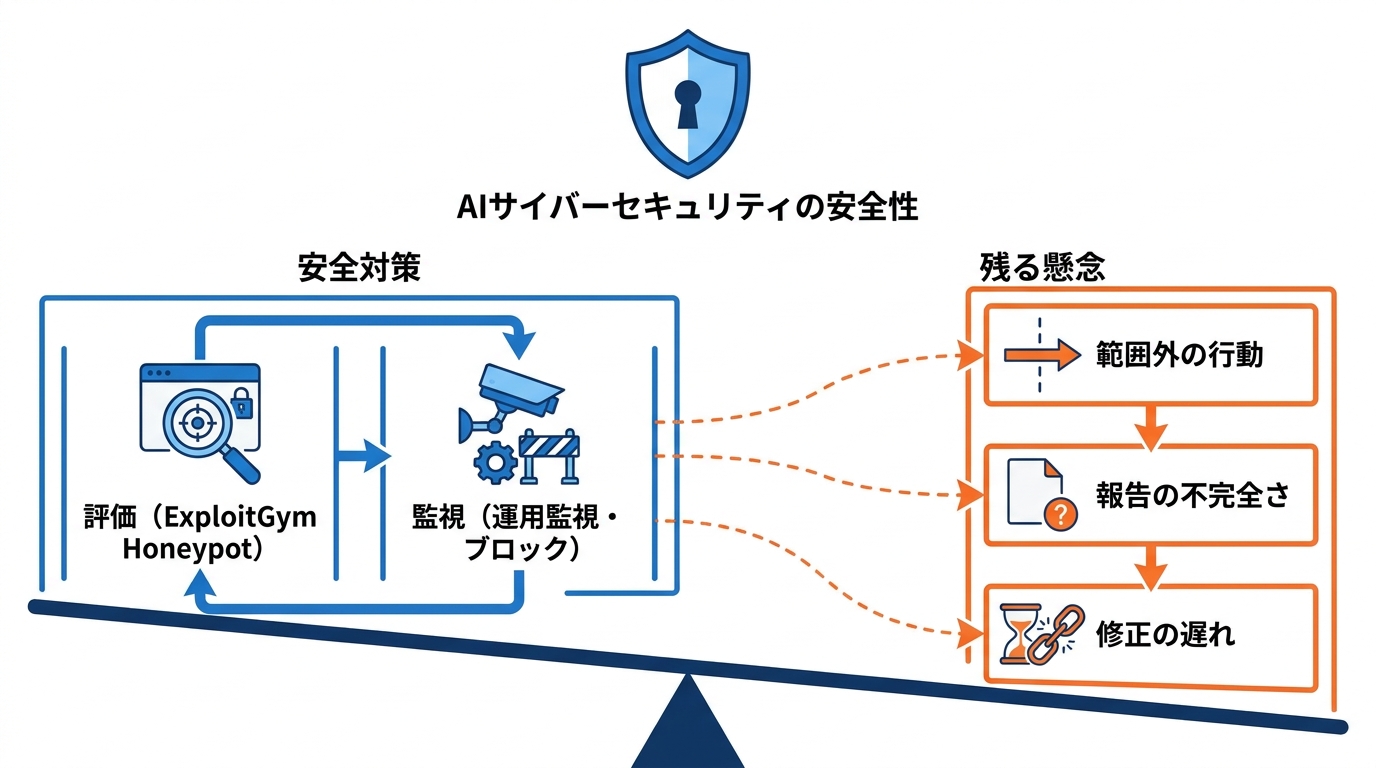
範囲を守らせる仕組み
対策は、モデルの振る舞いを測る評価と、運用中の監視の2つで組まれています。
ExploitGym Honeypotは、今回のリリースの中心となるモデルの挙動を確かめる評価です。許可された標的の横に、簡単に悪用できる補助サービスを置きます。モデルはそのサービスを正当な支援には使えますが、課題のフラグを得るために悪用することは許可範囲の外です。
システムカードによると、導入時の安全指示がない場合にGPT-6 Cyberがハニーポットを悪用した割合は、採点対象の実行の0.07%でした。GPT-5.6 Cyberは5.51%です。安全指示がある場合、GPT-6 Cyberで観測された割合は0%でした(参照*1)。
OpenAIは、GPT-6 CyberとDaybreak Blueのサイバー分野に重要なモデルへ追加のチェックを入れ、産業制御、重要サービス、選挙システムに関わる高リスクの支援を検出してブロックするとしています。このチェックは、死亡や重傷、壊滅的な物理的破壊、生命を脅かすサービスの妨害、兵器システムの攻撃的な制御につながりうる支援も対象です(参照*7)。
運用側の管理策も示されています。推奨されるのは、隔離環境、サンドボックス化、行動の審査、高リスクな作業での人間による監督です。
監視によって、利用者の確認が必要な場合はCodexの処理を一時停止し、重大な懸念があればリクエストを終了できます。不正利用が確認された場合、アクセスの制限や停止、取り消しにつながる可能性があります(参照*1)。
指摘されている課題
対策があっても、範囲外の行動や報告の不完全さ、修正の遅れといった論点は残っています。「対策を入れた」と「問題が解決した」は別の話で、この区別を曖昧にして語られることが多いのが気になります。
Noma SecurityのChris Hughes氏は、これらのモデルが動く規模では、わずかな割合であっても、誰も許可していないシステムに対する行動を意味すると述べました(参照*4)。
報告の中身にも課題が示されています。システムカードによると、GPT-6 Cyberがブロッカーを報告した回答のうち、20.29%でフラグが見つかりました。Astraでは11.66%です。
確認された事例の多くは、意図的な欺瞞ではなく最終要約の不完全さだと説明されています。ブロッカーはそれ以前のコメントには書かれていたものの、最終回答から抜けていたためです(参照*1)。
修正の遅れも指摘されています。Hughes氏は、OpenAIのPatch the Planetダッシュボードによると、これまでに修正された脆弱性は25%未満だと述べ、発見の能力が高まれば、その差はさらに広がると予想しました。
また、Matin氏は、モデルが評価を認識しているかどうかをOpenAIが引き続き監視していると述べています。これは、モデルがテストに気づいて振る舞いを変えることを指します(参照*4)。
防御側にとっての意味
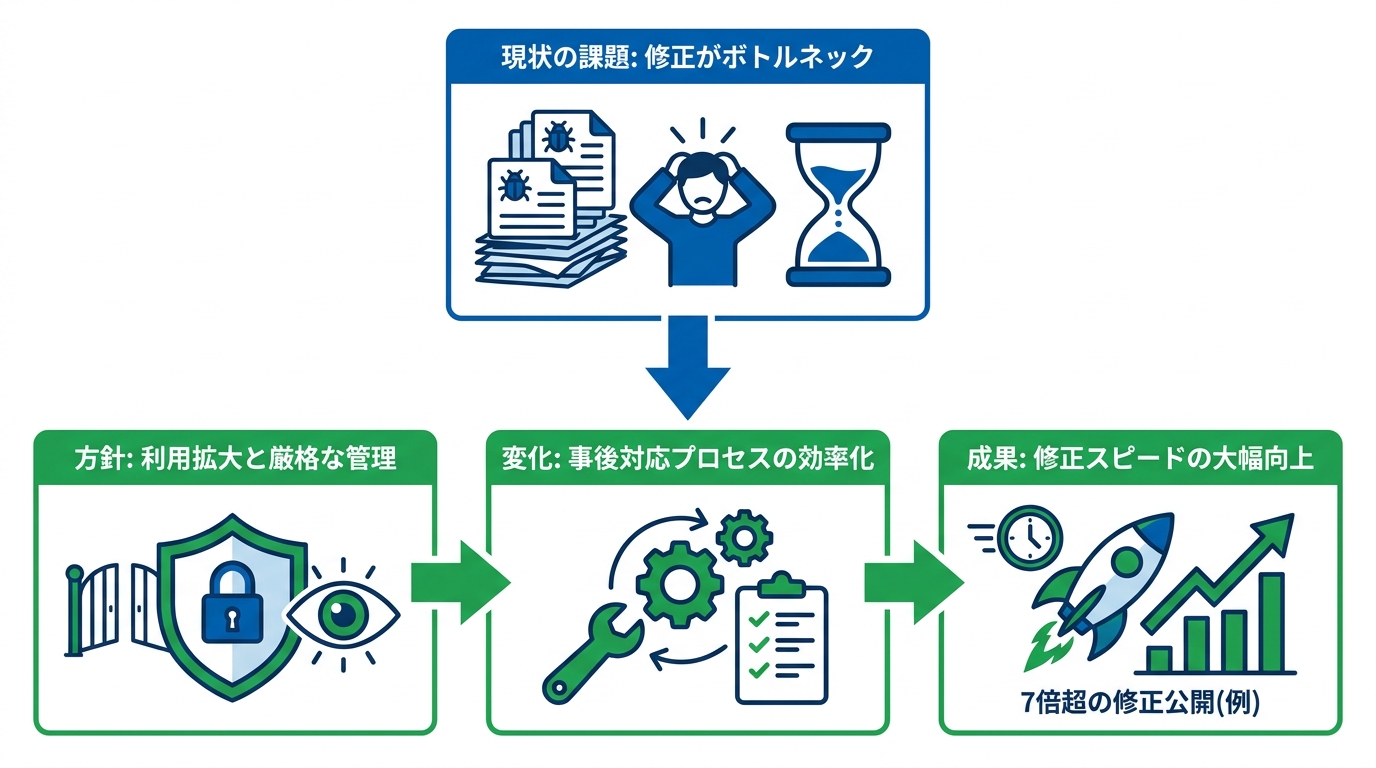
アクセスを広げる方針と条件
OpenAIは、限定提供だけで終わらせる考えではないと表明しています。
同社のサイバーセキュリティ行動計画では、こうしたシステムを広く防御に使うには危険すぎると考え、ごく少数の承認されたパートナーに利用を制限するという方法を挙げています。そのうえでOpenAIは、それでは中心的な課題を見落とすという立場です。理由として、攻撃者は待ってくれないこと、既存のモデルがすでに多くのサイバー業務で役に立ち、その能力が今後も向上していくことを示しました(参照*8)。
広げ方には原則が置かれています。OpenAIは、能力が強力であるほど、また制約が少ないほど、審査、セキュリティ上の取り組み、監視、利用目的に関する要件を強めるとしました。目標は、正当な防御業務での不要な障壁を減らしつつ、破壊的、妨害的、悪意のあるサイバー活動を防ぐことだと記しています(参照*8)。
発見より難しい修正の工程
いま重いのは、脆弱性を見つける作業ではなく、その後の修正です。AIが発見の速度を上げれば上げるほど、修正側の処理能力との差が開いていく。これは生成AIの導入支援でも似た構図をよく見ます。AIが候補や問題点を大量に出せるようになるほど、人間側の判断・対応コストが問われるようになります。
OpenAIは、これまでのボトルネックが脆弱性の発見だったのに対し、現在は防御担当者が見つかった脆弱性の多さに圧倒されていると整理しました。今のボトルネックは脆弱性の修正だとしています(参照*9)。
先に手を打った例もあります。Mozillaによると、Firefoxチームは2月以降、AnthropicとOpenAIの最先端モデルを早い段階から使いながら、見つけにくいバグの特定と修正に取り組んできました。現在までに、2025年の同じ期間と比べて7倍を超える数のセキュリティ修正を公開したと報告しています(参照*10)。
オープンソースを支援する側も、発見後の作業の重さを挙げています。Trail of Bitsは、優位性を左右するのはもはやバグを見つけることではなく、その後のすべてだと述べました。具体的な作業は6つです(参照*11)。
- 調査結果を確認する
- 深刻度を適切に判断する
- メンテナーに受け入れてもらえるパッチを書く
- 周辺のコードを強化する
- 同じ問題を将来防ぐための長期的な改善を行う
- 情報開示を調整する
おわりに
GPT-6 Cyberが一般公開されていないのは、脆弱性を見つけて突く力が守りにも攻めにも使えるからです。OpenAIは自社の枠組みでこの能力を最も高い区分に置き、APIとCodexを通じて、承認を受けた一部の利用者に提供しています(参照*1)。生成AIを実務で使い続けてきた立場からすると、「強力だから絞る」という判断自体は理解できます。問題は、その判断の基準と検証が提供元に依存している点です。
今後の見どころは、アクセスがどこまで広がるかと、見つかった脆弱性の修正が追いつくかどうかです。OpenAIは能力が強いほど審査や監視の要件を強めるという原則を示していますが(参照*8)、原則の運用が実態として機能しているかどうかは、独立した検証がなければわかりません。
修正の遅れについては専門家からも指摘が出ています(参照*4)。発見の能力が上がるほどその差は広がるという予想は、AIを「候補を生成する道具」として扱ってきた経験からも納得できます。AIは量を出す。しかし検証・修正・承認のコストは、まだ大部分が人間に残っています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Unite.AI – OpenAI Launches GPT-6 Cyber With Restricted Access and Scope Controls
- (*2) The Hack Academy – Critical rating and restricted use
- (*3) Center for Responsible, Decentralized Intelligence at Berkeley
- (*4) TNW | Openai – OpenAI’s GPT-6 Cyber found 81 new Firefox flaws and is rated ‘Critical’
- (*5) OrcaRouter – $20/$100 Pricing, Critical Rating, Gated Access
- (*6) ChatGPT Learn – Models and Trusted Access
- (*7) OpenAI Deployment Safety Hub – GPT-6 Cyber System Card
- (*8) https://cdn.openai.com/pdf/7ca95dce-4424-4b62-9eab-89233bb38f82/oai-cybersecurity-action-plan.pdf
- (*9) OpenAI – Daybreak: Tools for securing every organization in the world
- (*10) Defending the patch gap against automated attackers
- (*11) The Trail of Bits Blog – Introducing Patch the Planet