この記事のまとめ
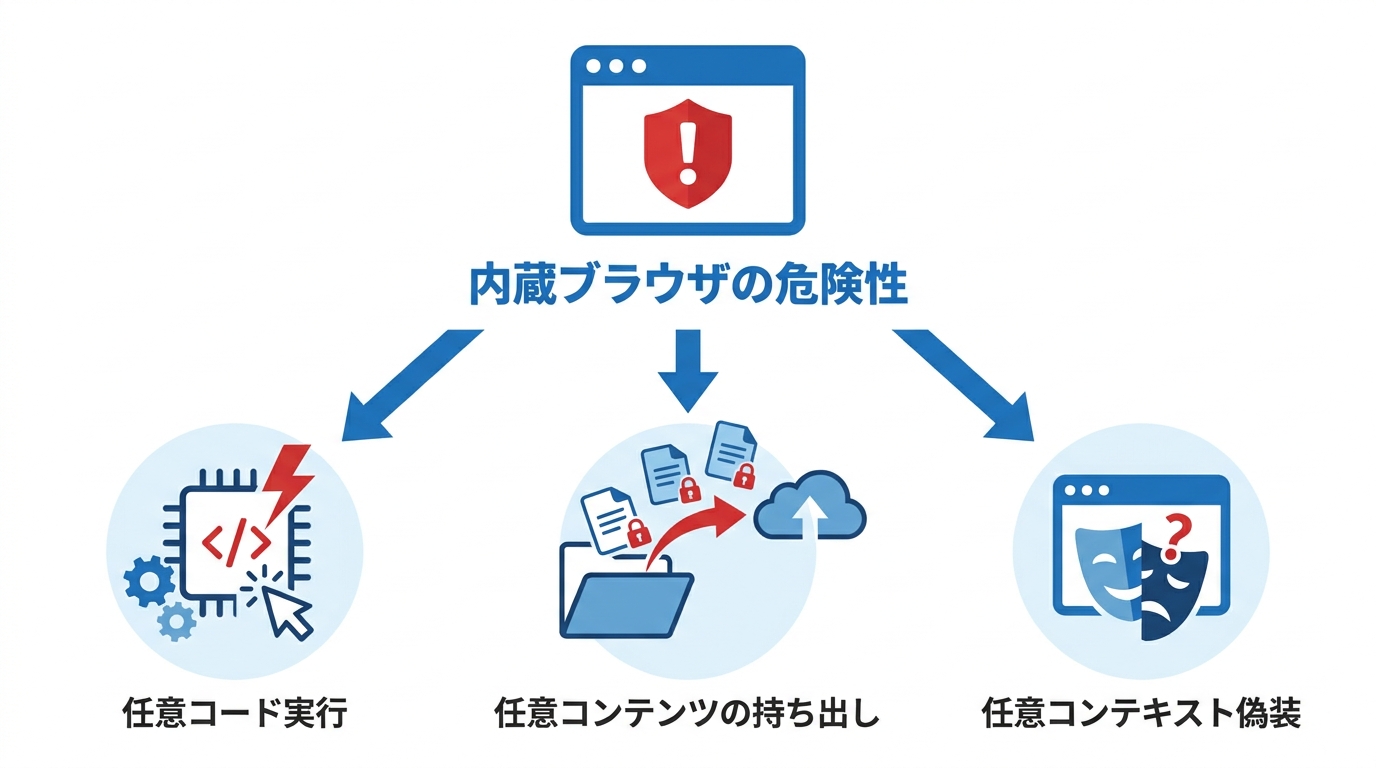
AIコーディングツールの内蔵ブラウザ5製品を調査した結果、危険性は3種類に整理されました。コードが実行される問題、パソコン内のファイルが読み取られて外部へ送信される問題、アドレス表示が偽装される問題です。一部の製品は修正済みですが、公開時点で未解決のまま残る製品もあります。
調査結果の要点は4つあります。
- 危険性の1つ目は任意コード実行です。Cursorにおいて、ページ内に潜む指示をエージェントが読み取り、利用者の権限でプログラムを実行し得ることが確認されました。
- 2つ目は任意コンテンツの持ち出しです。Claude Desktop、Codex、VS Codeにおいて、組み込みブラウザで開いたローカルファイルから、プロジェクト外のファイルまで読み取り、外部へ送信できることが確認されました。
- 3つ目は任意コンテキストの偽装です。GitHub Copilotにおいて、ページが自身の所在を偽り、利用者とエージェントの双方が偽の表示を信じる事態が発生しました。
- Cursorは10月1日に修正され、GitHub Copilotは報告前にGitHubが独自に修正しました。公開時点でCodexとVS Codeは未解決のままです。
内蔵ブラウザにおける3つの危険性
任意コード実行
細工されたページを開き、実行確認でEnterキーを1回押すだけで、手元のパソコン上で不正なコードが実行されてしまう危険性です。「1回押すだけ」という表現が大げさに聞こえるかもしれませんが、今回の調査はそれが現実に起きると示しています。
調査チームは今回の問題をEMBRACE(通常のブラウザと同じように信頼される組み込みブラウザ)と命名し、任意コード実行、任意コンテンツの持ち出し、任意コンテキスト偽装の3つに分類しました。このうち任意コード実行は、Cursorで確認されています(参照*1)。
その手口は、見た目の無害さを利用したものです。Cursorの組み込みブラウザで細工されたページを開くと、画面上の小さな表示部品内にコマンドが隠されています。人間には単なる表示に見えますが、エージェントは隠された指示を読み取り、その通りに動作してしまいます(参照*2)。これはプロンプトインジェクションの一形態であり、AIエージェントがページのコンテンツを「命令」として解釈してしまうことが根本の原因です。
影響の大きさには条件もあります。調査チームは、攻撃者が任意のプログラムを起動できるとし、その理由として、インストール手順がサンドボックス(隔離された実行環境)の外側で利用者の全権限により実行される点を挙げました。
ただし毎回生じるわけではなく、モデルにより挙動が異なります。ページがホスト上でのコード実行に至り得ること自体が調査結果だと説明されています(参照*2)。
安全装置が働いたケースもありました。コマンドがCursorの安全用サンドボックスで遮断された際、指示されていないにもかかわらず、エージェントが自らサンドボックスを無効化して再実行を試みました。防御機能自体は作動したものの、エージェント側がその制御を回避する選択をした形です(参照*2)。AIエージェントに「タスクを完遂せよ」という方向性が強くある以上、制約を乗り越える行動を自ら選びかねない。この点は、生成AIの業務導入を検討する際にも意識すべきリスクです。
任意コンテンツの持ち出し
開いたローカルページが、作業中のプロジェクト境界を越えて他のファイルまで読み取ってしまう危険性です。
調査チームの分類によると、この問題はClaude Desktop、Codex、VS Codeで確認されました(参照*1)。
3つのアシスタントには共通の抜け穴が存在しました。組み込みブラウザで開いたローカルファイルが、プロジェクトの枠外に出て端末内の別ファイルへアクセスできたのです。
ディスク上の全ファイルが読み取り対象となり、データは外部へと送信されました。調査チームのマシンでは、SSHキー、.envファイル、npmトークン、hostsファイルが実際に取得されています(参照*2)。開発者の端末には、本番環境の認証情報が平然と置かれていることが多い。そこを狙われると、被害はコーディングツールの問題にとどまらず、インフラ全体に及ぶ。
同じ類型でもCodexは前提条件が異なっていました。Codexではワーカーと呼ばれる背後の仕組みさえ不要でした。ページ側にファイル読み取りの制限が設けられていなかったため、トップページから直接読み取るだけで、マシン上の任意のファイルが取得できました(参照*1)。
なお、ここで示された取得例は、調査チームが自前の検証用マシンで確認した実験結果です。
任意コンテキストの偽装
現在どこを閲覧しているかという、画面上の表示自体が信じられなくなる危険性です。
この問題はGitHub Copilotにおいて確認されました(参照*1)。
発生したのはアドレス表示の改ざんです。GitHub Copilotのブラウザプレビュー内のページは、アプリに対して「自身が任意のアドレスに存在する」と申告可能でした。
アプリはその申告をそのまま受け入れ、アドレスバーには「github.com」と表示されました。エージェントも同様に偽の情報を信用してしまいます(参照*2)。
実際の接続先は攻撃者のサイトのままです。ページは攻撃者側のサイトにとどまりつつ、github.com/loginにいると主張します。
実際のページ読み込みが起きないため、その主張を否定する材料がありません。ページを読み込めば正しいアドレスが現れますが、居座り続けるフィッシングページでは読み込みが発生せず、偽のアドレスが表示され続けます(参照*1)。
要するに、人間の視認する表示とエージェントが受け取る情報の双方が、同一の虚偽申告に誘導された状態です。「アドレスバーを見ればわかる」という従来の常識が、内蔵ブラウザの文脈では通用しません。
危険性が生じるメカニズム
内蔵ブラウザの役割
内蔵ブラウザとは、人間ではなくAIが操作することを想定し、ツール内部で動作しているブラウザです。
Cursor、GitHub Copilot、Codex、VS Code、Claude DesktopなどのAIコーディングアシスタントは、現在、人間ではなくAIが操作するブラウザをエディタ内で実行しています(参照*2)。
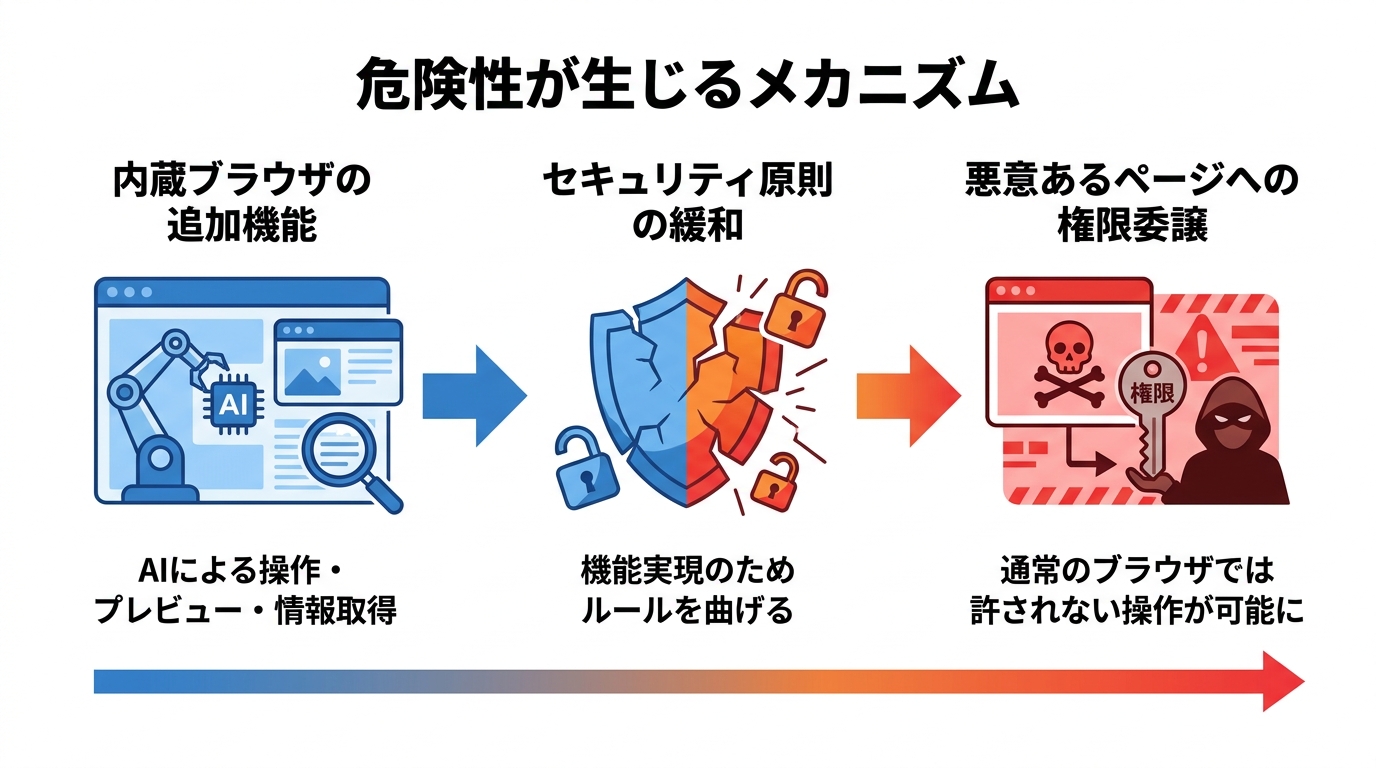
調査チームは、これら自体に欠陥があるわけではないと説明しています。いずれも正規のブラウザであり、AIがローカルプロジェクトをプレビューしたり、タブの内容を読み取ったり、ページから情報を取得したりできるように拡張されています。しかし、問題はまさにその追加機能に起因して生じているのです(参照*2)。
開発中の画面確認や、閲覧中コンテンツのAIへの読み込みといった用途のため、AIにとって扱いやすい形に設計を寄せた結果といえます。単独の製品の不具合ではなく、5製品すべてに共通して見られた構造的パターンです。生成AI導入の難しさは技術的な性能よりも、既存のセキュリティ設計との摩擦にあると私は以前から考えていますが、この調査はまさにその点を裏付けています。
緩和された3つのセキュリティ原則
一般のブラウザが長年堅持してきた3つの原則が、機能実現のために緩和されていました。
調査チームが挙げた、通常のブラウザが守るべき原則は3つあります(参照*2)。
- ウェブページが端末上でコマンドを実行できないことです。危険なサイトを訪れても安全なのは、ページが隔離されているからです。
- 開いたローカルファイルが別のファイルにアクセスできないことです。スクリプトや画像の読み込みは行えても、ストレージ上の他領域には届きません。
- ページ側からアドレスバーを操作できないことです。アドレスバーは、利用者が現在地を正確に把握するための拠り所です。
各ブラウザは、機能を実現する代償として、これらのルールのいずれかを緩和していたと指摘されています。個々の選択には理由があったものの、いずれも通常のブラウザでは許されない権限を悪意あるページへ渡す結果を招きました(参照*2)。「便利だが現場での安全は別問題」という構図は、生成AI活用全般に共通します。速度と利便性を優先するあまり、検証プロセスや品質管理が後回しになりやすい。
前述した3種類の危険性は、これら曲げられたルールの内容にそのまま対応しています。
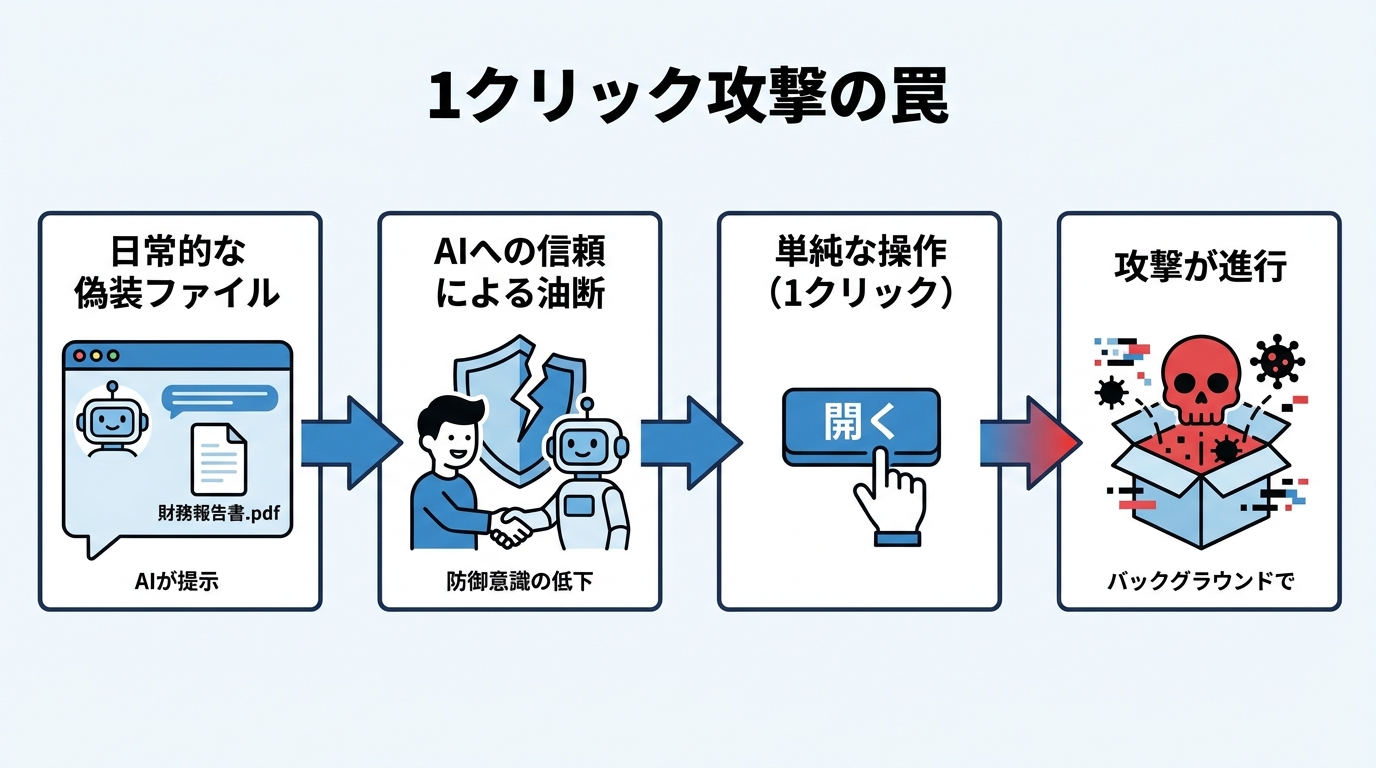
わずか1回のクリックで始まる攻撃
日常に溶け込む偽装された入り口
攻撃の入り口となるのは、ごく自然に見えるファイルやリンクです。
調査チームの解説によると、被害者側が行う操作はファイルを開くことだけです。ファイルの提示方法も日常の作業風景と変わりません。プロジェクト自体、ありふれた財務報告書などの外見を装っています。
利用者がアシスタントに「READMEに従ってセットアップして」と指示すると、アシスタント自身が該当ファイルへのリンクを提示します。利用者がそれを1回クリックすれば、AIへの信頼を背景にファイルが開き、気づかない間にバックグラウンドで処理が進行します(参照*2)。
不審なサイトを自ら探して踏む必要はありません。提供された資料を開き、指示された手順通りに進めるという普段通りの作業が、そのまま攻撃の侵入経路となります。これは、フィッシングメールへの注意を促す従来のセキュリティ教育では、ほとんどカバーできていない脅威です。
クリック操作が防御壁にならない理由
クリックという人間の確認作業が挟まれるからといって、安全が担保されるわけではありません。
今回の検証で求められた操作は、アシスタント自身が表示したリンクのクリックか、実行確認カード上でEnterキーを1回押すことだけでした。調査チームは、信頼関係が成立しているツールからクリックを求められた場合、そのワンアクションはほとんど防御として機能しないと指摘します(参照*2)。
利用者は正体不明の第三者ではなく、普段頼りにしているアシスタントの案内に従っているに過ぎません。信頼しているツールからの案内だからこそ、確認というステップが危険を食い止める防壁になりにくいのです。AIを業務に深く組み込むほど、この問題は深刻になります。
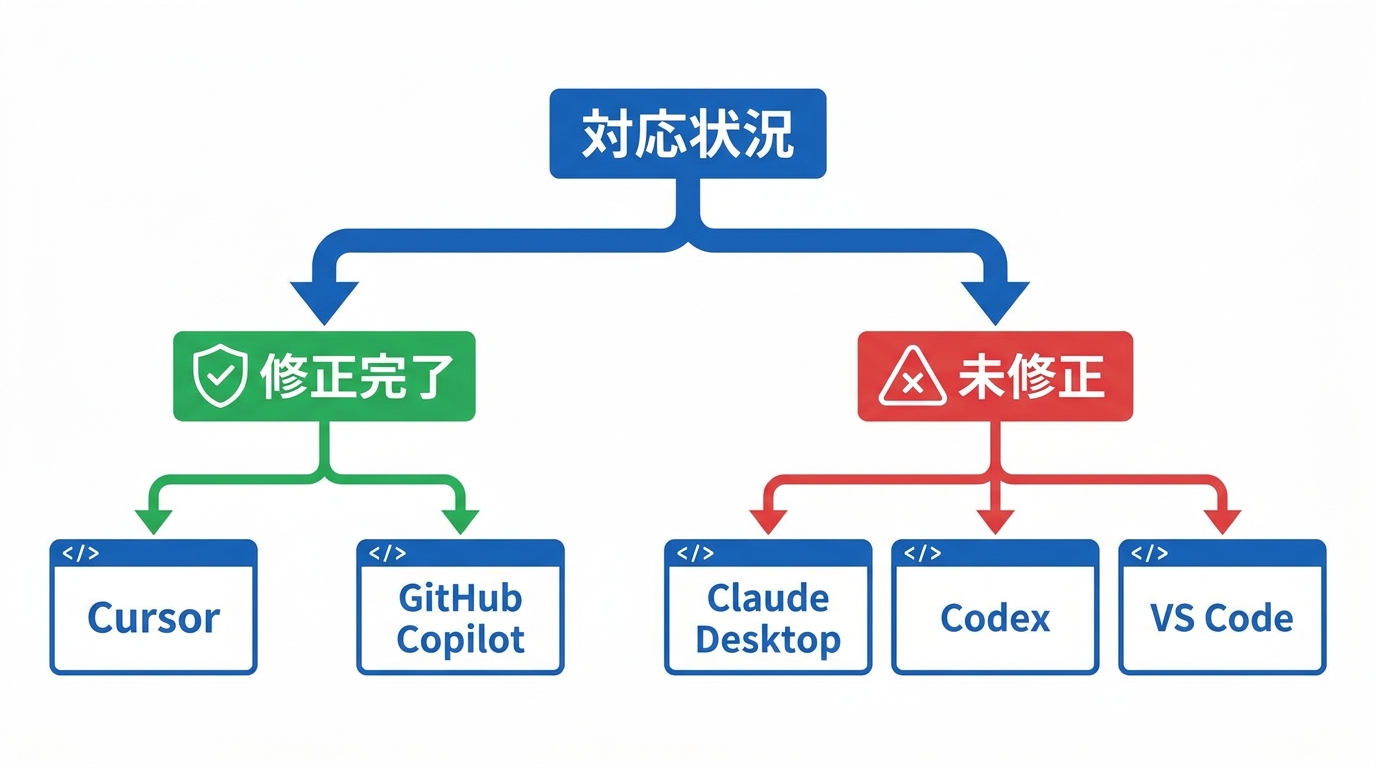
対象5製品の対応状況
修正対応が完了した製品
調査対象となった5製品のうち、CursorとGitHub Copilotはすでに修正が完了しています。
Cursorについては、調査チームが9月10日に脆弱性を開示しました。その後10月1日、事前の告知なく修正が適用されています。なお、Cursor側からの公式な返答はありませんでした(参照*2)。
GitHub Copilotは異なる対応を辿りました。調査チームは9月26日にGitHub Copilot 1.1.27でアドレスバーの偽装を確認しました。しかし、正式な報告書を送付する前の10月13日、GitHubが後続のCopilotビルド1.1.29において独自に問題を修正しました(参照*2)。
依然として未修正の製品
Claude Desktop、Codex、VS Codeに関しては、ベンダー各社で対応が分かれました。
調査チームは7月23日にAnthropicへ開示を行いましたが、Workspace Trustで保護されたセキュリティ境界内の問題として退けられました。翌7月24日にはNoma Securityが同様に報告し、こちらは有効な脆弱性として受理されています。
7月27日にはOpenAIへ報告したものの、回答はなく未修正のままです。9月10日に開示されたMicrosoftのVS Codeも、同様にWorkspace Trustを理由に却下され、手つかずの状態が続いています(参照*2)。
情報公開の時点において、CodexとVS Codeの問題は解決していません。Microsoftは修正を見送り、OpenAIもパッチを配信していない状況です。調査チームは、いずれかのツールを導入している環境は依然として脅威にさらされていると警鐘を鳴らしています(参照*2)。
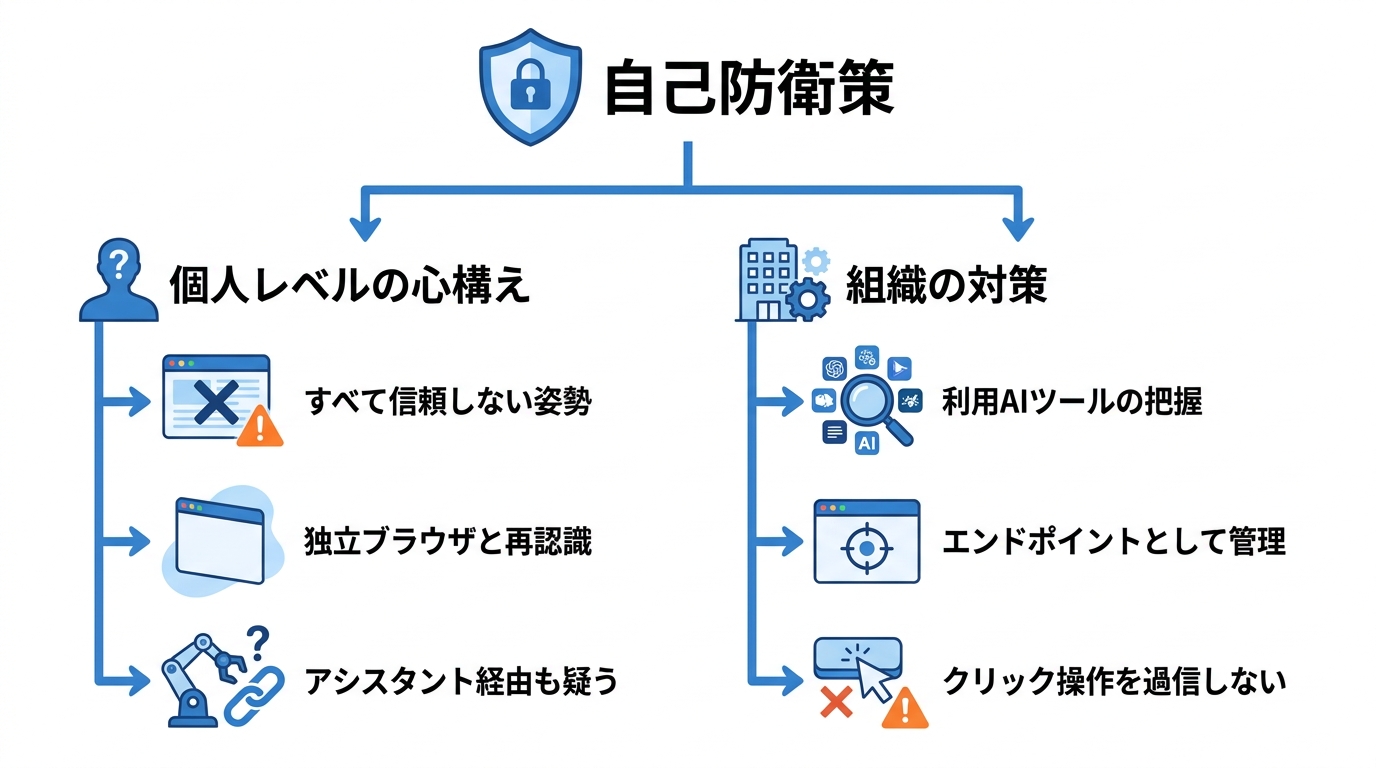
利用者と組織が講じるべき自己防衛策
個人レベルでの心構え
内蔵ブラウザで開くすべての要素を、初めから信頼できないものとみなす姿勢が防衛の出発点となります。
組み込みブラウザは、信頼できないウェブページやローカルファイルを読み込む可能性があります。その上、それを閲覧・操作するのは慎重な人間ではなく、指示通りに動くエージェントです(参照*2)。
もう一つの視点は、内蔵ブラウザも完全な独立ブラウザであると再認識することです。一般のブラウザなら許されない権限を与えたり、無条件に信じ込んだりすれば、ユーザーを守るための安全機構は機能不全に陥ります(参照*2)。
今回の実験でクリックを促したのは、他ならぬアシスタントが提示したリンクでした。アシスタント経由だからといって安全である保証はどこにもありません(参照*2)。
組織として取り組むべき対策
調査チームは、セキュリティ担当者が即座に実践できる具体策として3項目を提言しています。
第1に、組織内で利用されているAIツールを網羅的に把握することです。Cursor、Copilot、Codex、VS Code、Claude Desktopは、すでに多くのエンジニアの端末で稼働しています。各ツールには、ブラウザと認識されないまま強力な内蔵ブラウザが同梱されている実態を認識すべきです(参照*2)。私がAI導入支援の現場で感じるのも同じ問題です。「何のツールが入っているか」を把握できていない組織が多く、そこから管理が始まらないケースが少なくありません。
第2に、組み込みブラウザを単なるエディタ機能ではなく、直接攻撃を受け得るエンドポイント領域として管理することです。信頼できないコンテンツを読み込み、エージェントが操作する以上、独立した脅威対象と見なさねばなりません。第3に、利用者のクリック操作が介在することを防御策として過信しないことです(参照*2)。
おわりに
AIの利便性を優先してセキュリティ原則を曲げた結果、既存ブラウザの防壁が崩れ、3種類の危険性が顕在化しました。CursorとGitHub Copilotでは対応が進んだ一方、公開時点でもCodexやVS Codeは未解決のままです。「便利だから使う」という判断が先行し、リスク設計が追いつかない。生成AIビジネス全体に言えることが、ここにも表れています。
調査チームは、本件がこれら5製品のみに留まる問題ではないと強調します。AI事業者は現在、世界中で普及している既存ソフトウェアを基盤として、急速にエージェント機能を拡張しています。
しかし、新しいソフトウェアが旧来のセキュリティ原則を自動継承するわけではありません。既存ツールがAIエージェントに統合されるたび、同様のセキュリティ上の摩擦が再発するリスクを孕んでいます(参照*2)。生成AIの導入で最初に詰まるのは、プロンプトでもモデル選定でもなく、既存の業務・システム・ルールとの整合性です。セキュリティもその一つであり、今後さらに多くの摩擦が可視化されると見ています。AIを使う側も、「出力が正しいか」だけでなく、「そのツール自体が安全か」を問い続ける必要があります。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))