この記事のまとめ
構造化データを追加すればAIに引用される、とは一概に言い切れません。公開された計測データや公式見解を照らし合わせると、維持する価値がある型と、AI引用への効果が確認されていない型とに分かれます。本記事では、その切り分けや検証の組み立て方、実装と確認の手順までを順を追って整理します。
- 維持する価値があるのはArticle、BreadcrumbList、Organizationの3つです。記事情報、サイト内の階層、組織の情報を機械が解釈できる形で伝えます。
- FAQPageとHowToは検索結果での表示が終了しており、AI検索で利用されているかは公表されていません。
- Ahrefsの調査では、構造化データを追加してもAIからの引用が増加した形跡は見られませんでした。Googleも、AI機能への表示に特別な構造化データは不要としています。
- 自社で検証する際は、対象・期間・プロンプトをあらかじめ定め、本文の修正時期と重ならないようにします。公開前後の確認は、構文、型、実データの3段階で行います。
検証でわかった効いた型と見えなかった型
続ける価値がある3つの型
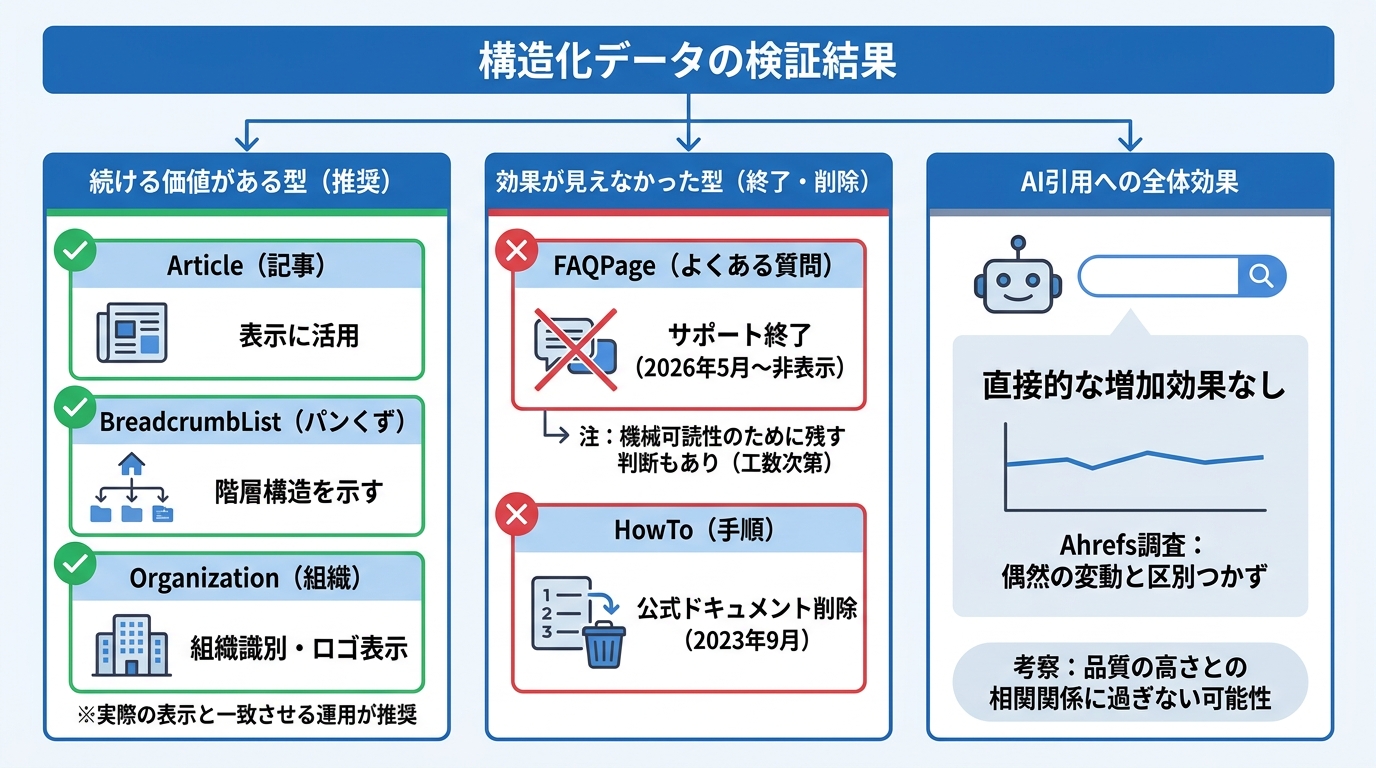
手間をかけてでも維持する価値があるのは、Article、BreadcrumbList、Organizationの3つです。私自身、自社メディア「Books&Apps」の運営を通じて構造化データの実装を見直してきましたが、この3つは検索結果での表示やページの機械的な解釈に直接かかわるため、外せない基本だと考えています。
この3つを適切に維持し、実際の画面表示と一致しているか確認しながら、Search Consoleのレポートで効果を追う運用が推奨されています(参照*1)。これら3つの型が伝える内容はそれぞれ異なります。Articleは記事ページに付与し、見出し、公開日や更新日、画像、著者、発行元を伝えるものです。
必須プロパティはなく、記事の表示に活用されます。BreadcrumbListはトップ以外のページに設定し、サイト内の階層構造を示します。
パンくずリストの表示に用いられ、2025年1月からはパソコンの検索結果のみが対象となります。Organizationはトップページや会社概要ページに配置し、社名、URL、ロゴ、住所、連絡先、外部プロフィールなどを伝えます。
こちらも必須プロパティはなく、組織の識別やロゴ表示などに利用されます(参照*2)。なお、正しく記述してもリッチリザルトの表示が保証されるわけではありません。
Googleは、リッチリザルトテストに沿って正しくマークアップされていても、構造化データが検索結果に表示されることは保証しないと明記しています(参照*3)。
効果が見えなかった型
FAQPageとHowToは、検索結果での表示サポートがすでに終了しています。この判断は早めに下しておくべきで、手作業で更新コストをかけ続ける理由が薄い型です。
FAQのリッチリザルトは2026年5月以降は表示されなくなり、HowToは2023年9月に公式ドキュメントごと削除されました。手動で管理している場合は、保守から外す候補とされています(参照*1)。それでもFAQPageを残す理由として挙げられるのは、質問と回答の組み合わせを機械が切り出せる形で宣言できる点です。
FAQを見出しとして記述しているなら、見出しから自動生成することで工数を抑えられます。実際に、記事末尾の「よくある質問」から自動生成している事例もあります。
ただし、その情報がAI検索で使われているかどうかは公表されていません(参照*2)。つまり、利用されている根拠も利用されていない根拠も、公開情報からは確認できない状況です。継続運用の判断は、手作業で更新し続ける負担に見合うかどうかが分かれ目となります。
AI引用そのものへの効果
構造化データを追加したことでAIの引用が増加したという結果は、外部の調査では示されていません。ここは正直に受け止めておく必要があります。
Ahrefsは、2025年8月から2026年3月の間にJSON-LDを追加した1,885ページを、追加していない約4,000ページと比較した結果を2026年5月に公表しました。追加後にAIからの引用が増加した傾向は見られず、AI Overviewsでは微減(-4.6%)となり、AIモード(+2.4%)やChatGPT(+2.2%)でも偶然の変動と区別がつかない幅にとどまっています。
引用されるページに構造化データが多いのは、サイト全体の品質の高さを映した相関関係にすぎない、というのがAhrefsの考察です(参照*2)。Google公式の説明も同様の方向性を示しています。
AI機能に表示されるために、新たな機械可読ファイルやAI用テキストファイル、マークアップを用意する必要はなく、追加すべき特別なschema.org構造化データもないとしています(参照*4)。現時点で確認できる効果は、Google検索での表示機能やページの文脈理解を助ける範囲にとどまります。単に型を増やせばAI引用が増えるわけではありません。
私がコンサルティング現場でよく見るのは、「構造化データを入れたのにAIに引用されない」という相談です。しかし、そもそも引用を左右するのは構造化データよりも、コンテンツ自体の独自性や信頼性です。型を整えることは必要条件であっても、十分条件ではない。この点を最初に整理しておかないと、実装作業が目的化してしまいます。
前提となる公式の説明
構造化データの役割
構造化データは、ページの内容を標準化された形式で記述し、機械にわかりやすく伝える仕組みです。
Googleは構造化データについて、ページに関する情報を提供し、そのコンテンツを分類するための標準化された形式であると定義しています(参照*5)。記述の形式は指定されています。
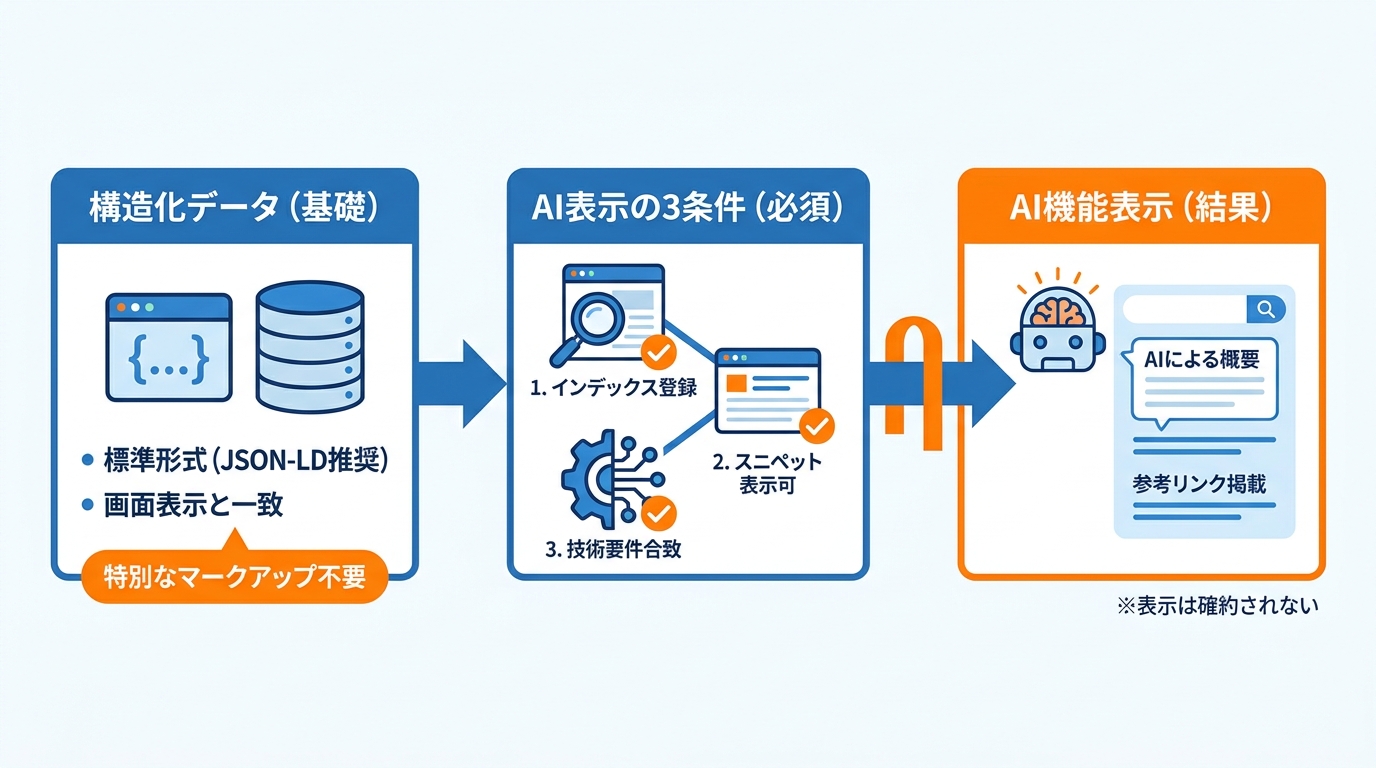
リッチリザルトの対象となるには、JSON-LD、Microdata、RDFaのいずれかでページをマークアップする必要があり、このうちJSON-LDの利用が推奨されています(参照*3)。JSON-LDは、HTML本文とは切り離して情報を整理して記述できる形式です。また、画面表示との一致も重要な原則となります。
Googleは、構造化データがページ上に表示されているテキストと一致していることを確認するよう求めています(参照*4)。
AI機能に表示される条件
AIによる概要やAIモードに参考リンクとして掲載される条件は、公式に3点示されています。
条件は3点で、シンプルです。
- ページがインデックス登録されていること
- スニペット付きでGoogle検索に表示できる状態であること
- 検索の技術要件を満たしていること
Googleは、これ以外に追加の技術要件はないと明記しています。特別なマークアップも要求されていません。これらの機能に表示されるために、新しい機械可読ファイルやAI用テキストファイル、マークアップを作成する必要はなく、追加すべき特別なschema.org構造化データもないと説明されています。ただし、条件を満たしたからといって必ず表示されるとは限りません。Googleは、ページがすべての要件やベストプラクティスを満たしポリシーに準拠していても、クロールやインデックス登録、配信が確約されるわけではないとしています(参照*4)。
検証の設計と測り方
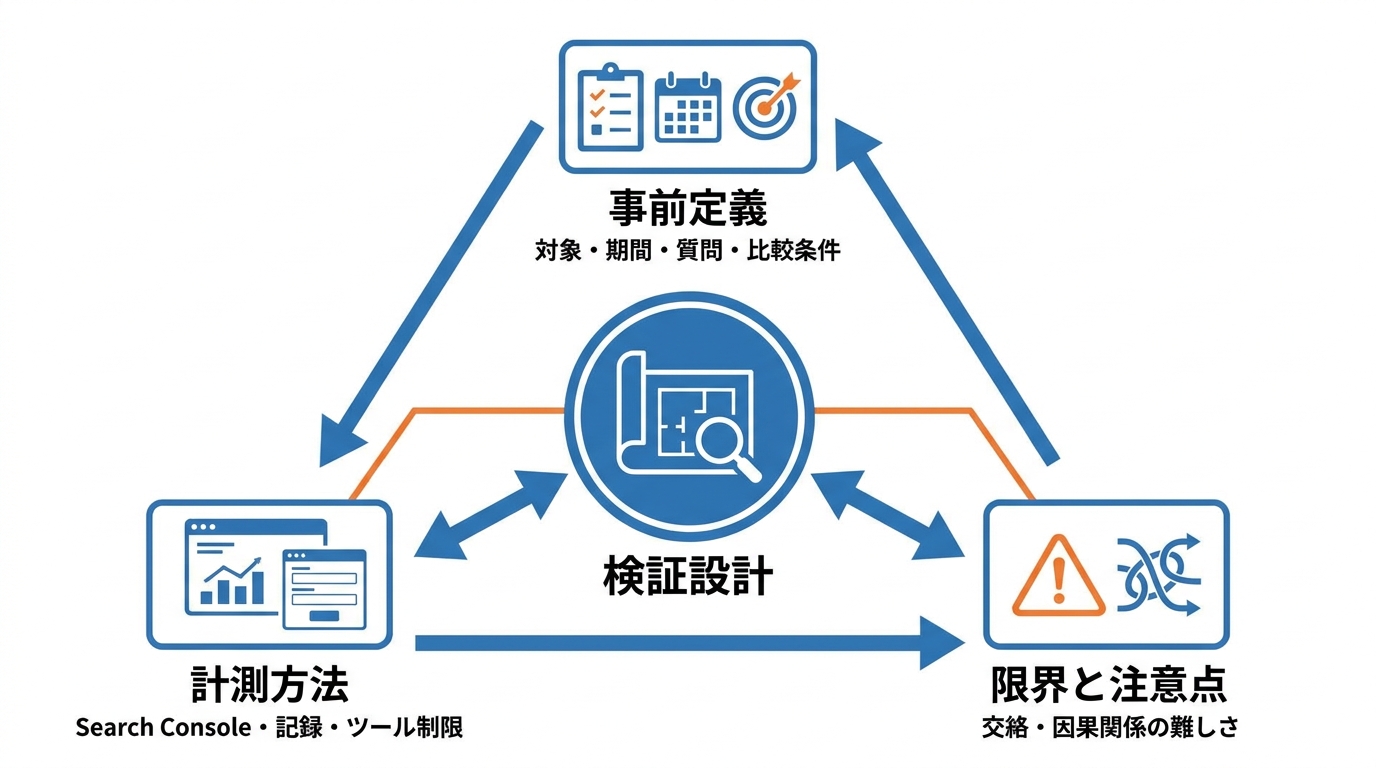
対象・期間・質問の決め方
適切な比較を行うには、検証の対象、期間、質問をあらかじめ決めておくことが重要です。この設計を省いてしまうと、変化が起きても原因を特定できません。
先行研究の設計が参考になります。ある検証では、3トピック×9出版プラットフォームで最適化した記事27本を公開し、公開後最初の7日間(2026年4月)のデータを集計しました。7日間全体で公開後の回答は1,004件、CR(公開した記事が引用先として選ばれた割合)は17.5%[15.3%、20.0%](176/1,004)、MAR(記事の内容が生成された回答に現れた割合)は7.5%[6.0%、9.3%](75/1,004)でした(参照*6)。
質問の投げ方も決められています。同研究では、トピックごとに引用先として優先される3つのプラットフォームへ投稿を1件ずつ公開し、そのうえで10のAI検索プラットフォームすべてに7日間、毎日1回ずつ質問しました。
これによりトピックごとに210件(質問3件×プラットフォーム10件×7日間)、合計2,100件の回答が得られています(参照*6)。比較条件の揃え方の例もあります。
別の研究では各シナリオで事実、価格、仕様、文章の長さ(±5%)を揃え、1つの要因だけが異なる2つのバリアントを組み合わせています(参照*7)。なお、これらは実験的な設計であり、そのまま自社の記事に当てはまるものではありません。
計測方法と小規模検証の限界
計測で把握できる数値と、そこからは読み取れない限界を、あらかじめ区別しておく必要があります。これを混同すると、効果が出ているように見えて実は他の要因だった、という判断ミスにつながります。
AI機能での表示実績は、Search Console全体の検索トラフィックに含まれます。具体的には「ウェブ」の検索タイプにある「検索パフォーマンス」レポートで確認できます(参照*4)。実務上の記録方法としては、構造化データを変更した日と本文を修正した日を記録に残し、90日ごとに表示回数の多い10ページと少ない10ページを比較する手法が示されています。
本文の更新が同時期に重なると、前後比較では区別が難しくなるためです(参照*1)。外部ツールの数値を取り扱う際にも注意が必要です。
Googleの公式ガイドラインは、上位表示を約束したりGoogle内部の指標を用いると主張するツールへの警戒を促しており、外部ツールはGoogle内部のランキングやAIシステムへアクセスできないと明言しています(参照*1)。複数の条件が混在すると因果関係は切り分けられません。
先述の研究も、トピック間比較の設計であるため記事数がトピックの種類やインデックス時期と交絡している点や、各投稿量の条件で異なる架空トピックを異なる時期に公開しており、同一トピックで投稿量を増やしながら観察したわけではない点を限界として挙げています(参照*6)。
私がAI検索の手動監視を始める際に勧めているのは、まず代表的なユーザープロンプトを20〜30本作り、ChatGPT、Perplexity、Gemini、Google AI Overviewといった複数のエンジンで月次確認するところからです。ツールから入るのではなく、自社がどんな質問で引用されているか・されていないかを手で確かめる期間を3ヶ月ほど設けてから、自動化を検討する順序が現実的です。
実装の要点とよくあるミス
記事と組織の情報の書き方
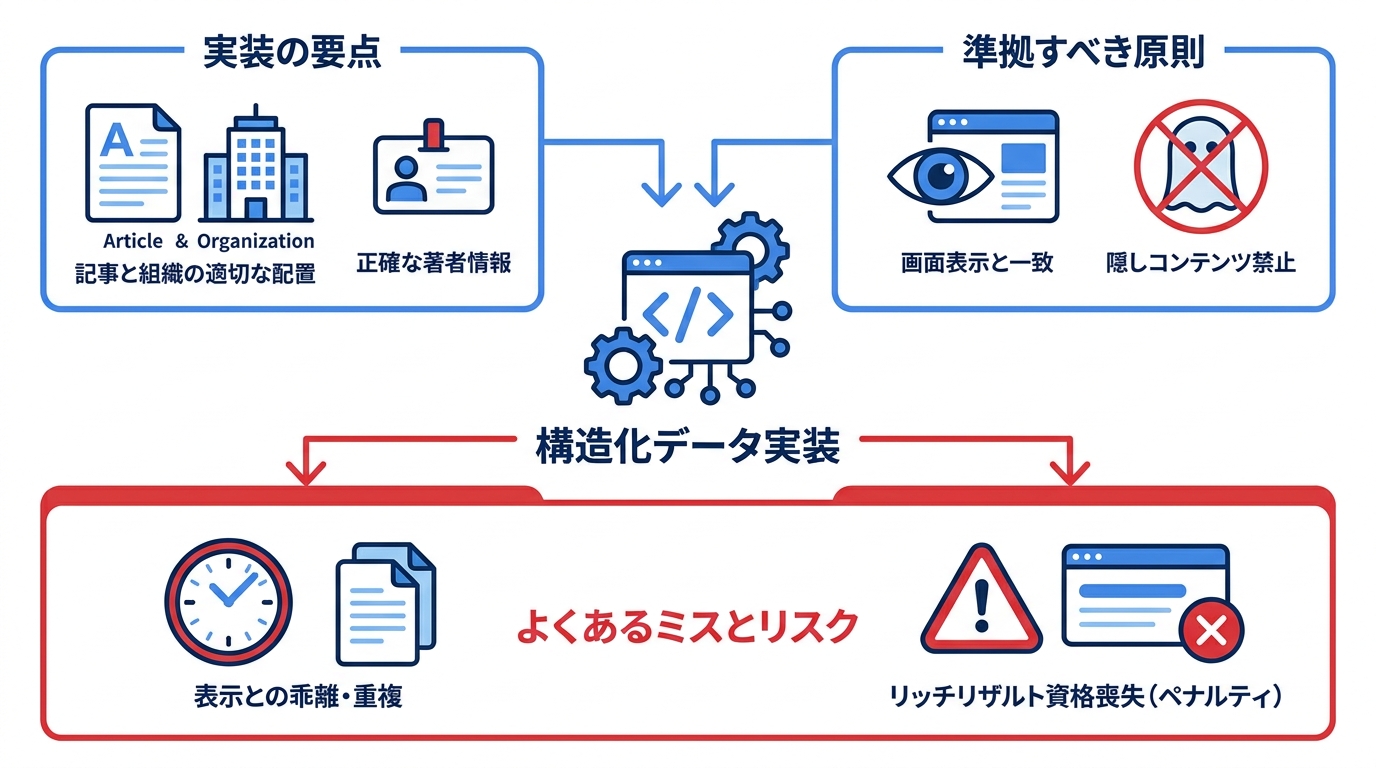
記事側と組織側とで、記述すべき項目や配置する場所が分かれます。
記事のマークアップに必須の項目はありません。Googleはページ理解を深めるため、該当する推奨プロパティをできる限り多く網羅し、実際のコンテンツに応じた項目を追加するよう案内しています(参照*5)。
記事では、見出し、公開日と更新日、画像、著者、発行元といった情報が対象となります(参照*2)。著者情報の書き方には明確な指示があります。著者名の項目には著者の名前のみを指定し、それ以外の情報を付加しないこと。
出版者の名前は発行元の項目を使い、著者の役職は役職用の項目を使うこととされています(参照*5)。組織情報の配置場所も決まっています。
Googleは、トップページ、または「会社概要」ページなど、組織について説明する1つの代表ページへの配置を推奨しており、サイトのすべてのページに含める必要はないとしています(参照*8)。
画面との不一致と重複
現場で頻繁に見られるのは、項目が不足しているミスではなく、画面表示と乖離しているミスです。実装はしているが、メンテナンスが追いついていない状態といえます。
記事サイトで起きやすい乖離は3点です(参照*1)。
- 本文を直したのにマークアップ上の更新日が古いままになっている
- 著者を変えたのに前の担当者名が残っている
- SEOプラグインとテーマの双方がArticleを出力し、同一ページに記事情報が重複している
足りないのではなく、ずれている状態です。準拠すべき原則も明確です。Googleは、ページの読者に表示されないコンテンツをマークアップしないよう求めています。たとえば、マークアップで出演者について説明するなら、HTML本文中にも同じ出演者を記載する必要があります。偽のレビューや主題と無関係なコンテンツなど、誤解を招くマークアップも禁じられています。違反時のペナルティについても公式に書かれています。構造化データに問題があると手動による対策が行われることがあり、これはリッチリザルトとしての表示資格を失うことを意味します。ただし、通常のGoogleウェブ検索におけるランキングそのものには影響しません(参照*3)。
確認ツールと公開後の見張り
公開前の2つのツール
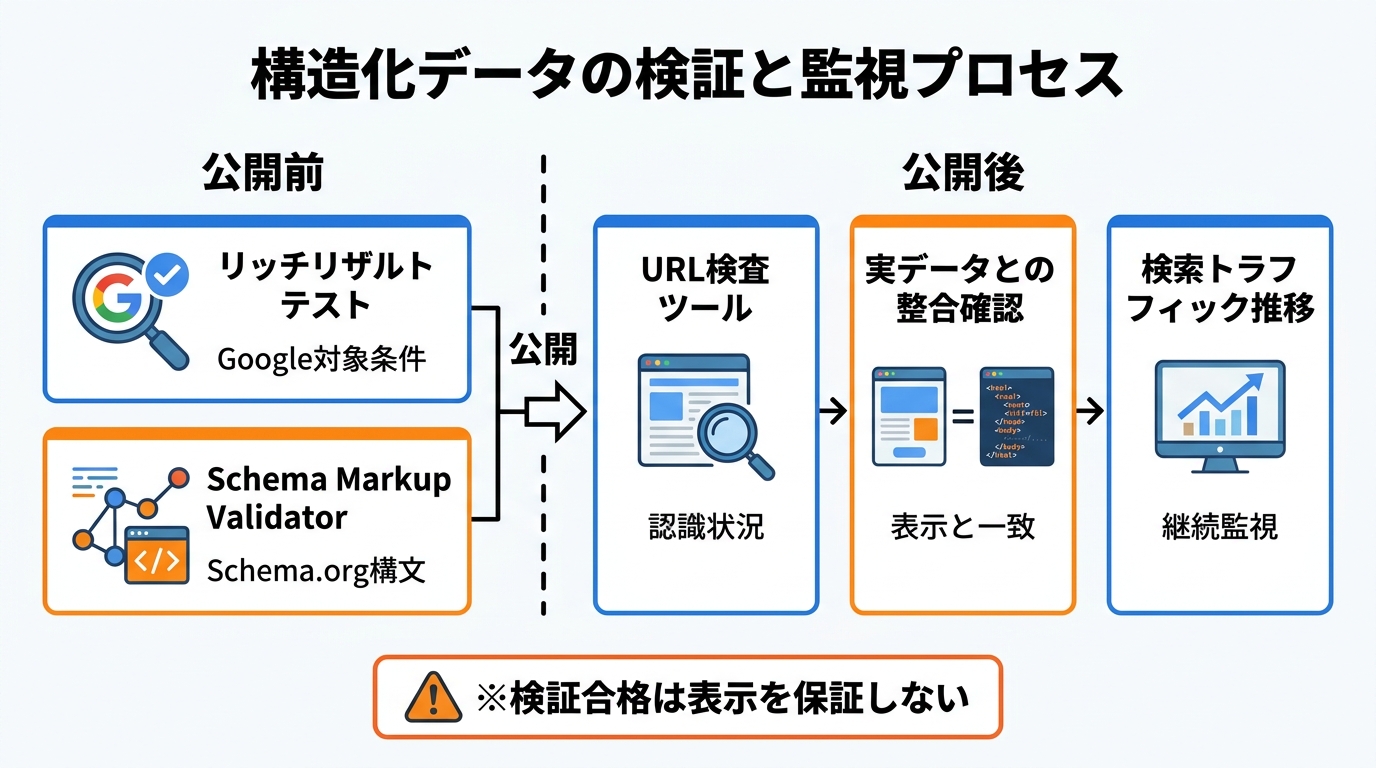
公開前の確認では、検証範囲の異なる2つの公式ツールを使い分けます。どちらか一方だけで済ませると、見落としが生じやすいため、両方を通す習慣にしておくべきです。
リッチリザルトテストは、Googleがリッチリザルト向けにサポートするタイプに照らして検証します。Schema Markup Validatorは、Schema.orgの語彙全体に照らして検証を行います。Google固有の対象条件を確認するならリッチリザルトテスト、JSON-LDがschema.org仕様に沿って構造的に正しいかを確かめるならSchema Markup Validatorを使う、という使い分けで、検証内容が異なるため両方での確認が必要だと説明されています(参照*9)。
Schema.org側ツールで対応できる内容も公開されています。このサービスはウェブページに埋め込まれたSchema.orgベースの構造化データを検証し、JSON-LD 1.0、RDFa 1.1、Microdataのマークアップを抽出します。
抽出した構造化データのグラフ構造を表示し、マークアップの構文エラーを特定します(参照*10)。
公開後に見るレポート
公開したあとは、Googleがページをどう認識しているかと、マークアップの値が画面と合致しているかを確かめます。
Googleは、構造化データを含むページを公開後、URL検査ツールでページの認識状況を確認する手順を案内しています。あわせて、ページがGoogleからアクセス可能であり、robots.txtファイルやnoindexタグ、ログイン制限によってブロックされていないことの確認も求めています(参照*5)。
3段階目となる実データとの整合確認は、自ら行う必要があります。実データとの整合は、値が実際の表示と一致しているかを見るもので、公開後のHTMLソースを取得して照合します。
つまずきやすい点として、テンプレートの固定値、画面にない著者名、階層の食い違いなどが挙げられます(参照*2)。
継続して追う数値としては、AI機能での表示を含む検索トラフィックの推移が、Search Consoleの「ウェブ」検索タイプにある「検索パフォーマンス」レポートで報告されます(参照*4)。
合格しても表示されないとき
テストの検証に通っても、検索結果に表示されないことがあります。これを「バグだ」と捉えると対応に迷いますが、Googleが最初からそう明言していると知っておくと、無駄な調査に時間を使わずに済みます。
Googleは、リッチリザルトテストに従ってページが正しくマークアップされていても、構造化データが検索結果に表示されることを保証しないと明記しています(参照*3)。検証への合格は適格条件を満たしていることの確認にすぎず、実際の表示までは保証されません。表示を決める観点は4点です(参照*9)。
- ページがインデックスに登録されているか
- 検索クエリが表示のトリガーとなるか
- スキーマタイプが該当カテゴリでサポートされているか
- アルゴリズムが表示妥当と判断するか
スニペットの設定も影響します。検索に表示されるページ情報を制限する手段として、nosnippet、data-nosnippet、max-snippet、noindexなどのディレクティブが挙げられています(参照*4)。
おわりに
結論として、Article、BreadcrumbList、Organizationの3つには維持する価値がある一方、FAQPageとHowToは検索での表示サポートが終了し、AI検索での利用も公開情報からは確認できません。また、構造化データの追加によってAIからの引用が増加したという実証データも、外部調査では確認されていないのが実情です。私はこの事実を、「構造化データが意味ない」と読むのではなく、「構造化データだけで解決しようとする発想が間違っている」と読んでいます。
Googleは、AI機能に表示されるための追加の技術要件はないとしつつ、条件を満たしても表示は保証されないとしています。やみくもに型を増やす前に、まずは画面の表示とマークアップが正確に一致しているかを整える。そのうえで、引用されるかどうかはコンテンツ本体の質と独自性で勝負する。公開情報に基づけば、この順序が堅実なアプローチです。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) 株式会社BoostX – 構造化データを入れてますか?AI検索に最適化するスキーマ実装の方法
- (*2) AIO総研株式会社 – AI検索向け構造化データの実装|最低限入れるべき5つの型と、その理由
- (*3) Google for Developers – General Structured Data Guidelines
- (*4) Google for Developers – AI Features and Your Website
- (*5) Google for Developers – Learn About Article Schema Markup
- (*6) From Public Posts to AI-Search Citations: Measuring the Fragility of AI Search
- (*7) What Gets Cited: Competitive GEO in AI Answer Engines
- (*8) Google for Developers – Organization Schema Markup | Google Search Central | Documentation | Google for Developers
- (*9) Squin Research – 2026 Eligibility & Validation Guide
- (*10) Validator – Schema.org