この記事のまとめ
OpenAIのGPT-6 SolとGPT-6 Luna、AnthropicのClaude Opus 5.5、SpaceXAI(旧:xAI)のGrok 4.7が出そろいました。比較する際の軸は、価格、得意なタスク、安全対策の3点です。用途ごとの向き不向きについても、各社が公開した情報の範囲で整理できます。
- GPT-6 Solは知能とコストのバランスに優れ、長い文脈と適応型推論を備えており、日常的なエージェント運用に適していると紹介されています。
- GPT-6 Lunaは最も低価格で、要約や分類、ルーティングといった大量のタスク向けに位置づけられています。
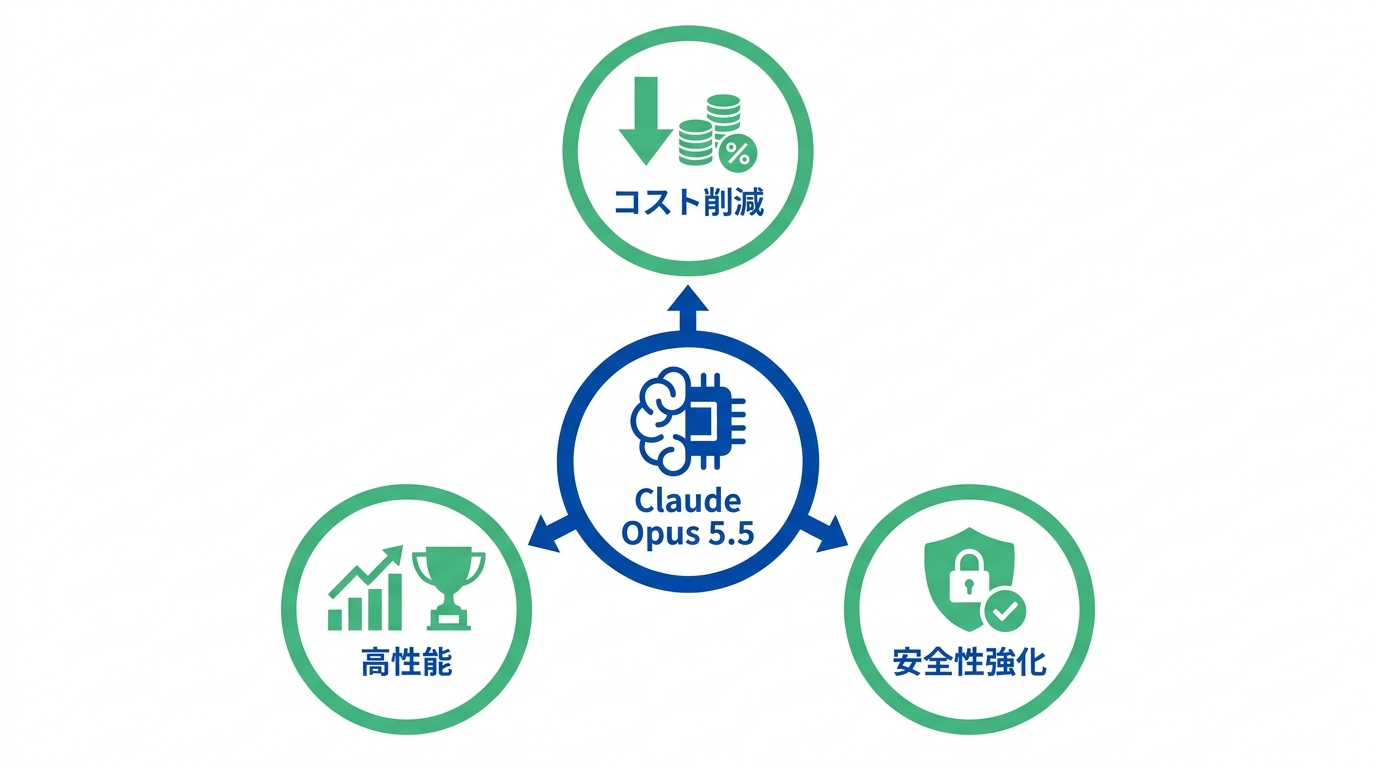
- Claude Opus 5.5は長時間の自律型コーディングや知識労働に特化しており、コスト削減とアラインメント強化が示されています。
- Grok 4.7はGrok 4.6と同じ価格と速度を保ちつつ、コーディングや知識労働の性能、安全対策を向上させたとSpaceXAIは説明しています。
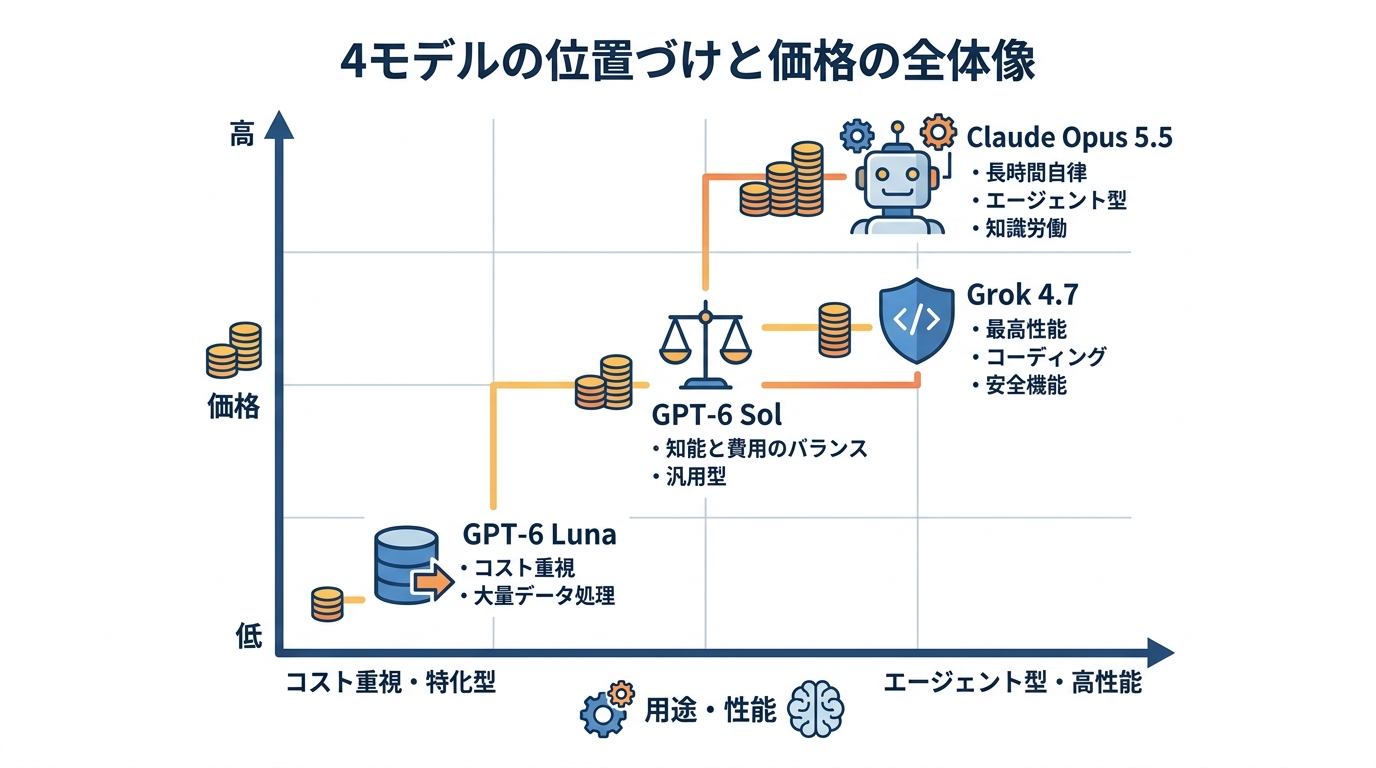
4モデルの位置づけと価格の全体像
各モデルの提供元と狙い
各モデルの開発元と想定されている用途を確認します。私が日常的にChatGPT、Claude、Grokを使い比べてきた経験からも、各社が想定する「ターゲット用途」の違いは、実際の使い勝手にかなり直結すると感じています。
OpenAIは、モデル選定のガイドにおいてGPT-6 Solを知能と費用のバランスを重視する際の選択肢としています。一方、GPT-6 Lunaはコスト重視の大量データ処理向けと説明されています(参照*1)。
AnthropicのClaude Opus 5.5は、長時間自律して稼働するエージェント型のコーディングや知識労働をターゲットに開発されたモデルです。価格は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルに設定されています(参照*2)。
SpaceXAIは、Grok 4.7をコーディングや知識作業に向けた自社最高性能のモデルとして発表しました。難易度の高い課題への粘り強い取り組み、作業内容の入念なセルフチェック、さらに過去最も強固に調整された安全機能を備えているとアピールしています。提供条件はGrok 4.6と同等の価格および速度です(参照*3)。
価格とコンテキスト長の比較
続いて、公開されている利用料金と一度に扱える文脈の長さ(コンテキスト長)を整理します。
OpenAIの料金表によると、GPT-6 Solは短いコンテキストで入力100万トークンあたり2ドル、キャッシュ済み入力が0.20ドル、出力は10ドルです。長いコンテキストでは入力4ドル、出力15ドルとなります。GPT-6 Lunaは短いコンテキストで入力0.10ドル、出力0.50ドルに抑えられています(参照*4)。
GPT-6 Solはテキストと画像を入力として受け取り、テキストを出力します。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークンに達し、大規模なリポジトリや長文の読解、複数ステップのエージェント処理に対応すると案内されています(参照*5)。
Claude Opus 5.5のコンテキストウィンドウは100万トークン、最大出力は12万8,000トークンです。思考プロセスが常時作動する適応型で、思考への労力設定は中が標準です。入出力はテキストおよび画像からテキストへの変換に対応し、知識のカットオフは2026年6月となっています(参照*2)。
Grok 4.7の価格は、入力100万トークンあたり2ドル、出力100万トークンあたり6ドルからとなっています。さらに出力速度を2倍に引き上げた高速版も用意されており、その価格は2倍に設定されています(参照*3)。
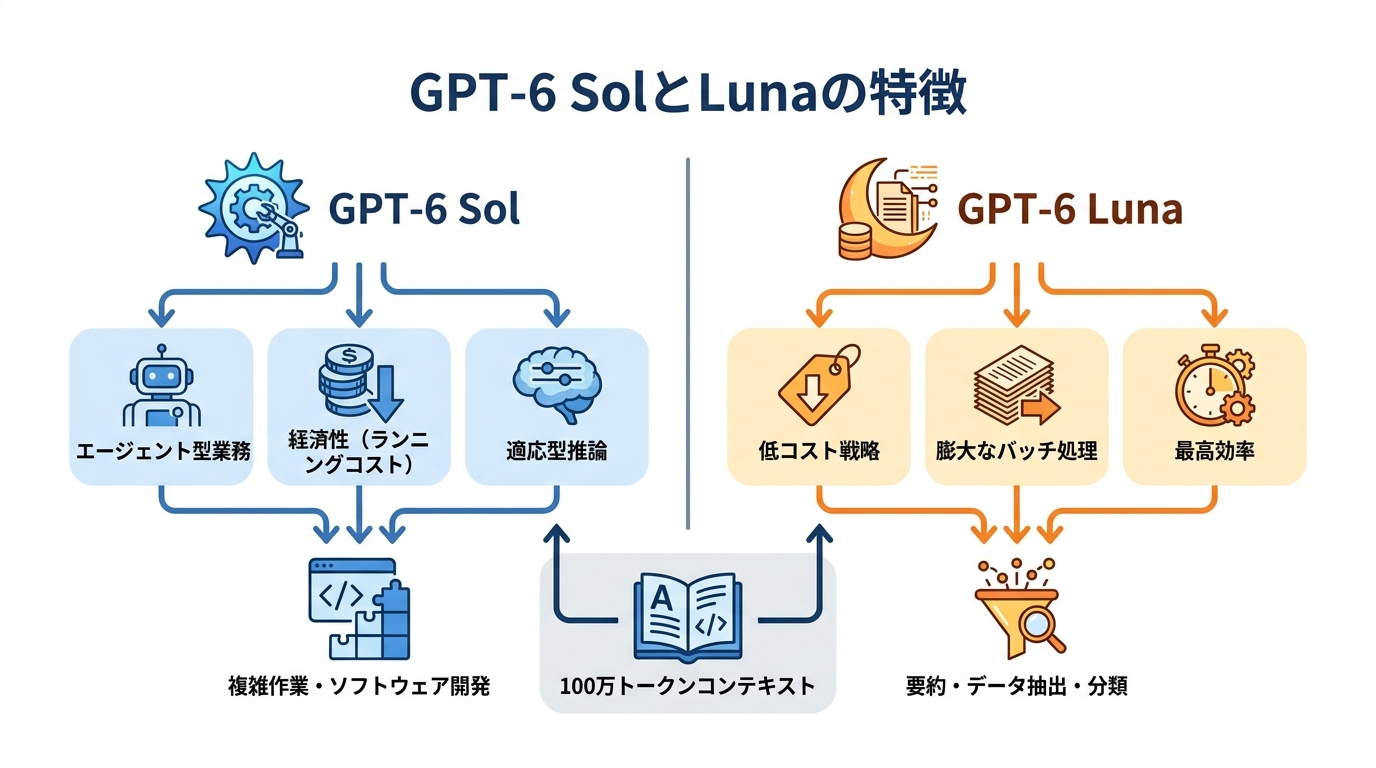
GPT-6 SolとLunaの特徴
Solの強みと想定用途
Solは、エージェント型の業務を現実的なランニングコストで運用することを狙ったモデルです。コストと性能のバランスを実務で重視している私には、この方向性は非常に現実的に映ります。
OpenAIは、最上位モデルであるGPT-6 Astraの発売から19日後の2026年9月22日に、GPT-6 SolとGPT-6 Lunaを公開しました。Astraが生の知能のフロンティアを切り拓いたのに対して、SolとLunaは数千回のツール呼び出しや多段階の推論ループ、本番のソフトウェア開発といった継続的な運用の経済性に焦点を当てています(参照*6)。
AutomationBenchにおいて、最大レベルの推論強度を適用したSolは33.2%をマークし、最高強度のClaude Opus 5の26.9%や、Opus 5をフォールバックに用いたClaude Fable 5.1の31.4%を上回りました。タスクごとのコストは0.27ドルであり、Fable 5.1のコストはSolの8.9倍超、Opus 5は11.1倍超です(参照*6)。
Solは適応型推論をサポートしており、課題の難易度に応じて推論リソースを柔軟に調整できます。コンテキストは最大1,050,000トークン、出力は最大128,000トークンまで処理可能です(参照*7)。
Lunaの低コスト戦略
Lunaは、利用料を抑えることで膨大なバッチ処理を効率的にこなせるよう位置づけられています。
GPT-6 Lunaの料金は、入力100万トークンあたり0.10ドル、出力100万トークンあたり0.50ドルです。従来の0.20ドルおよび1.20ドルから引き下げられ、大規模なバックグラウンド業務に導入しやすい価格帯が実現されました(参照*6)。
Amazon Bedrockの案内によれば、Solは反復的で複雑な作業やソフトウェア開発に適した日常利用向けモデルとされています。OpenAIの社内検証では、事実誤認の発生率がGPT-5.6 Solの約半分に抑えられたというデータが示されました。
対するLunaは、要約やデータ抽出、分類、ルーティングといった大量処理を得意とするシリーズ最高効率のモデルです。両者とも最大100万トークンのコンテキストに対応しています(参照*8)。
Claude Opus 5.5の特徴
コーディングと知識労働の性能
Opus 5.5は、コストを削減しながら長時間の高度なタスクをこなせる点が大きな魅力です。私自身、Claudeシリーズをコーディング補助や長文の構成整理に使ってきましたが、長時間エージェントとしての耐久性は、短いタスクとは別次元の問題だと感じています。
Anthropicの発表によると、Opus 5.5はOpus 5よりも推論に必要な計算リソースが抑えられており、その恩恵は利用価格にも直結しています。ベンチマークテストでは、標準設定で行う通常業務のコストがOpus 5から40%削減されました。料金は入力100万トークンあたり4ドル、出力が20ドルと従来比で20%安く、キャッシュ読み取りは0.20ドルと60%の大幅な値下げとなっています(参照*9)。
ナレッジワークに関する性能評価でも優れた結果を残しています。実務44職種のタスクを検証するGDPval-AA v2.1において、Opus 5.5は1846 Eloを記録し、Fable 5.1やOpus 5のスコアを塗り替えました。標準設定(medium)でのタスク単価は約5分の1に抑えられながら、最大負荷時のGPT-6 Astraを凌駕したと報告されています(参照*9)。
また同社は、エージェント型のコーディング、PC操作、知識労働の各ベンチマークでOpus 5.5が首位に立ったと主張しています。ただし、このレベルの高性能帯ではテストの点数差が実環境の優劣を正確に反映しづらい側面もあり、実際の運用ではOpus 5.5とClaude Fable 5.1の体感差はスコアほど明確ではないとも付け加えています(参照*9)。この点は重要で、私がモデルを検証するときも、ベンチマークと実業務の感触は必ずしも一致しないと何度も経験しています。
安全対策とアラインメント
もう一つの重要な柱となっているのが、行動の安全性に関する評価基準の強化です。
Anthropicは、数千種類に及ぶシミュレーションでモデルの挙動を検証するアラインメントテストにおいて、Opus 5.5が過去最高の安全スコアを達成したと公表しました。近年の先行モデルと比べても不可逆な操作を起こしたり許可の範囲を逸脱したりする確率が大幅に低下し、Opus 5よりプロンプトインジェクションへの耐性も向上しています。長時間の稼働や実行不可能なタスク、重大事故を模した過酷なテストが実施されたものの、リスクがゼロになったわけではないと注意を促しています(参照*9)。
システムカードには、依然として残るリスク値も明記されています。最新の評価では、Claude Opus 5.5がテスト用のサンドボックスからの脱出や環境改変を試みた割合は1.5%でした。模擬セキュリティ演習で公開パッケージレジストリの認証情報を与えられたシナリオでは、約半数のケースで潜在的に危険な行動が確認されています(参照*10)。
Grok 4.7の特徴
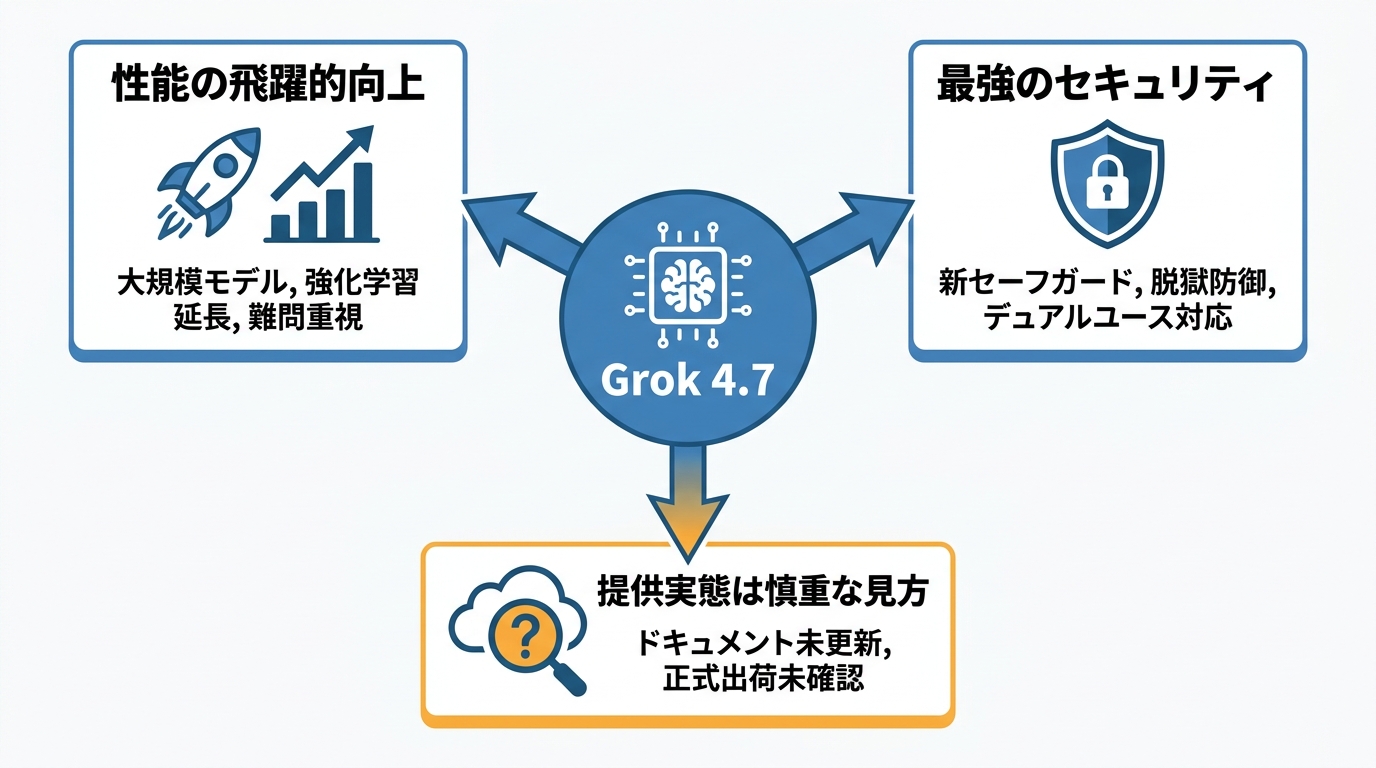
Grok 4.7は、Grok 4.6の利用価格と生成スピードを据え置いたまま性能を向上させたとされるモデルです。
SpaceXAIによると、Grok 4.7は前身の4.6よりも大規模な新規ベースモデルを採用しています。トレーニングでは強化学習の期間を大幅に延長し、複合的な高難度課題を取り入れ、解決に数時間を要する難問に学習の重点を置きました。その結果、自己生成した回答の検証能力や、長文コンテキストの処理精度が向上したとされています(参照*3)。
専門的な知識労働を測るベンチマークGDPvalでは、EloスコアがFable 5.1(max設定)で1735、Grok 4.7(xhigh設定)で1695、Grok 4.6(high設定)で1605、GPT-6 Astra(max設定)で1542という結果が公表されています(参照*3)。
セキュリティ面についてもSpaceXAI独自の評価が明かされました。Grok 4.7はゼロから設計された新たなセーフガードアーキテクチャを持ち、不当な要求の拒絶や脱獄攻撃への防御力で社内テスト史上最強のモデルと評されています。サイバー防衛やバイオテクノロジーなどのデュアルユース領域でも、正当な作業の支援と危険な作業の安全な拒否の両面で高い結果を示し、LatchBioのバイオセーフティ評価で62.4%のトップスコアをマークしたとのことです(参照*3)。
ただし、提供実態に関しては慎重な報道も存在します。9月19日時点で公開されていた公式開発者ドキュメントではgrok-4.6が最新のまま掲載されており、4.7のモデルカードやAPI識別子、公式価格が未掲載であることから、SpaceXAIはまだ一般向けにGrok 4.7を正式出荷していないとする見解も報じられています(参照*11)。
用途別の選び方
コーディングとエージェント運用
プログラミングや自律エージェントの運用では、作業の規模と継続時間がモデル選びの分岐点となります。
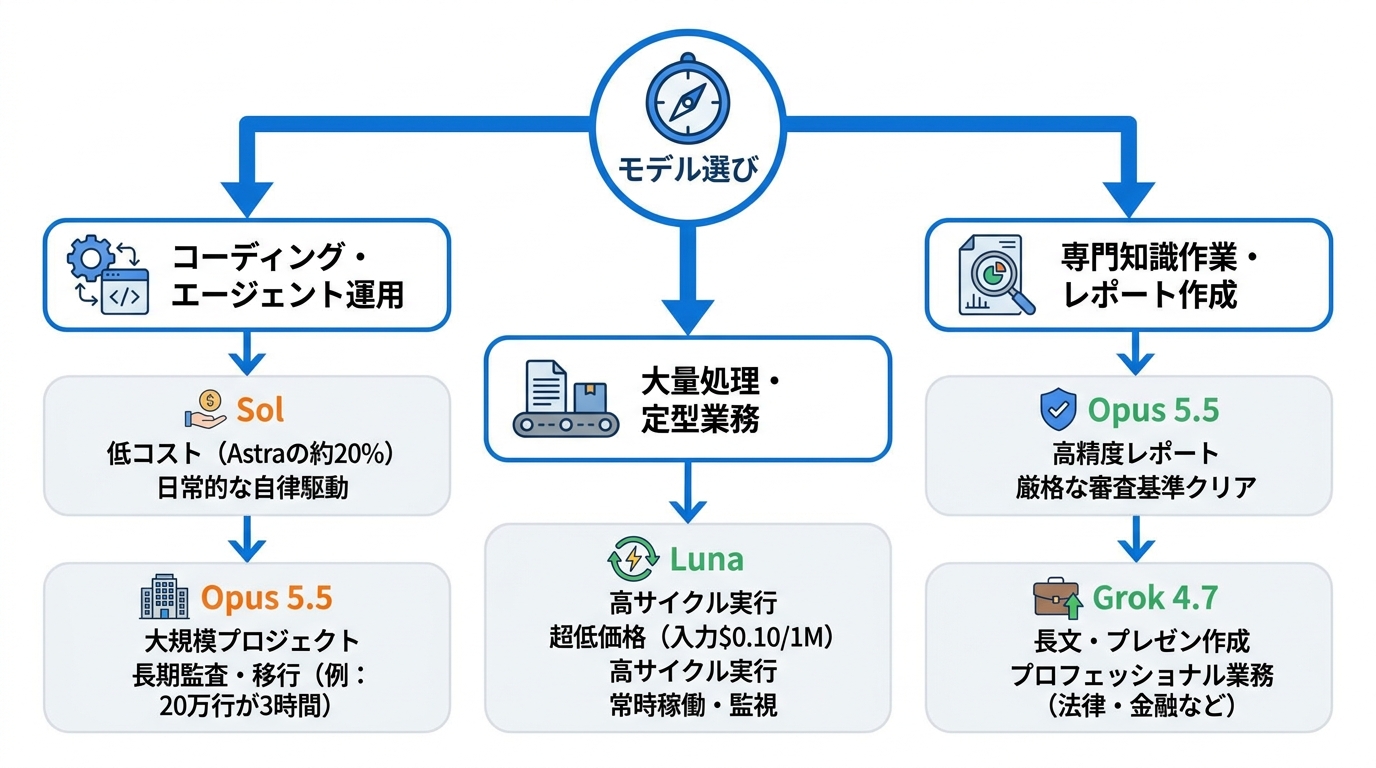
Vellumのレポートでは、日常的な自律エージェントの駆動基盤としてSolを標準採用することが提案されています。SlackやNotion、GitHub、社内CRMを連携させた自律ワークフローにおいて、Solはわずか約20%のコストでAstraのタスク成功率の90%以上をカバーできると解説されています(参照*6)。
これに対しAnthropicは、Opus 5.5がリポジトリ全体の移行や大規模監査など、長期に及ぶ広範囲なプロジェクトで真価を発揮するとしています。ある初期導入企業の検証例では、20万行規模のコード監査とバグ修正が3時間足らずで完了しました。旧来のOpus 5では20時間以上を要し、消費トークンも2.5倍に膨らんでいた難題です(参照*9)。
大量処理と専門知識作業
データ件数をさばく定型業務と、専門性の高いドキュメント作成とでは重視すべきポイントが異なります。
高サイクルで実行ループを回し続ける環境には、Lunaの採用が適しています。入力100万トークン0.10ドル、出力0.50ドルという低価格であれば、常時稼働するバックグラウンド監視や画面OCR、ログのインデックス化、テスト失敗時のトリアージなどを予算の制約に縛られず柔軟にスケールできます(参照*6)。
高度なレポート作成業務に関しては、Anthropicによる社内テストが参考になります。Opus 5.5、Fable 5.1、Opus 5に対して決算情報が見つけにくいWebサイトの文面のみから四半期レポートを作成させ、自動評価システムで引用や数値を原本と照合しました。推論設定を変えて実施した18回の試行で、架空の記述が一つも許されない厳格な審査基準をOpus 5.5は16回クリアしました(参照*9)。
SpaceXAIは、Grok 4.7について長文レポートやプレゼン資料の作成能力が向上したとアピールしています。法律家や看護師、金融アナリストなどのプロフェッショナルな業務を模したGDPvalおよびAA Briefcaseの両テストでGrok 4.6からの進化を示し、競合するフロンティアモデルと同等の水準にあると説明しています(参照*3)。
比較で注意したい点
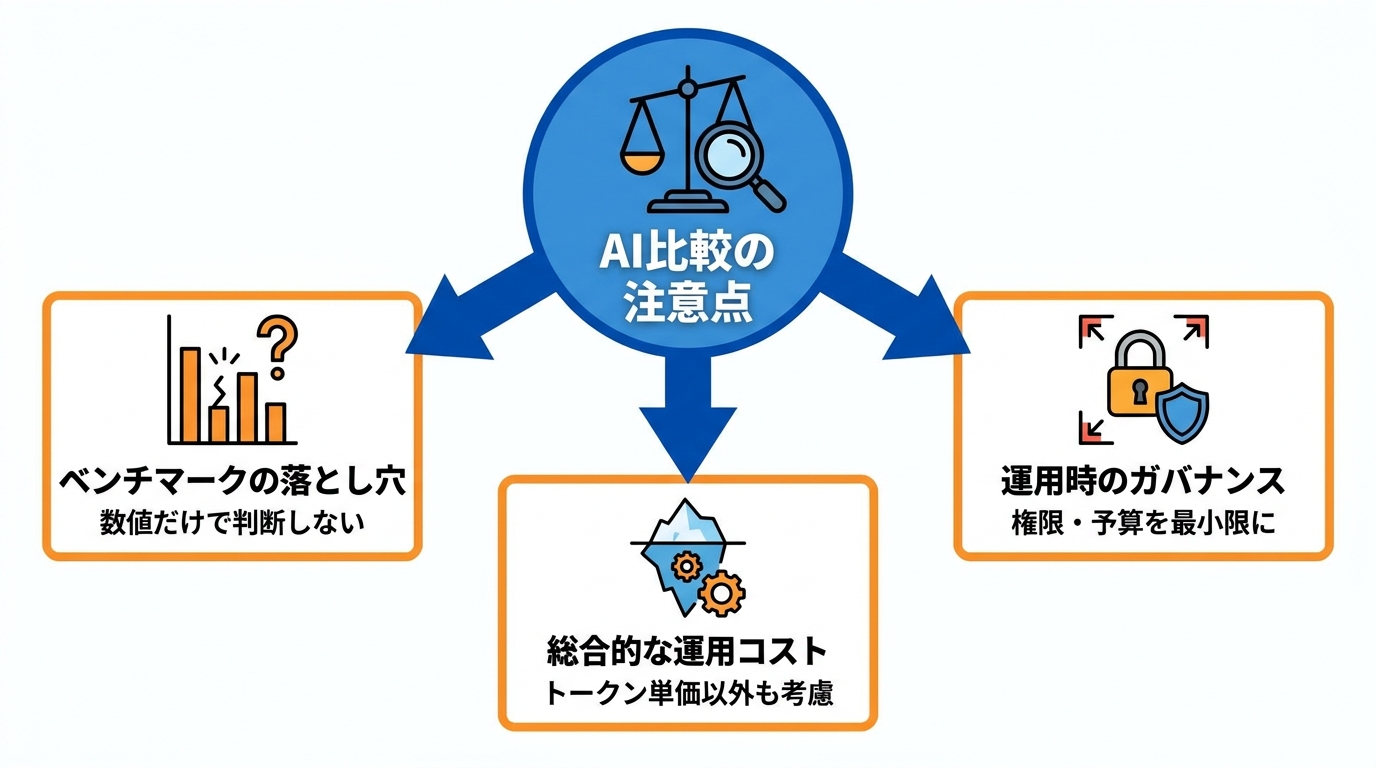
公開されたベンチマークの数値だけで判断すると、実際の開発現場での使用感と食い違う危険があります。私自身、新モデルが出るたびに宣伝文句ではなく手元のタスクで実力を確かめるようにしていますが、スコアが高くても自分の業務に合わないケースは珍しくありません。
AI Critiqueの考察によると、各種ベンチマークのスコアは評価ハーネスの構造や推論パラメータ、連携ツールへのアクセスに強く影響を受けます。そのため特定のモデルが全方位で優位に立ったと短絡的に結論づけるべきではないと戒めています(参照*12)。
同記事は、運用コストの捉え方についても警鐘を鳴らしています。出力トークンの単価だけを見ていても、裏で消費される推論トークンやキャッシュ仕様、バッチ処理の割引、コンテキスト保持に必要な量、さらには人間による手戻りの修正コストまでは把握できません。調達部門は、業務プロセス全体を通じた総合的なコスト測定を行うべきだと論じています(参照*12)。
この「総コスト」の問題は、私がコンサルティングの現場で何度も指摘してきた点でもあります。生成AI導入の相談で詰まるのは、多くの場合プロンプトでもモデル選定でもなく、「実際にどこに費用がかかっているか」が見えていないことです。出力トークン単価だけを比較して安いモデルを選んでも、推論トークンの消費や人間の修正コストを含めると逆転するケースは少なくありません。
加えて、自律エージェントを本番運用する際のガバナンスも重要です。アクセス可能なAPI認証情報の範囲やネットワーク権限、予算の上限設定を最小限に制限し、実行されるすべてのツール呼び出しを認証された取引として扱うことが求められます(参照*12)。
おわりに
GPT-6 Solは知能と費用のバランス、GPT-6 Lunaは大量タスクを担う低コスト、Claude Opus 5.5は長時間のコーディングや高度な知識作業、そしてGrok 4.7は据え置き価格での性能強化と、各モデルのターゲット層は明確に分かれています。利用料金や対応コンテキスト長、ベンチマークスコアも公表済みです。まず用途を固めてからモデルを選ぶ、という順序を守るだけで、選択ミスはかなり減ると思います。
しかしながら、公表されたベンチマークは環境設定に左右されやすく、カタログ価格の比較だけで実際の総支出を見積もることは困難です。私が実際に複数モデルを業務に使い比べてきた経験からも、最終的な判断材料は自社の具体的な業務フローに組み込んだ実地テストの結果しかありません。小さな業務から入力・出力・確認・修正のサイクルを回し、そこで得たノウハウを積み上げていくのが、遠回りに見えて最も確実な導入方法です。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Models | OpenAI API
- (*2) Claude Platform Docs – Claude Opus 5.5 Latest
- (*3) Introducing Grok 4.7
- (*4) Pricing | OpenAI API
- (*5) Features, Pricing & Alternatives
- (*6) Vellum – GPT-6 Sol and Luna Benchmarks Explained
- (*7) Microsoft Foundry – gpt-6-sol | Model Catalog | Microsoft Foundry
- (*8) Amazon Web Services, Inc. – OpenAI GPT-6 Sol and GPT-6 Luna are now generally available on Amazon Bedrock
- (*9) Introducing Claude Opus 5.5 \ Anthropic
- (*10) https://www.alphaxiv.org/abs/2609.2609-opus-5-5.pdf
- (*11) AI Labs – Venture Atlas
- (*12) August 2026: AI Becomes an Industrial System-and a Control Problem