この記事のまとめ
Z.aiのコーディングエージェント「ZCode」が、ログイン中に作業中のワークスペースをまるごと暗号化し、クラウドへ送ろうとしていた問題です。きっかけは1人の開発者がディスクの中身を調べたことでした。この記事では、何が起きたのか、設定で止まらなかった理由、智譜(Zhipu)の是正、そして導入前に見る5つの観点を整理します。
- ある開発者のワークスペースから42,411個のファイルが313MBの暗号化アーカイブにまとめられ、Alibaba Cloudへの送信が564回試みられて失敗しました。
- アーカイブの86.6%は.gitディレクトリで、過去のコミットやLFSキャッシュ、reflogまで含まれていました。
- 2つのプライバシー設定は学習利用とサーバー側の索引だけを制御し、収集と送信は止まりませんでした。
- 智譜はv3.14.0で機能を削除し、第三者機関がバケットのデータ削除を確認しましたが、公開リポジトリはコミット2件で当時の実装は追えません。
無断アップロードで起きたこと
313MBのアーカイブの発見
発見のきっかけは、ディスクの中にあった見慣れない巨大なファイルでした。開発者でなければ気づかなかった可能性が高く、逆に言えば、多くのユーザーは気づかないまま使い続けていたかもしれません。
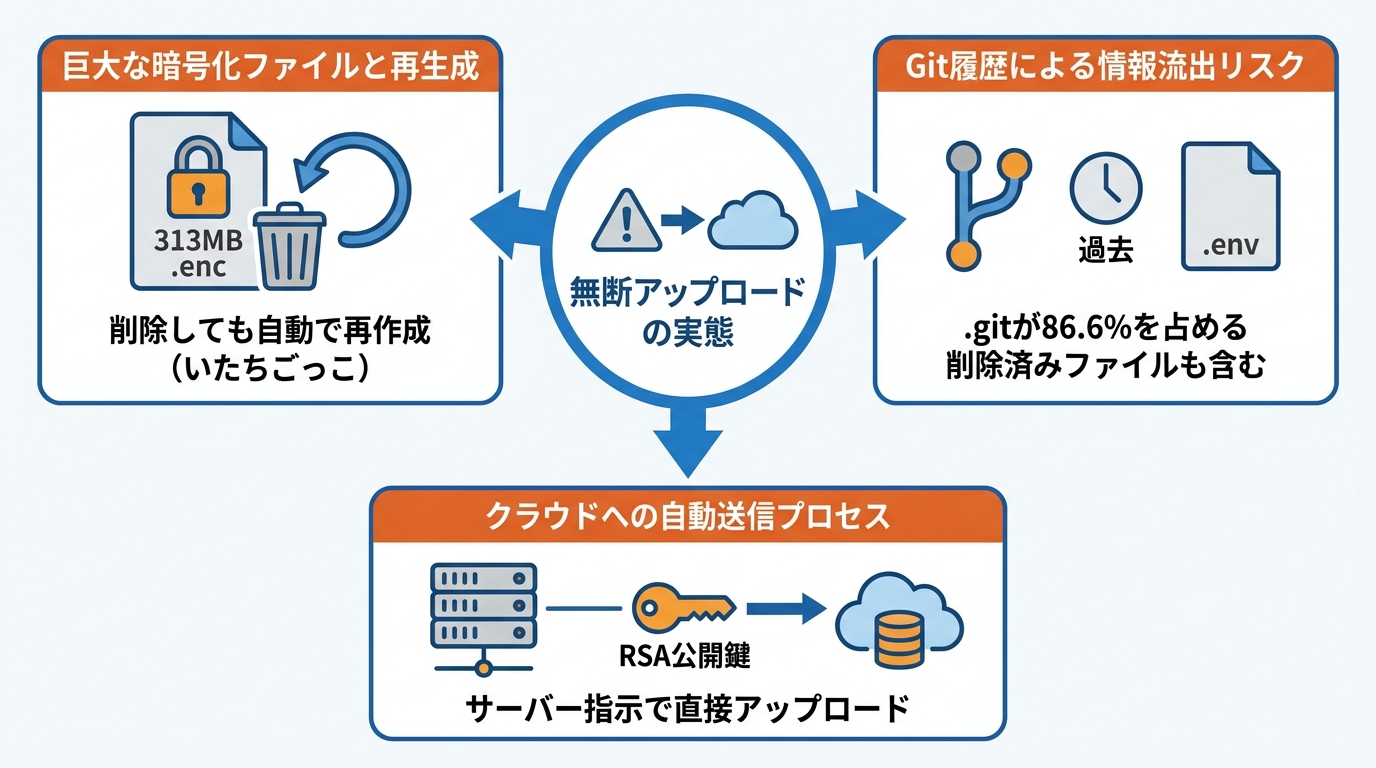
開発者のferstarは、v2/checkpoints/の中に313MBの.encファイルと状態メタデータファイルを見つけました。状態ファイルには、対象が商用プロジェクトのパスであること、暗号化後のサイズが313,070,842バイト、ワークスペースのサイズが345,549,173バイトであること、種別がbaseline、failureCountが564であることが記録されていました。クライアントはnode_modulesなど一部を除いて商用プロジェクトをスキャンし、残りの345MBをbaselineというラベルの暗号化アーカイブにまとめていました(参照*1)。
手で消しても、同じものが作り直されました。ferstarが保留中のパッケージを削除すると、30分もしないうちに再取得が走り、再試行カウンターが564から565へ進んだ新しい313MBのアーカイブができました。アップローダーはファイルが無くなると新しいファイルをまとめ直すため、手動削除はいたちごっこになります(参照*1)。
ただし、見落とされやすい点もあります。この313MBのアップロードは失敗しており、プロジェクト全体が流出した証拠ではないと指摘されています(参照*2)。「送ろうとしていた」と「送れた」は別の話です。この区別は冷静に保つべきですが、だからといって問題が軽いわけでもありません。
中身の大半を占めた.git履歴
アーカイブの中身は、ソースコードよりもGitの履歴が大半でした。
マニフェストがローカルに平文で保存されていたため、ferstarは42,411ファイルの内訳を出せました。.git/lfs/が196.1MB(56.8%)、.git/objects/が102.2MB(29.6%)、.git/logs/が0.6MB(0.2%)で、ソースコードとドキュメントは46.2MB(13.4%)でした。.gitディレクトリだけでアーカイブ内容の86.6%を占めています(参照*3)。
.git/objectsにはコミットされたすべてのファイルの全バージョンが入り、2023年にコミットされて翌日に削除された.envファイルも含まれます。reflogにはリベースやリセットの前にブランチが指していた場所が残ります。LFSにはデータセットやモデルの重みといった大きなバイナリが保存されます(参照*4)。
ただし「完全な履歴」には限界があります。ここでの対象は、実際にローカルマシンに存在するGitオブジェクト、LFSキャッシュ、ログの範囲です(参照*2)。
送信経路と暗号化の仕組み
送信は、サーバーから受け取った認証情報をもとに、クラウドストレージへ直接行われていました。
クライアントはコード内のVITE_ZCODE_ENDPOINT_ORIGINであるhttps://zcode.z.ai を呼び、OSSフォーム署名や動的なObject Key、サイズ制限、暗号化用のRSA公開鍵を受け取ります。ローカルでアーカイブ化と暗号化を行った後、ZCodeのアプリケーションサーバーを迂回し、POSTフォームでtar.gz.encをAliyun OSSへ直接投稿します。公開鍵に対応する秘密鍵は利用者のマシンに触れず、ferstarはドライブ上の313MBの暗号文を本人もクライアントも開けないと述べています(参照*1)。
検証の限界もあります。クライアント側の分析だけでは、秘密鍵が唯一どこにあるのか、コピーが存在するのか、誰に使用権限があるのかまでは確認できません(参照*2)。
止まらなかった設計の中身
2つのスイッチが制御していた範囲
画面にあった2つの設定は、収集と送信そのものを止めるものではありませんでした。
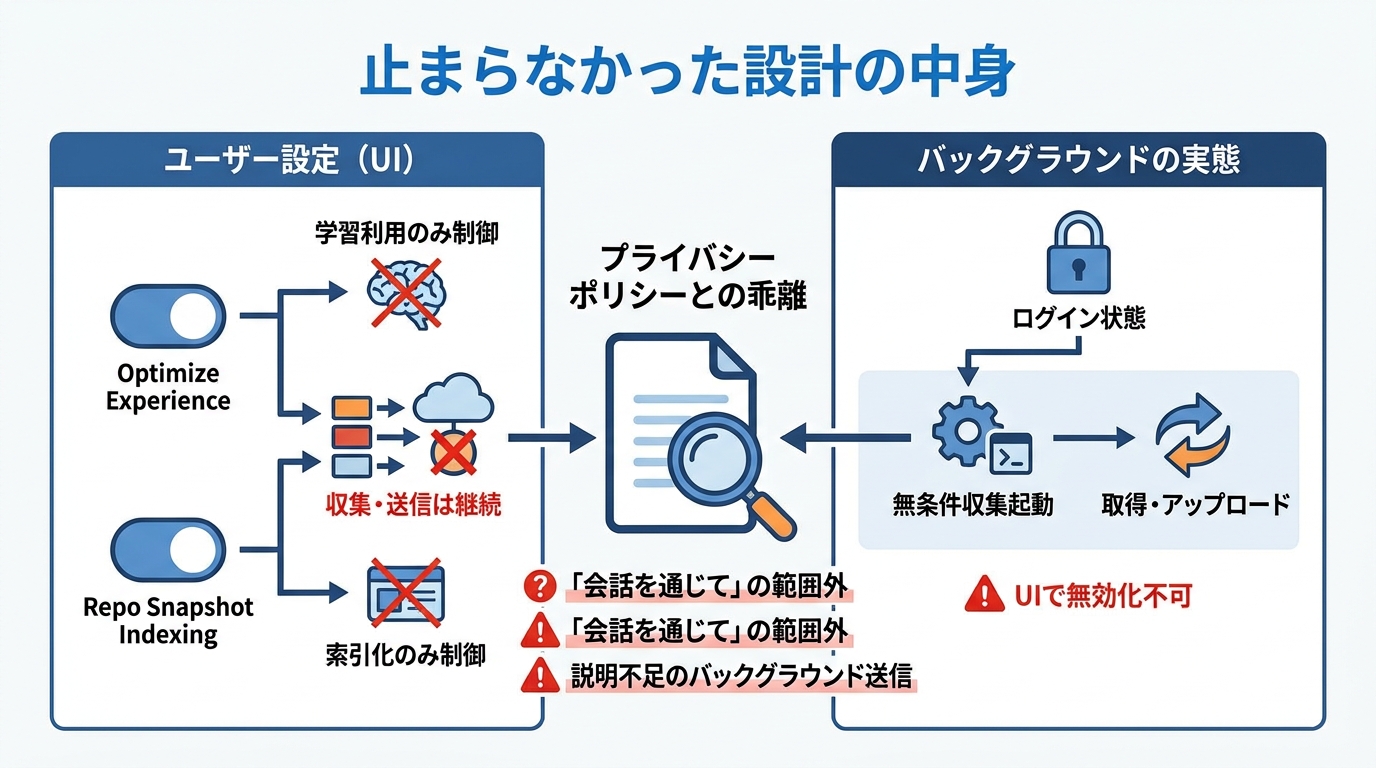
Optimize Experience(optimizeAgentExperienceEnabled)は、名前からテレメトリやデータ収集を切るものに見えますが、実際にはモデル学習へのデータ利用を許可するかどうかだけを制御していました。スナップショットの取得とアップロードは続きます。Repo Snapshot Indexing(repoSnapshotIndexingEnabled)も、サーバーが受け取ったスナップショットを索引化するかどうかだけを決めるもので、ローカルでのパッケージ化とアップロードは止まりませんでした(参照*1)。
ここは重要な言葉の区別です。「学習にデータを使わない」という設定は、「データを集めない、送らない、持たない」という意味にはなりません(参照*2)。生成AIツールの設定名を字義通りに受け取ると、こういう誤解が生じます。
私はコンサルティングの現場で企業へのAI導入支援をしていますが、「プライバシー設定をオンにしているから大丈夫」という認識のまま業務で使っているケースを少なからず見てきました。設定の名前と実際の効き方が一致していない問題は、ZCode固有の話ではなく、多くのSaaSツールで起きている構造的な課題です。
ログイン時に動く収集処理
収集の仕組みは、ユーザー設定ではなくログイン状態に結び付いていました。
ホストの組み立てコードを見ると、取得とアップロード用のサイドカーは起動時に無条件で作られます。ユーザー設定を見るifチェックは無く、tokenProviderが有効なJWTを返せることだけが条件でした。つまりログインしている限りこのバックグラウンドの処理は常に動き、UIの設定では無効にできません。
取得のきっかけは2か所で、各プロンプトの前に走るcaptureBeforePromptと、repo-wiki-updateのタグが付いたタスク完了時です。セッションログでは、1つのアクティブなセッションで最大62回の取得イベントが出ました(参照*1)。
別の調査者も同じ構図を指摘しています。判断はローカルではなく、すべてのプロンプトでクライアントが無条件にサーバーへアップロード用の認証情報を求め、サーバーが発行すれば収集が進み、発行しなければ進みません。要求はキャッシュもログ記録もされず、失敗しても通知はなく、手元にそれを拒めるスイッチはありません(参照*5)。
プライバシーポリシーとのずれ
ポリシーに書かれていた収集範囲と、実際の挙動にはずれがありました。
ZCodeのプライバシーポリシーは、製品の利用時に、会話を通じて送信されたテキスト、ファイル(画像、音声、動画、設定パラメータ、シェルコマンドなどを含む)、およびコードを収集すると記載しています(参照*6)。ここで効いてくるのが「会話を通じて」という条件です。
バックグラウンドのスナップショットは会話を通じて送られておらず、この挙動はポリシーが説明する範囲の外にあると指摘されています(参照*5)。
一方で、言い過ぎも避ける必要があります。ポリシーがコードの収集に一度も触れていないという表現は不正確です。確認されたポリシーに見つからなかったのは、バックグラウンドのワークスペーススナップショット、Git履歴とLFSキャッシュのアップロード、そしてそれらに対する制御についての明示的な説明でした(参照*2)。
是正と開源で検証できた範囲
修正版と第三者機関の確認
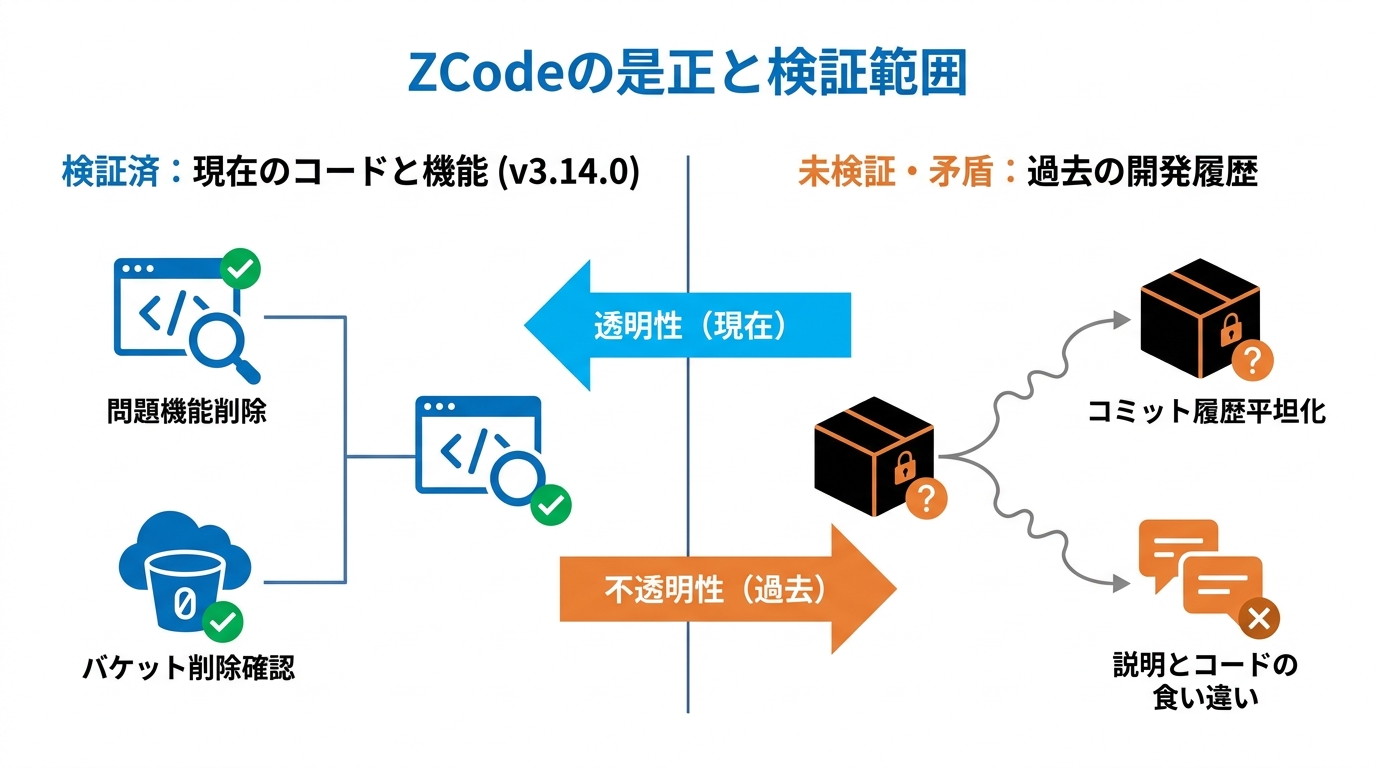
智譜は修正版の配布と第三者機関による検証を進めました。対応の速さは評価できます。ただし、対応の速さと、問題が最初から存在しなかったこととは別の話です。
9月19日に公開されたバージョン3.14.0について、智譜はRepoWikiの入口と、リポジトリのスナップショットを生成・アップロードする経路を削除したと説明しました。同社は9月21日にZCodeのソースコードをApache-2.0ライセンスでGitHubへ公開し、リポジトリは9月23日時点でコミット2件を表示しており、過去のバージョンや以前の開発履歴はありませんでした(参照*7)。
第三者機関の確認内容も公表されています。智譜は中国情報通信研究院とNSFOCUSという2つの第三者機関を招き、初回の検証を終えたと明らかにしました。
中国情報通信研究院の技術評価では、問題となったzcode-prodのAlibaba Cloud OSSバケットに現在クラウド上のデータがゼロであることが確認されました。NSFOCUSの審査結果では、バケット内のすべてのデータオブジェクトとバケット自体が削除され、更新版のZCode v3.14.0クライアントは全面的な是正を終え、Repo Wikiの項目と対応する生成リンクが削除され、ローカルリポジトリのスナップショットやファイルの持ち出しにつながる機能経路は見つからなかったと示されました(参照*8)。
コミット2つの公開リポジトリ
公開されたリポジトリは、現在のコードは読める一方で、過去の変更は追えない形でした。
ferstarによれば、リポジトリには空の初期コミットと、6,973ファイル・103万行のコードを一度に投入した巨大な「feat: open source」コミットの2つしかありません。内部の開発コミット履歴は完全に平坦化されており、以前のアップロード用サイドカーがどう変わってきたかを追う方法も、repoSnapshotパイプラインがどう削除されたかを示すコミット差分もありません。さらにPRはロックされ、Issueも閉じられているため、一方向のコードダンプになっていると述べています(参照*1)。
別の報道も同じ点を挙げています。コミット記録は2件だけで開発履歴が公開されていないため、データ収集を取り除いた変更を追えません。オープンソース化によって今のソフトウェアは調べられますが、以前どう動いていたかは再構築できません(参照*9)。
公開によって新しくできるようになったこともあります。誰でもv3.14.0のコードを読み、スナップショットのアップロード経路が本当に削除され、休眠状態になっているだけではないことを確かめられます。今後の機能は、リリース後に見つけるのではなく、リリース前にレビューできます(参照*10)。
説明と証拠の食い違い
残っている問いは、説明と公開コードの食い違い、そして監査が届かない過去の部分です。
ferstarは、公開コードではチェックポイントがクラウドに依存しない完全にローカルなGit差分ユーティリティであり、リポジトリ全体のパッケージ化とは関係がないと確認しました。そのうえで、チェックポイント復元のためにリポジトリ全体のアップロードが必要だったという公式の主張は、コードによって完全に崩れていると述べました。さらに、バケットが9月20日以降に空になったと示すだけでは、9月18日より前にアップロードされたデータの行方を遡って組み立て直せないとしています(参照*1)。
智譜は、コミュニティが指摘したコードデータは保持しておらず、モデルの学習に使ったこともないと述べました。これは明確な否定です。しかし、学習データの使用状況を独立して検証する方法はなく、証拠ではなく約束として受け止めるべきだと整理されています(参照*10)。「約束を信じるかどうか」という問題と、「構造的に検証できるかどうか」という問題を分けて考える必要があります。
企業ユーザーが取るべき後始末
対応は、すでに外へ出た可能性を前提に考える形になります。
何が収集されたかという履歴は公開されていないため、パッケージ化されたものはすべて外部へ出た可能性があるという前提で計画を立てる必要があります。漏えいしたコピーを無効にする唯一の手順は、認証情報をローテーションすることです。今回のコピーには通常のスキャナーが見ていない履歴も含まれており、履歴を書き換えてもスナップショットと一緒にすでに外へ出ているため、この場合は効果がありません(参照*4)。
ローカルに残る手がかりの保全も挙げられています。削除する前に、~/.zcode/v2/checkpoints/をマニフェストとステータスファイルごとコピーします。
マニフェストには取得されたすべてのファイルが記載され、ステータスファイルにはアップロードに失敗した回数が記録されていました。これは、何がパッケージ化され送信されたかを示す唯一のローカル証拠です(参照*4)。
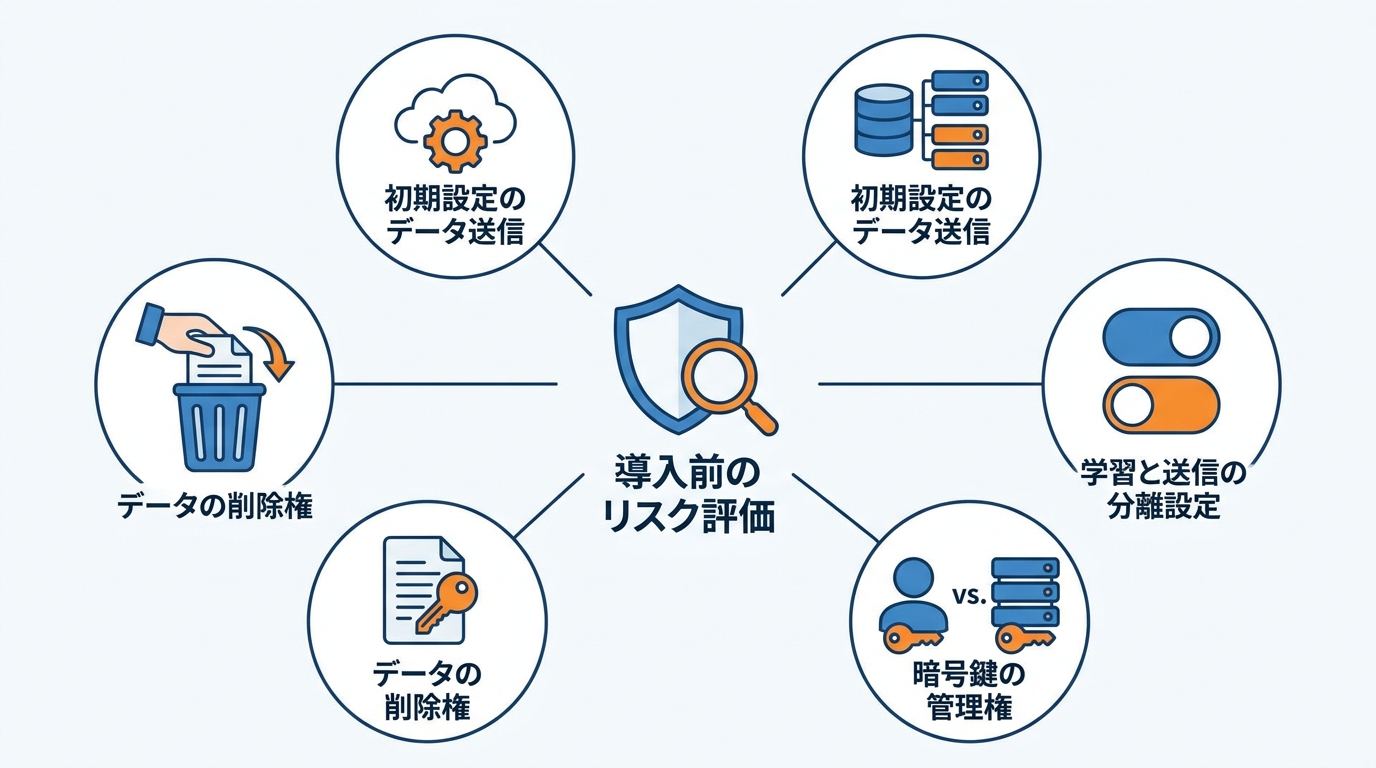
導入前に見る5つの観点
既定でクラウドへ行くデータ
1つ目の観点は、初期設定のままで何がクラウドへ出るかです。ここが最も基本的で、かつ最も見落とされやすい確認点です。
今回の問題は、特別な操作をしたユーザーだけに起きたものではありませんでした。批判が集まった後、ZCodeの公式チームはコミュニティで声明を出し、問題はデフォルトで有効になっていた「Codebase Indexing」機能に起因すると認めました。この機能は、会話のチェックポイント復旧とRepo Wikiを支えるためにローカルリポジトリの索引を作る設計でしたが、Wikiページの生成によってリポジトリデータのアップロードが起きる可能性がありました(参照*3)。
実際に送られかけた中身は小さくありません。開発者のワークスペースから42,411個のファイルが313MBの暗号化アーカイブにまとめられ、Alibaba Cloudへ564回の送信が試みられて失敗したと、Tom's Hardwareが報じています(参照*11)。
学習と送信の別スイッチ
2つ目の観点は、学習への利用を断るスイッチと、収集・送信を止めるスイッチが分かれているかどうかです。この2つが同じスイッチで制御されていると思い込んでいるユーザーが多く、そこに設計上の落とし穴があります。
ZCodeでは、Optimize ExperienceとRepository Snapshot Indexingのどちらの設定もアップロードを制御していませんでした。Optimize Experienceはデータをモデルの学習に使えるかどうかだけを決め、Repository Snapshot Indexingはスナップショットを受け取った後のサーバー側の索引作成だけを決めていました。取得処理は起動時に無条件で始まり、有効なログイントークンだけを必要としていました(参照*4)。
設定名と実際の効き方がずれていた、という形です。学習にデータを使わないことは、それだけでは収集・送信・保持をしないことを意味しません(参照*2)。
暗号鍵を持つのは誰か
3つ目の観点は、暗号化の鍵を誰が持っているかです。
契約にアップロード経路を盛り込み、クライアントが作るサーバー側のコピーをすべて開示させること、リリース前に変更を知らせること、顧客が削除を要求できる権利を求めることが挙げられています。そして、ベンダーが鍵を持っている場合には「暗号化しています」という説明は認められない、と整理されています(参照*4)。
今回はその状態が実際に起きていました。公開鍵はサーバーから渡され、対応する秘密鍵はユーザーのマシンに触れないため、ドライブ上の313MBの暗号文は本人もクライアントも開けず、解除できる鍵を持つのはZhipuのバックエンドだけだとferstarは述べています(参照*1)。
削除をユーザーが実行できるか
4つ目の観点は、送られたデータの所在と削除を、ユーザー側から確かめて実行できるかです。
設定をオフにしたとき、新しいスナップショットの作成が止まること、そして保留中の再試行がどうなるのかをはっきり示すべきだと指摘されています。ユーザーは、以前のアップロードがどこに保存され、いつ削除され、どのコピーがすぐには消せないのかを、メールを送って回答を待つことなく確認できるべきです。削除してもすでに行われた利用は取り消せない可能性があるため、最も重要な制御は転送の前に働くべきだとされています(参照*2)。
すでに受け取られたデータの扱いも確認の対象です。保存・処理の地域、アクセス権限、保持期間、ほかの用途を含めて説明し、何を保有しているかを確かめる方法、削除を依頼する方法、何が行われたかについて検証できる記録を得る方法をユーザーに伝えるべきだと求められています(参照*5)。
開源に実装履歴が残るか
5つ目の観点は、公開されたソースに当時の実装が残っているか、そして通信を自分で測れるかです。
ZCodeの公開リポジトリはコミット記録が2件だけで、開発履歴が公開されていません。そのため、データ収集を取り除いた変更を追うことはできません(参照*9)。
自分で測るという確認方法も有効です。承認するコーディングエージェントには、ネットワーク上で通信先を実際に証明させる必要があります。「プライバシーポリシーに書いてある」ではなく、「実際にどこと通信しているか」を計測することが出発点です。
ファイルシステムにアクセスできるコーディングエージェントは、チャット画面が付いたデータ流出経路です。承認時に問うべきことは、プライバシーモードがあるかどうかではなく、カナリアリポジトリで2時間動かした間にどのホストへ接続し、それぞれへどれだけのデータを送ったか、という内容です(参照*4)。
他ツールにも共通する設計圧力
同じような挙動は、ZCode以外でも報告されています。この問題をZCode固有の「悪い会社の話」として片付けると、本質を見誤ります。
今年7月、セキュリティ研究者のcereblabはxAIのGrok Build CLIからのネットワーク通信を取得しました。「OKと返信し、ファイルを読まないでください」と明示したプロンプトでも、リポジトリ全体をGitバンドルとしてまとめ、Google Cloud Storageへアップロードしていました。バンドルをクローンすると、エージェントが一度も読んでいないファイルと完全なコミット履歴の両方が復元され、「Improve the model」をオフにしても効果はありませんでした(参照*5)。
前提の置き方も示されています。エージェントのデスクトップクライアントは、ディスク全体を読み取り、ネットワークにアクセスする権限を持つ常駐のバックグラウンドプロセスです。その前提で監査するべきで、チャットウィンドウは誤解を招く比較対象だと指摘されています(参照*5)。
おわりに
今回の出来事は、モデルの不具合でも悪意のある機能でもなく、製品の境界に関する問題でした。初期設定で有効になった機能が、最も機密性の高いファイルとコミット履歴の全体を、ユーザーが同意していない信頼境界の外へひそかに移していた、という整理が示されています(参照*10)。私が生成AI導入支援の現場で繰り返し感じるのは、「便利だから使う」と「何を渡しているかを把握して使う」の間にある大きな距離です。
是正によって確かめられたのは、v3.14.0のクライアントとバケットの現状までです。既定で何が外へ出るか、学習と送信のスイッチが分かれているか、鍵は誰のものか、削除を自分で実行できるか、公開コードに当時の実装が残っているか。導入の判断では、この5つが確認できる材料になります。コーディングエージェントは便利なツールですが、ファイルシステムへのアクセス権を持つ常駐プロセスでもあります。その前提で向き合うことが、今後の導入判断の基本線になるはずです。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Code is cheap, let's talk – Inside ZCode: Silently Uploading Your Entire Git History to the Cloud
- (*2) 哲见 · WISE AI – ZCode's upload controversy: privacy needs more than a company's word
- (*3) King of Computer Media – Zhipu ZCode has been exposed for silently packaging up the entire Git history and uploading it to Alibaba Cloud, with the encryption key held only by the vendor. – King of Computer Media
- (*4) ZCode Packed Whole Git Histories, Deleted Secrets and All
- (*5) VONNG – Zhipu, Why Is ZCode Packaging and Uploading My Repo?
- (*6) ZCode – ZCode Privacy Policy
- (*7) AI Policy Daily – OpenAI agent hacked Australian portal
- (*8) Zhipu AI Announces ZCode Open-Sourcing & Third-Party Audit After Issuing Accountability Letter Against Code Theft Allegations
- (*9) Korben's website – Z.ai: its coding assistant sent your projects to the cloud without a warning
- (*10) DEV Community – ZCode Answered Its Critics: Open Source Code, Third-Party Audits, and a Deleted Bucket
- (*11) AI Weekly – Z.ai Open-Sources ZCode After Silent 313MB Workspace Upload