この記事のまとめ
Gemini 3.8 Flash TTSは、2026年9月22日に一般提供が始まったGoogleの主力クリエイティブTTS(テキスト読み上げ)モデルです。言葉で声を設計するVoice designと、録音から声を複製するVoice replicationが中心機能となっています。ここでは、利用環境、作成条件、評価結果など4つのポイントを簡潔に整理します。
- Gemini APIとGoogle AI Studioで順次提供されており、アクセスはAPI経由のみです。オーディオブックやナレーション、2人の対話などの用途に向けて設計されています。
- 音声デザインでは、年齢やアクセントなどを1~2文で指定するだけで、再利用可能なvoice_… ID付きの音声を生成できます。
- 音声複製には、同一の成人話者による10~30秒の参照音声と、同意文を読み上げた同意音声が必要です。
- Hume AIの音声デザインベンチマークで総合1位を獲得した一方、話者の類似性や一部の属性制御には課題も残されています。
Gemini 3.8 Flash TTSの全体像
モデルの位置づけと提供形態
まずは、Gemini 3.8 Flash TTSがどのような立ち位置のモデルで、どこから利用できるのかを整理します。
TTSは、テキスト原稿を音声に変換する技術です。生成AIによる文章生成とは異なり、出力品質が「読み上げの自然さ」や「声の表現力」として直接耳に届くため、ベンチマークのスコア以上に、実際に聴いてみるまで真価がわかりにくい領域でもあります。
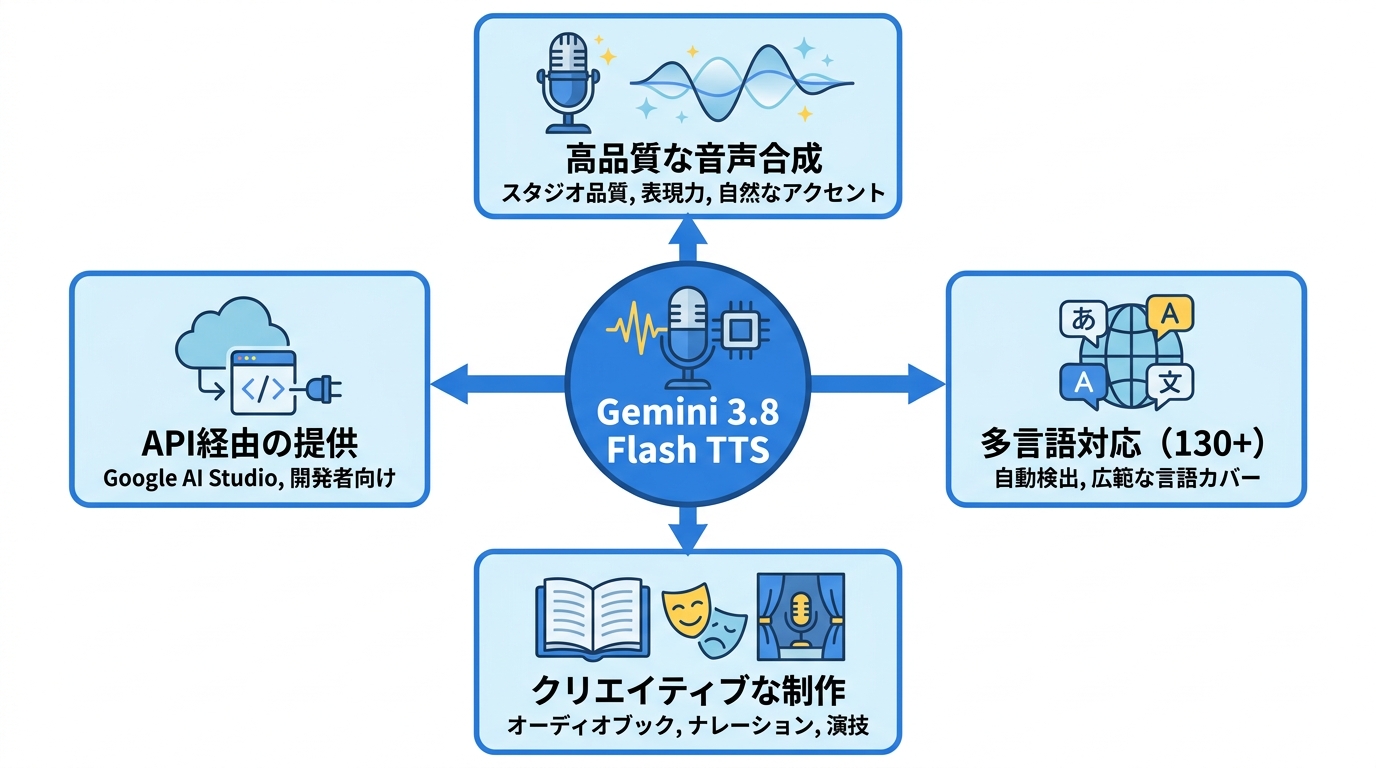
Gemini 3.8 Flash TTS(gemini-3.8-flash-tts)は、スタジオ品質の音声再現性、表現力豊かな演技、自然な地域アクセント、長時間のマルチターン対話における安定性を目指して設計された、Googleの主力クリエイティブ音声合成モデルです(参照*1)。
一般提供は、2026年9月22日に開始されました。
同日、Gemini 3.8 Flash TTSとGemini 3.8 Flash-Lite TTSが一般提供(GA)となり、あわせてGemini APIのVoicesエンドポイント(/v1beta/voices)も公開されました(参照*2)。両モデルは、Gemini APIとGoogle AI Studioを通じて順次提供されています。
これらは、同月に発表されたGemini 3.8ファミリーに加わるモデルです(参照*3)。
利用方法はAPI経由に限られます。チャットUIのように手軽に試せる環境は現時点では用意されておらず、利用するにはAPIキーの取得とコードの実装が必要です。
両モデルへのアクセスはAPI経由のみで、自社サーバーなどで動かすためのオープンウェイトモデルは公開されていません。Gemini Enterpriseを通じた企業向けのAPIアクセスは、近日提供予定とされています(参照*4)。
得意とする用途と対応言語
次に、Gemini 3.8 Flash TTSが向いているコンテンツ制作の分野と、対応言語の範囲を見ていきます。
本モデルが得意とするのは、繊細な作り込みが求められる音声制作です。単純な読み上げにとどまらず、豊かな演技力や細やかなニュアンスの表現が必要な場面を想定して設計されています。
公式ドキュメントでは、Gemini 3.8 Flash TTSの最適な用途として、オーディオブック、スタジオナレーション、複雑な複数話者の対話、ダイナミックな感情表現、難度の高い発音、地域方言などが挙げられています。一方のGemini 3.8 Flash-Lite TTSは、大量生成、リアルタイム音声エージェントのパイプライン、画面読み上げ、音声複製、日常的な単一話者のコンテンツ生成などに最適とされています(参照*1)。
対応言語数については、参照する資料によって記載が若干異なります。
モデル仕様ページでは、対応言語数はGemini 3.8 Flash TTSが130言語、Flash-Lite TTSが101言語と記載されています(参照*1)。
一方、音声生成のドキュメントでは、TTSモデルが入力言語を自動検出し、Gemini 3.8 Flash TTSは130以上の言語、Gemini 3.8 Flash-Lite TTSは100以上の言語に対応すると説明されています(参照*5)。いずれにしても明示的な言語指定は不要で、入力テキストから自動的に言語が判定される仕様です。
音声デザインと音声複製
プロンプトによる音声デザイン
ここでは、自然言語で特徴を記述するだけで新しい音声を生成できる「Voice design」について解説します。この機能が注目される理由は、「事前の録音素材がなくてもキャラクターのイメージに合わせた声を用意できる」という点が、コンテンツ制作の実務に直結するためです。
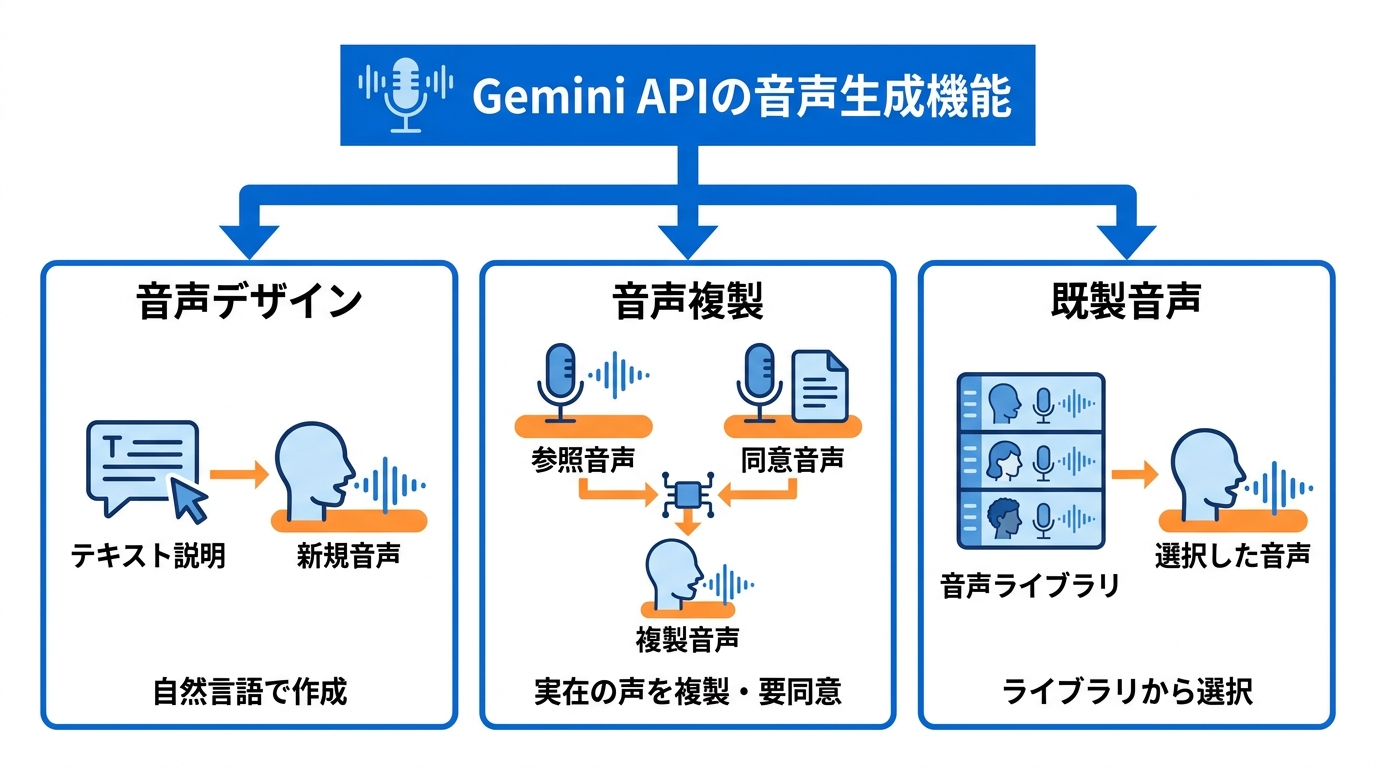
Voice designは、テキストによる説明から新しい音声ペルソナを作り出す機能です。
Gemini APIのVoicesエンドポイント(POST /v1beta/voices)を利用し、キャラクターの年齢層、声のトーン、アクセント、話し方の特徴などをプロンプトで指示すると、プロジェクト内で再利用できるID(voice_…)が発行されます。これにより、既存の音声プリセットや収録済みの音声データに依存せず、自由な声を用意できます(参照*6)。
プロンプトの記述にはコツがあり、普段テキスト生成AIを使い慣れている人ほど注意が必要です。
公式ドキュメントでは、具体的かつ簡潔に書くことが推奨されています。例えば、「少し中西部訛りのある、30代の歯切れがよくエネルギッシュなスポーツアナウンサー」のように明確な1~2文で指示することで、情報量が多すぎる段落や矛盾を含む指示よりも、明瞭で安定した結果が得られるとされています(参照*6)。
これは生成AIへの指示全般に共通する原則です。「長く詳しく書けば良くなる」わけではなく、「一貫性のある要点に絞って伝える」ほうが意図通りの出力を得やすくなります。相反する指示を含めるとモデルの判断がブレてしまい、出力の品質が低下する原因になります。
なお、作成した音声には保存数と保持期限の上限があります。
サーバー側に状態を保持する音声(store=True)は、プロンプトで生成した音声と複製した音声とで共通の枠が適用され、プロジェクトあたり最大200件、有効期間(TTL)は1年間と定められています(参照*6)。
音声複製の手順と同意の条件
続いて、実在する人物の声を再現する「Voice replication」の利用条件を整理します。音声複製は非常に強力な技術である一方、不正利用を防ぐために技術的要件と同意手続きが厳格に定められています。
音声複製には、2種類の音声ファイルが必要です。
CreateVoiceによる複製リクエストでは、同一の成人話者による人間の音声録音データが2つ必須となります(推奨フォーマットは24kHz、モノラル、16bit WAV)。1つ目は複製対象となる話者の発話を10~30秒程度収めた明瞭な参照音声(source_audio)、2つ目は所定の同意文をその話者自身が読み上げた同意音声(consent_audio)です(参照*7)。
保存方法は2種類から選択可能です。
標準として推奨されるステートフル保存(store=True)では、検証済みの音声プロファイルがプロジェクトに保持され、軽量で恒久的なvoice_idが発行されます。
このIDは各APIリクエスト間で共通して利用でき、voices.list()、voices.get()、voices.delete()といったメソッドで管理できます。生体音声プロファイルをサーバー側に残したくない場合は、store=Falseを指定してクライアント側で管理するステートレス運用を選択することも可能です(参照*7)。
高品質な複製を得るための収録環境についてもガイドラインがあります。
部屋の反響や環境ノイズ、BGM、声の被りなどを最小限に抑え、静かな環境で収録することが推奨されています。また、話者検証チェックの通過率を高めるため、source_audioとconsent_audioは同一のマイクおよび音響環境で録音する必要があります(参照*7)。
音声ライブラリと既製音声
音声を独自に作成せず、あらかじめ用意されたプリセットから選択して利用することも可能です。
プリセットは大きく2つのカテゴリに分かれています。
公式ドキュメントには、すぐに使えるスタジオ品質の既製音声として厳選された30種類が掲載されています。さらにExtended Voice Libraryを利用すれば、client.voices.list()(GET /v1beta/voices)を通じて、多様な言語、アクセント、キャラクター像をカバーする数百種類以上の追加音声にアクセスできます(参照*5)。
ライブラリの充実度については、メディアでも取り上げられています。
TNWの報道によると、メキシコ方言のスペイン語、ケベック方言のフランス語、スコットランド訛りの英語など、地域色豊かな2,000種類以上のプリセット音声が提供されています。生成したカスタム音声はプロジェクトをまたいで再利用できるように保存可能なほか、音色、ピッチ、話速、アクセントを微調整できる音声リミックス機能も近日中に提供される予定です(参照*3)。
演技を指示する仕組み
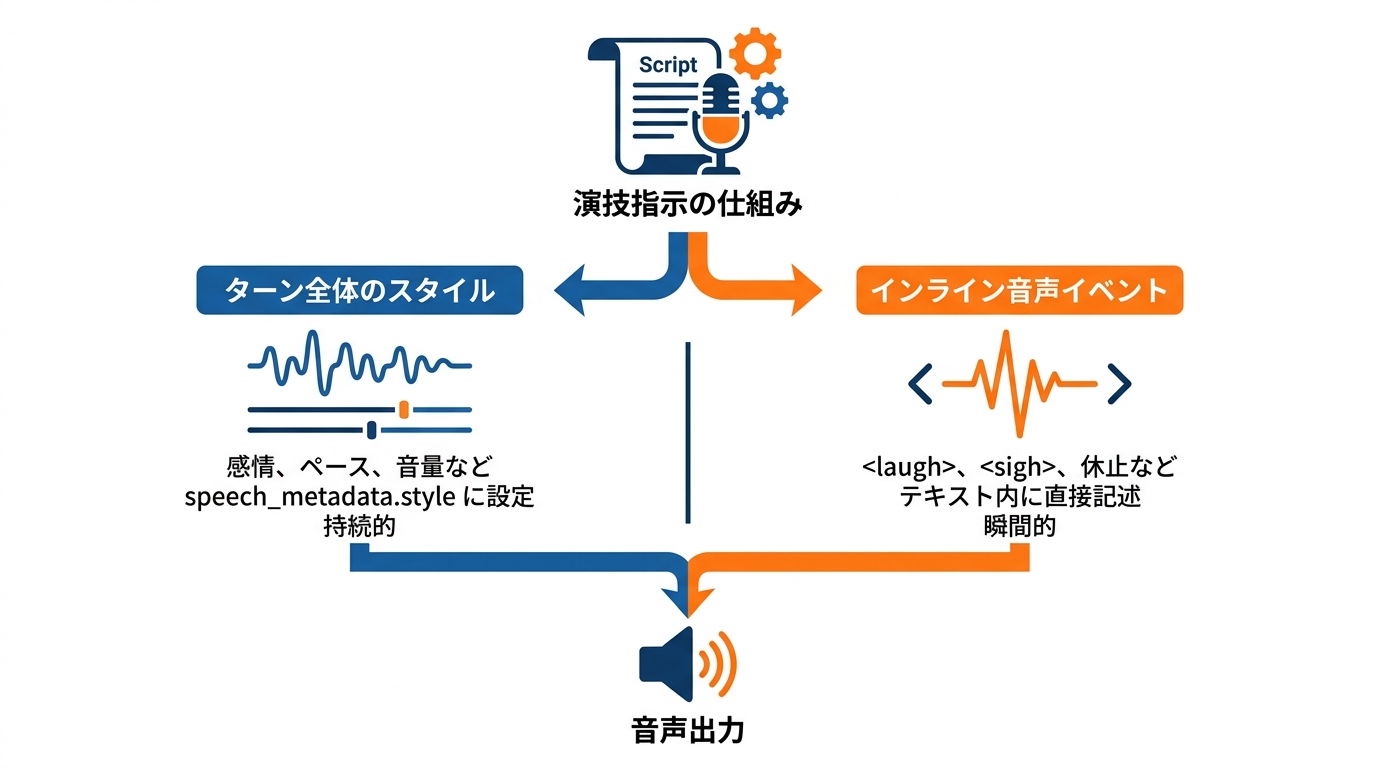
styleとインラインタグの使い分け
読み上げのニュアンスに関する指示は、発話全体に適用するものと、部分的に挿入する演出とで指定場所が分かれています。
入力テキストは、記述通りに読み上げられるのが前提です。
Gemini 3.8 TTSは、textフィールドの内容を一言一句そのまま発話用スクリプトとして処理します。
そのため、指示内容がそのまま読み上げられてしまわないよう、指定の適用範囲に応じて記述場所を切り替えます。感情、語り口、イントネーション、話速、音量など、発話ターン全体に反映させたい指示はspeech_metadata.styleに記述します。一方、笑い声やため息、一時的な間(ポーズ)といった瞬間的な音声演出は、山括弧(< >)を用いてテキスト内に直接挿入します(参照*5)。
インラインタグの具体例も示されています。
モデル仕様ページでは、豊かな感情表現や自然な抑揚の実現に加え、ターン単位のスタイル指示や、インライン音声イベント(<laugh>、<sigh>、<short pause>など)に対する忠実なコントロール性能が強調されています(参照*1)。
2話者対話と出力形式
対話形式の音声生成手法と、返却される音声データのフォーマットを確認します。
2人の対話シーンは、話者ごとのターンを設定して作成します。
複数話者の対話では、speech_config.speakersで2人の話者を定義し、各発話を個別のテキスト要素として指定します。その際、speech_metadataアノテーションを用いて話者の割り当てやターンごとのスタイル演出を設定します。自然な会話の間やテンポを再現するには、"mode": "conversational"を指定します。なお、単一リクエスト内で完結する対話生成は、プリセット音声を用いた最大2人までに限定されます。独自に設計したカスタム音声や複製音声を使って複数キャラクターの対話を作成する場合は、各話者のターンを個別に音声合成する必要があります(参照*5)。
音声データの出力形式は、APIのリクエスト方式によって異なります。
一括取得のリクエスト(stream=False)では、標準的なRIFFヘッダーを含む完全なWAV形式(audio/wav)で返却され、音声フォーマットは24kHz、モノラル、16bit リトルエンディアンPCMとなります。
デコード後の音声バイトデータは、手動でWAVヘッダーを付与することなくそのまま.wavファイルとして保存可能です。一方、ストリーミングリクエスト(stream=True)では、ヘッダーのないリニアPCM(audio/l16)のチャンクが順次返却される仕様となっています(参照*5)。
Flash-Lite TTSとの使い分け
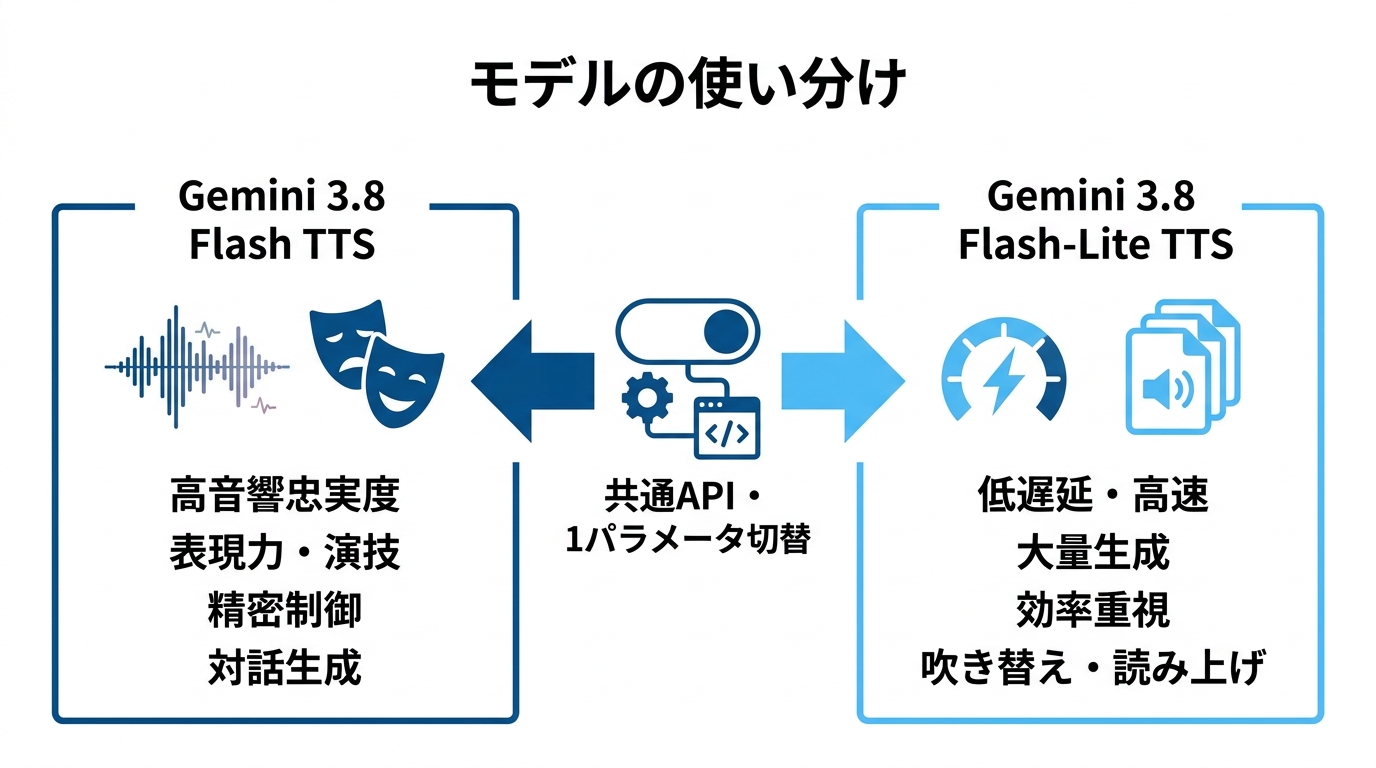
両モデルは共通の記述形式を採用しており、用途に応じて柔軟に切り替えられます。
モデルの切り替えは、パラメータを1つ変更するだけで完結します。
Gemini 3.8 TTSシリーズの2つのモデルは、APIスキーマおよびプロンプトの仕様が統一されているため、リクエスト内のパラメータを変更するだけで相互に切り替えが可能です。最高峰の音質や精緻な演技力、表現豊かなコントロールを最優先する場合は、Gemini 3.8 Flash TTS(gemini-3.8-flash-tts)の利用が推奨されています(参照*5)。
一方、Flash-Lite TTSは処理速度とコスト効率を重視したモデルです。
Slatorの報道によると、Gemini 3.8 Flash-Lite TTSは低レイテンシかつ大量の音声合成を想定して設計された、高速かつ低コストな選択肢とされています。101言語をサポートし、動画の大量吹き替え、音声制作、読み上げ機能、対話型音声エージェント、日常的なナレーション作成などを主な対象としています(参照*8)。
Google DeepMindの解説でも、両者の強みは明確に棲み分けられています。
Gemini 3.8 Flash TTSは、独自の音声デザインや2話者による緻密な対話生成に適しており、指示に忠実な制御力と、文をまたいでも崩れないイントネーションや抑揚、安定したテンポを実現します。対してGemini 3.8 Flash-Lite TTSは、動画の吹き替えやポッドキャスト制作などの日常的な音声生成に最適で、処理効率と表現力のバランスに優れ、大規模なコンテンツ群の処理や高トラフィックなアプリケーションに適していると説明されています(参照*9)。
評価結果と使う前の注意点
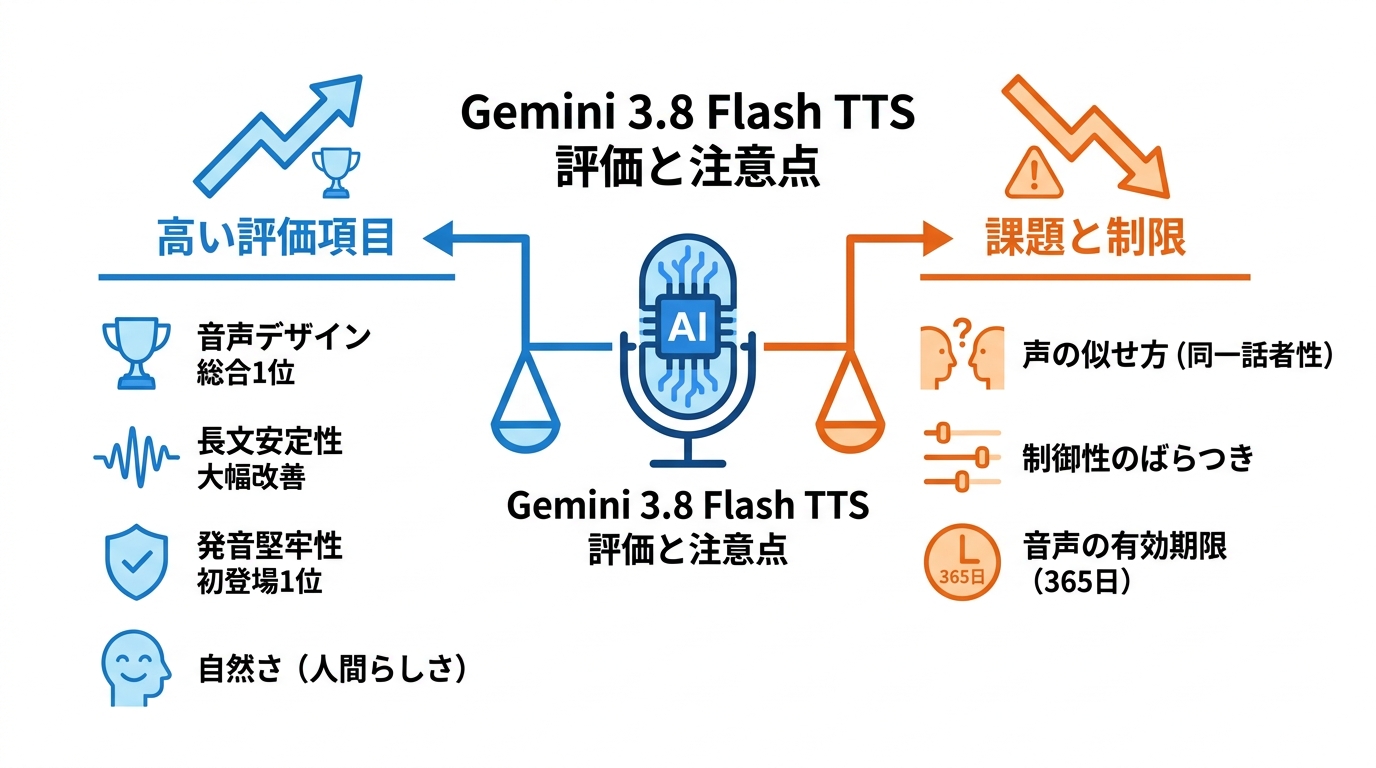
独立評価でのスコアと改善点
第三者機関による評価スコアの内容を確認していきます。
Googleは、音声デザインに関するベンチマークで高い評価を獲得したことを公表しています。
公式ブログによると、Gemini 3.8 Flash TTSはHume AIの音声デザインベンチマークで71.4スコアを記録して総合1位となり、アクセントモデリングの項目でも60.8で首位を獲得しました(参照*10)。
前世代モデルからの大幅な改善点として挙げられるのが、長文生成時の安定性です。
プレビュー版の独立検証を行ったHume AIのレポートでは、Gemini 3.1 Flash TTSと比較した最大の進化点として長文生成の安定性が挙げられています。5点満点の評価において、Gemini 3.8 Flash TTSは従来の1.22から2.89へ、Gemini 3.8 Flash-Lite TTSは3.03へと大幅に向上しました。両モデルともに通常の長文生成はもちろん、新たに追加された多言語での長文生成においても高い安定性を示しています(参照*11)。
別の検証機関からも高い評価が報告されています。
24/7 Wall St.の報道によると、Gemini 3.8 Flash TTSはArtificial Analysisの発音堅牢性ベンチマークで初登場1位を獲得し、同社のProvider Voice Arena Leaderboardでも2位にランクインしました。これにより、ElevenLabsやOpenAIが先行していた音声合成分野において、Google(Alphabet)の技術的信頼性が証明されたと評されています(参照*12)。
弱点・制限と安全性の仕組み
優れた性能を持つ一方で、現状の課題や利用上の制約についても把握しておく必要があります。総合スコアの高さだけで導入を判断するのではなく、想定用途と弱点を照らし合わせて検討することが重要です。
まず、元の声への忠実度(類似性)には課題が残されています。
Hume AIによるプレビュー版の検証結果では、同一話者の再現性指標において、Gemini Flash-Lite TTSが全13モデル中7位(5点満点中3.68、全体平均3.69)、Gemini Flash TTSは3.53で11位にとどまりました。
その一方で、音声の自然さの評価ではそれぞれ2位と4位という上位を獲得しています。この結果は、「人間らしい自然な発声であること」と「特定の人物の声にそっくりであること」が技術的に異なる評価軸であることを物語っています(参照*11)。
この特性の違いは、実務導入における重要な判断基準となります。「自然に聞こえる魅力的な声」であれば十分なナレーションやキャラクター制作には適していますが、特定人物の声の同一性が厳密に求められる用途では、類似性スコアを事前に十分に検証する必要があります。
また、指示に対する制御性もすべての属性で一律に高いわけではありません。
同検証レポートでは、Gemini Flash TTSの優れた制御性能にも属性ごとのばらつきがあると指摘されています。例えば、若年成人の声質再現精度は34.0%にとどまり、ElevenLabs v3の68.1%を下回ったほか、音量制御の適合率も56.9%と、Inworld Voice Designの88.9%に及ばない結果となっています(参照*11)。
生成した音声の有効期限についても、開発者コミュニティで検証結果が共有されています。
ある開発者の報告によると、プロンプトで生成した音声のexpire_time(有効期限)は作成時刻から正確に365日後となっており、音声情報の参照(GET /v1beta/voices/{id})や該当音声を使った音声合成を実行しても、期限の延長は一切確認されなかったとのことです。作成直後でも24時間経過後でも挙動は変わらず、利用実績による有効期限の自動延長は行われない仕様となっています(参照*13)。
最後に、安全対策と地域ごとの提供制限についても確認が必要です。音声複製機能は悪用やなりすましのリスクを伴うため、厳格な保護対策が講じられています。こうした対策は、エンタープライズ用途での導入を検討する上で安心材料となります。
Googleは、Gemini Audioモデルが生成するすべての音声に電子透かし技術「SynthID」を不可視・不可聴の形で埋め込んでいます。
さらに音声複製データにはC2PA規格の来歴情報が付与されるほか、同意確認プロセスとして、複製処理の実行前に音声の権利者本人が参照音声と一致する声で読み上げた同意録音の提出が義務付けられています。なお、Google AI Studioにおける音声複製機能は、法規制等の観点からイリノイ州、テキサス州、欧州経済領域(EEA)、英国、スイス、インドでは提供されていません(参照*14)。
おわりに
Gemini 3.8 Flash TTSは、スタジオ品質の音質、リアルなアクセント表現、長文生成時の安定性を兼ね備えた最新の音声合成モデルです。テキスト指示だけで狙い通りの声を作り出す「Voice design」や、参照音声と同意データをもとに高精度に再現する「Voice replication」に対応し、30種類の厳選プリセットやExtended Voice Libraryからの選定も可能です。特にプロンプトのみで音声を創出できるVoice designは、録音素材が手元にない状況でも柔軟に声を用意できるため、クリエイティブ制作のワークフローを大きく刷新する可能性を秘めています。
表現のコントロールにあたっては、ターン全体に反映させるstyleプロパティと、山括弧で指定する瞬間的な音声イベントタグの使い分けがポイントになります。第三者評価では音声デザイン分野で1位を獲得するなど高い完成度を示す一方、同一話者としての類似度や特定の年齢層の表現精度には改善の余地も見られます。また、カスタム音声の保持期間(1年間のTTL)や一部地域での機能制限といった前提条件への配慮も欠かせません。総合ベンチマークの結果を参考にしつつ、自社の具体的な用途において強みを発揮できるかを実機検証した上で導入を見極めるのが、確実なアプローチといえるでしょう。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事したのち、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任後、2013年5月にWebマーケティングおよびコンテンツ制作を手がける「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月には生成AIコンサルティングおよびAIメディア運営を行う「ワークワンダース株式会社」を設立し、ICJ2号ファンドより資金調達(1.3億円)を実施。
著書『頭のいい人が話す前に考えていること』は累計95万部(2026年6月時点)を突破。
(“2023年・2024年上半期に日本で一番売れたビジネス書”トーハン調べ/日販調べ)
参照
- (*1) Google AI for Developers – Gemini 3.8 Flash TTS
- (*2) Google AI for Developers – Google AI for Developers
- (*3) TNW | Google – Google’s new Gemini TTS models can clone a voice from 30 seconds of audio
- (*4) MarkTechPost – Google Releases Gemini 3.8 Flash TTS and Flash-Lite TTS With Prompt-Based Voice Design
- (*5) Google AI for Developers – Text-to-speech generation (TTS)
- (*6) Google AI for Developers – Voice design – Interactions API
- (*7) Google AI for Developers – Voice replication
- (*8) Slator – Google Launches New Models for Dubbing, ‘Creative’ Voices
- (*9) Google DeepMind – Gemini Audio – Google DeepMind
- (*10) Google – Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS
- (*11) Newly-released Google's Gemini 3.8 Flash TTS tops Hume's Real-World VoiceEQ leaderboard
- (*12) 24/7 Wall St. – Google Gemini 3.8 Flash TTS takes the top pronunciation ranking
- (*13) Google AI Developers Forum – Designed voices (voice_…) expire after 1 year: is there any way to keep or recreate one?
- (*14) BigGo Finance – Alphabet Unveils Two Gemini Voice Models With Custom Voice Design and Multi-Speaker Dialogue