この記事のまとめ
Recursiveの「Flint」は、ノートPCでの動作を前提に開発されたコーディング向けのMoEモデルです。重みはApache 2.0で公開されており、開発には同社独自の自動研究システム「Eureka Machine」が用いられたと説明されています。本記事では、Flintの概要、ノートPCで動く理由、開発の背景、公表数値の読み解き方という4つの観点を整理します。
- Flintは総パラメータ39.8B、トークンごとのアクティブ約2.5Bのテキスト専用MoEモデルで、Apache 2.0ライセンスで公開されています。
- トークンごとに一部のエキスパートだけを使う仕組みと、4ビット量子化や専用カーネルの最適化が組み合わさり、ノートPCでの高速生成が報告されています。
- 開発はEureka Machineという自動研究システムが支えたとRecursiveは説明していますが、完全な技術論文は公表されておらず、その寄与を独立して検証することはできません。
- SWE-bench Verified 74.2などの数値はRecursiveの報告で、密モデルに劣る項目もあるため、条件とあわせて読む必要があります。
Flintの概要と基本スペック
開発元と公開形態
まず、Flintの開発元や公開形式について確認しておきます。
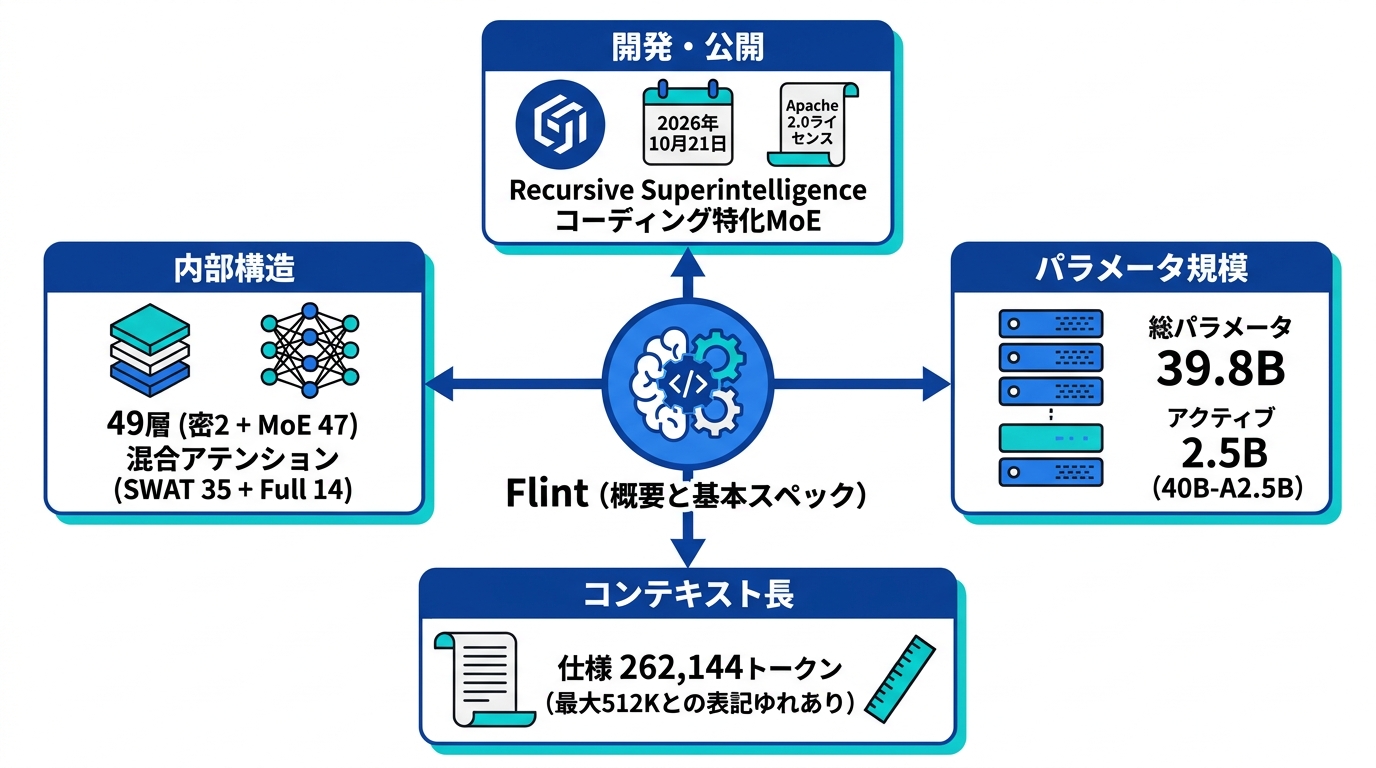
Flintは、コーディングエージェント向けにゼロから学習されたテキスト専用のMixture-of-Experts(MoE)モデルです。Recursive Superintelligenceが2026年10月21日にリリースしました。ライセンスはApache 2.0で、総パラメータ数は39.8B、アクティブパラメータ数は約2.5Bとなっています(参照*1)。
公開形態については、注意しておくべき点もあります。Flint本体はApache 2.0ライセンスで提供されていますが、ホスト型APIの利用条件やデータの取り扱いは、モデルウェイトのライセンスとは別規定として扱われます(参照*2)。
開発体制の特異さも目を引きます。Recursiveの説明によれば、Flintは少人数の人間とエージェントで構成されたチームが4か月足らずでゼロから作り上げたモデルであり、ローカル環境で高速なエージェント型コーディングを行うために設計されました(参照*3)。私がAI活用プロジェクトの支援をしてきた経験から言うと、4か月でフルスクラッチのモデルを出せること自体、Eureka Machineが単なるコンセプトではないことを示唆していると受け取っています。ただし、それが本当にどの程度AIの貢献によるものなのかは、後述するように検証の余地が残ります。
パラメータ構成とコンテキスト長
続いて、「40B-A2.5B」という表記の内訳と、扱えるコンテキストの長さを確認します。
Flintの内部構成は、モデルカードに詳しく記載されています。総パラメータ数は39.8B、トークンごとのアクティブパラメータ数は出力ヘッドを含めて約2.5Bです。
全49層のうち、最初の2層が密な層、残る47層がMoE層となっています。アテンション機構は、35層のスライディングウィンドウ層と14層のフルアテンション層の組み合わせです(参照*2)。
なお、アクティブパラメータの算出条件には留意が必要です。上記の数値は出力ヘッドを含み、入力埋め込み行列全体を除外した計算です。
アクティブなモデル本体のみで見ると約22億パラメータとなります。広く使われている「40B-A2.5B」という呼称は、サイズを概数で表した表記です(参照*2)。
コンテキスト長に関しては、情報源によって記述が分かれています。モデルカードでは仕様上の設定として262,144トークンが示されており、これはプロンプトと生成出力の両方を含む数値です(参照*2)。
一方で、モデルカードの262,144トークンに対し、リリース告知文では最大512Kと書かれているなど、表記の相違も指摘されています(参照*1)。
ノートPCで動く理由
混合エキスパート(MoE)の仕組み
ノートPCでの軽快な動作を支える基盤となっているのが、MoEというアーキテクチャです。私はこれまで生成AIのモデルを業務で使い比べてきましたが、ローカルで動かす際の最大の壁は「メモリ不足」です。その点でMoEの設計思想は、実務導入の観点から非常に理にかなっています。
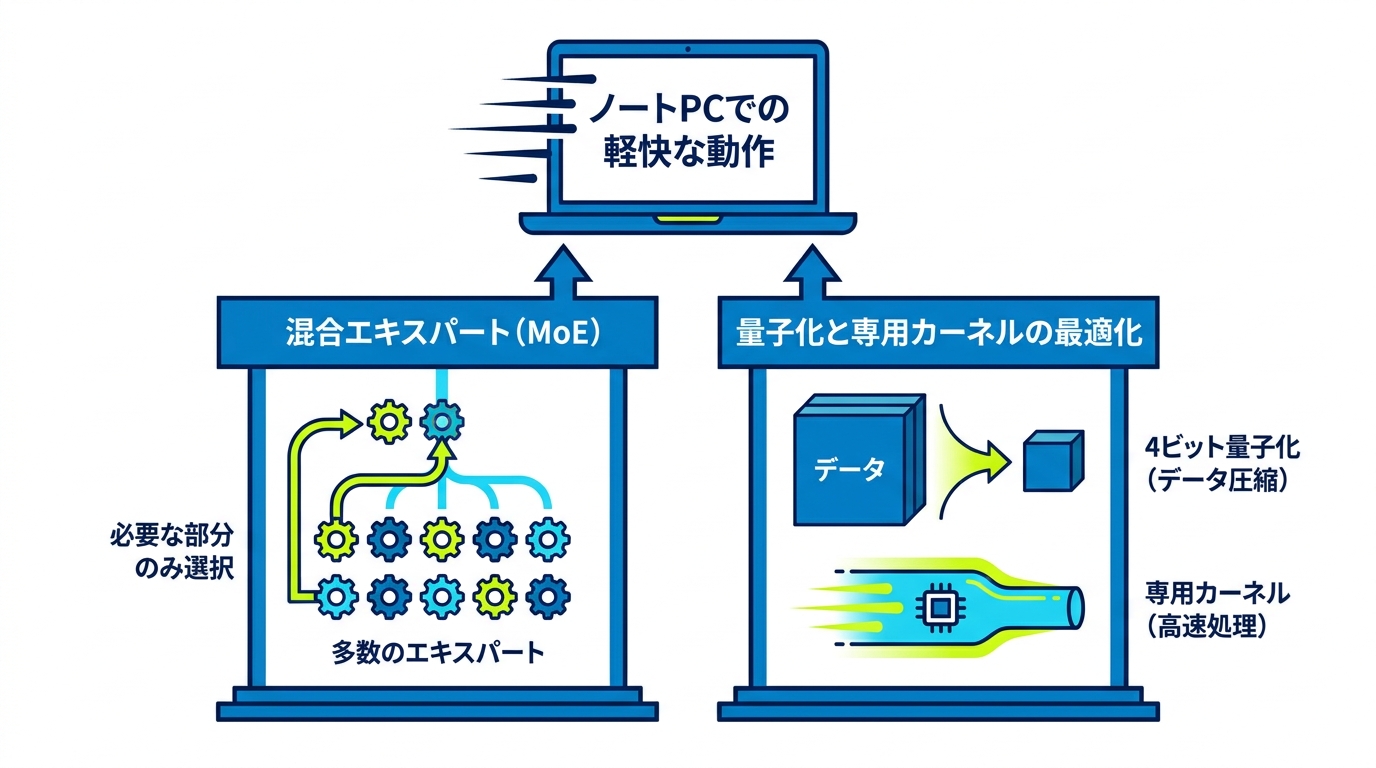
MoEは、個々のタスクに応じてモデルの一部のみを選択して処理する方式です。Flintでは、総計約400億個あるパラメータのうち、同時に稼働するのは25億個にとどまります。この構造により、一般的なノートPCでも無理なく稼働できるとTechCrunchは報じています(参照*4)。
では、Flintは具体的にどのような専門家の分け方をしているのでしょうか。モデルカードによると、MoE層あたり256個のルーティングエキスパートが用意され、トークンごとに6個が選ばれます。これらに加え、常に稼働する共有エキスパートも組み込まれています(参照*2)。
量子化と専用カーネルの最適化
軽快な速度を実現するもう1つの要因が、量子化と専用カーネルのチューニングです。量子化によって精度が落ちると実用性が下がりますが、Recursiveはその問題に対して工夫を凝らしています。
Recursiveは一般的なアプローチとは異なり、出力層(lm_head)まで4ビットへと量子化しました。Flintのアクティブパラメータは25億にとどまるため、出力層はトークン処理ごとに読み込む重みの大きな割合を占めます。
精度の低下を抑えるため、量子化モデル自身が発見したコアセットから事前にサンプリングした応答で学習を行う、オフライン蒸留ステップを導入しました。ここでは16ビットモデルを教師役として用いており、最終的なNVFP4モデルの各ベンチマークスコアは、16ビットモデルとの差が0.7ポイント以内に収まっているとされています(参照*3)。
また、カーネルもハードウェアに合わせて徹底的に最適化されました。Recursiveは低ビット射影やMoE演算、アテンション、プロンプト処理を担う専用カーネルを用意しています。M4およびM5チップ向けには、デコード時のフォワードパス全体を融合する「Metalメガカーネル」を開発しました(参照*3)。
NVIDIAの公式ブログでも、この最適化プロセスによりモデルの重みを変更することなく、RTX Spark環境におけるFlintの生成速度が55%向上したと述べられています(参照*5)。
私自身、llama.cppやLM Studioでローカルモデルを動かす場面が増えていますが、量子化モデルの品質劣化はモデルごとにかなりばらつきます。FlintがNVFP4で16ビットとの差を0.7ポイント以内に抑えたと報告しているのは、この点で注目に値する数値です。ただし、これはRecursive自身の計測であり、独立した第三者による再現検証を待ちたいところです。
モデルの軽量化幅については、経営トップのコメントも残されています。最高経営責任者のRichard SocherはX上で、低ビット化の取り組みによって品質をほぼ落とすことなくFlintを71%小型化できたと発言した旨が、TechCrunchにより報じられています(参照*6)。
実測されたローカル生成速度
実際の処理速度については、測定主体と実施環境を整理して読むことが重要です。開発元の公称値と、第三者の実測値では条件が異なることが多く、私はベンチマーク数値を見るとき、必ず「誰が・どのハードウェアで・どのコンテキスト長で測ったか」を確認するようにしています。
Recursiveによる公式テストでは、最適化済み推論エンジンを用いて短いコンテキスト条件下で速度を測定しています。M4 Pro搭載MacBook Proで毎秒125トークン以上、64GBのNVIDIA RTX Sparkで毎秒150トークン以上を記録し、同規模の競合モデルと比較して最大2倍の速度に達したと主張しています(参照*3)。
第三者メディアからも比較データが報告されました。TechCrunchの報道によれば、Apple M4 Proチップ搭載のMacBook Proを使ったRecursiveの測定で毎秒約131トークンをマークしています。同環境でGoogleのGemma 4やNVIDIAのNemotron 3.5 Lightningといった同格モデルが毎秒58〜69トークンであったのに対し、約2倍の速さを示しました(参照*4)。
ただし、文脈が長大化するにつれて処理速度は低下します。ある検証レビューでは、11万5,000トークン処理時の実測値が毎秒約9トークンまで落ち込む事例が示されました。とはいえRecursiveの比較検証によれば、12万8,000トークンのセッション時でもQwen3.8 27Bの約7倍の速度を維持していると報告されています(参照*7)。
AIが作ったAI:Eureka Machine
自動研究システムの役割
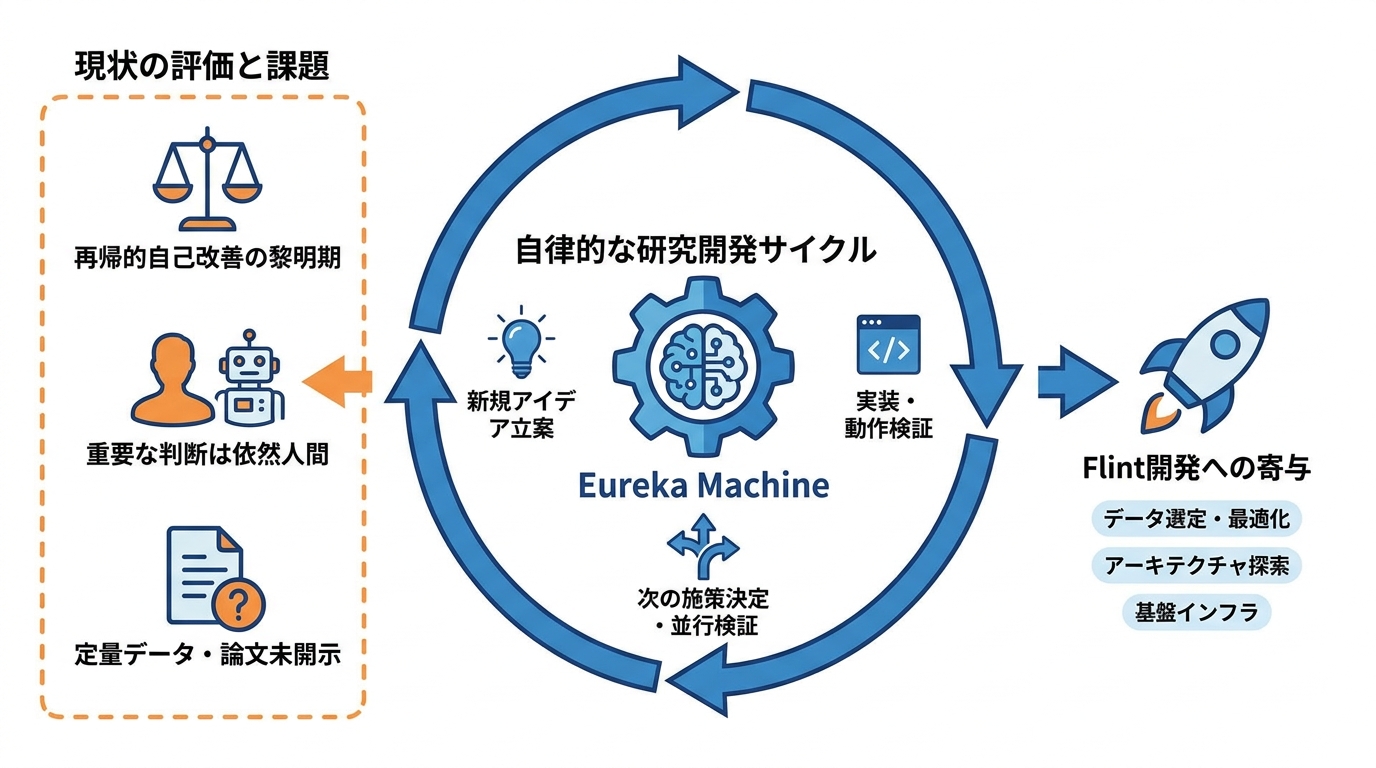
Flintの開発プロセスにおいて中核を担ったとされるのが、「Eureka Machine」と呼ばれる自動研究システムです。「AIがAIを開発する」という表現はキャッチーですが、実態を冷静に読み解く必要があります。
Eureka Machineは、研究開発サイクル全体を自律化するフレームワークだとRecursiveは解説しています。新規アイデアの立案や実装、動作検証を一手にこなし、その結果を踏まえて次の施策を決定します。
複数のアプローチを並行して検証し、過去の知見を継承しながら有望な手法を組み合わせる形です。その寄与はデータ選定、最適化アルゴリズム、学習レシピから、基盤インフラや推論効率化に至るまで、Flint開発の全域に及んだとされています(参照*3)。
設計選定の具体的な歩みも明かされています。アーキテクチャ探索は、有効パラメータ数30億を持つ350億パラメータのベースラインから始まり、最終的にFlintの「総計400億・有効25億」という仕様へと導かれました(参照*8)。
もっとも、効率化の定量的データは開示されていません。Eureka Machineの導入によって人間の研究時間が実際にどれほど削減されたのか、Recursiveはその詳細な数値を明かしていないとTechCrunchは指摘しています(参照*4)。
再帰的自己改善をめぐる評価
「AI自身がAIを開発する」という主張をどのように解釈すべきか、論点を整理します。
TechCrunchはFlintについて、再帰的自己改善の黎明期における実用実験と位置づけています。再帰的自己改善とは、AIがより高度なAIを構築し、その新たなAIがさらに発展したAIを生み出す連鎖的なアプローチを指し、業界内でも最も意見が分かれる分野の1つです。
AIが自らを進化させ続けることで人間の制御を離れるリスクを警戒する研究者も存在します。現段階でRecursiveが達成した範囲は、そうした懸念に比べれば限定的なものだと論じられています(参照*4)。
自動化の実像を分析したレポートもあります。700件超の実行ログを精査した調査によれば、AIエージェントが定型作業の大半を肩代わりしたものの、成否を分ける重要な研究判断の多くは依然として人間が下していたことが判明しました(参照*9)。これは私の感覚とも一致します。生成AI導入を支援してきた経験でも、AIが得意なのは候補の生成や定型処理であり、最終的な判断や品質の担保は人間が引き受けるという構図が繰り返し現れます。
また、客観的な検証の可否という課題も残ります。モデル公開に合わせて完全な技術論文が発表されていないため、Eureka MachineがFlintのベンチマーク性能にどれだけ寄与したかを第三者が検証する手段は整っていません。一連の主張は査読付き論文の定説ではなく、開発元によるプロセス報告として捉えるのが妥当です(参照*10)。私はDeep Research系の機能を検証してきた経験から、「調査レポートらしく見える文書ほど、読み手が内容を正しいと錯覚しやすい」という問題意識を持っています。Flintの主張も同様で、見た目の説得力と検証可能性は別物として扱うべきです。
ベンチマーク結果と読み方
公開されたスコアと測定条件
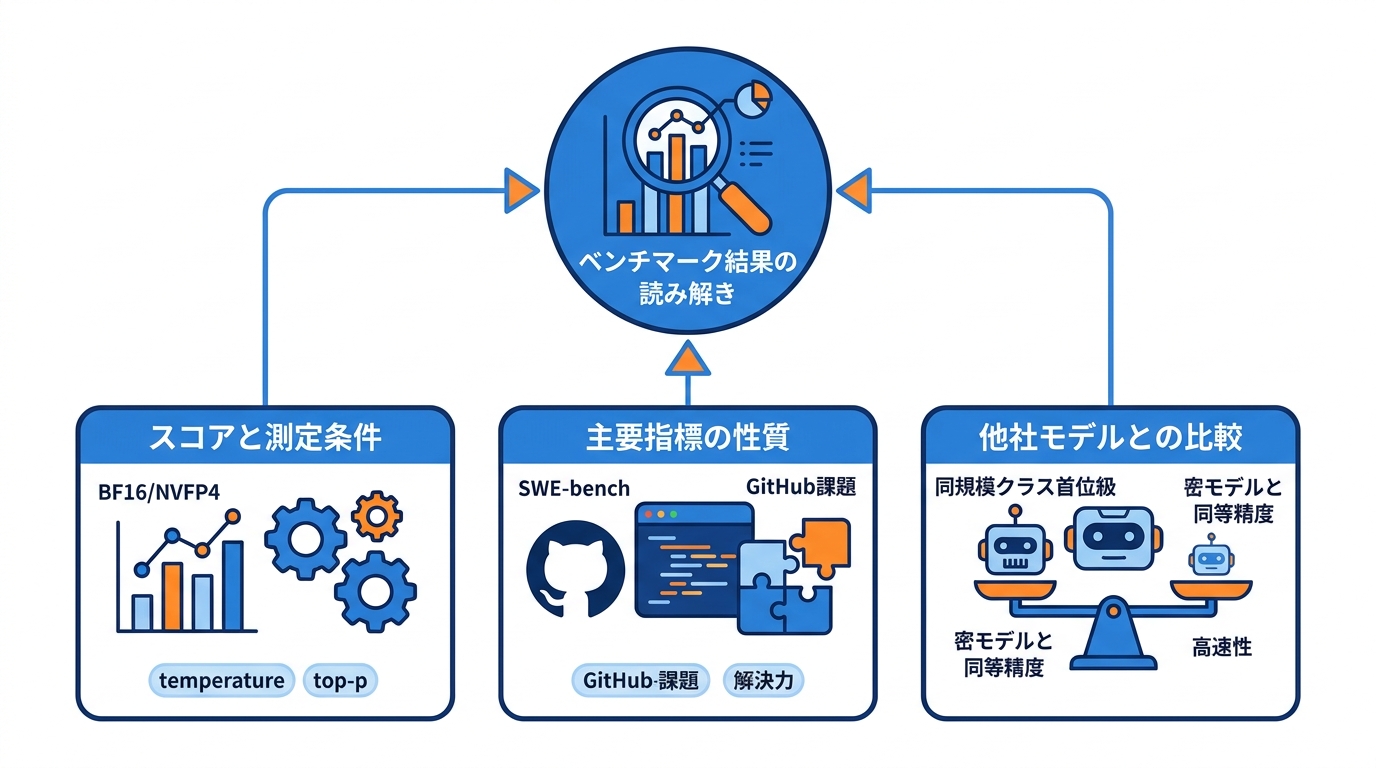
公表されたスコアと、その測定環境の詳細を合わせて確認します。ベンチマーク数値は条件次第で大きく変わるため、数字だけを切り取るのは危険です。
開示されたベンチマークスコアは、BF16形式とNVFP4形式の比較形式で提示されています(参照*11)。
- Terminal-Bench 2.1:BF16が54.9、NVFP4が53.7
- SWE-bench Pro v2:BF16が89.7、NVFP4が88.5
- SWE-bench Verified:BF16が74.2、NVFP4が74.1
- LiveCodeBench v6:BF16が80.3、NVFP4が80.8
- IFBench:BF16が89.2、NVFP4が88.1
- IFEval:BF16が95.1、NVFP4が94.6
主要指標であるSWE-benchの性質を知ることも評価の助けになります。SWE-benchは、GitHub上の実在するソフトウェア課題を用いて大規模言語モデルの解決力を評価するテストです。対象のリポジトリと問題文が入力されると、モデルは不具合を解消する修正パッチの生成を試みます(参照*12)。
測定時の詳細パラメータは、モデルカードに記されています。評価環境ではtemperature 1.0、top-p 0.95、top-k 20が適用され、Terminal-BenchではTerminus 2、SWE-benchではmini-swe-agentが利用されました。
エージェント評価スコアは最低5回の試行におけるpass@1の平均値です。なお測定条件は各媒体で異なり、FlintのTerminal-Bench評価ではWeb検索により得られた解答を不正解としてカウントしています(参照*2)。
同クラスモデルとの比較
他社モデルとの比較を通して、Flintの性能的な立ち位置を確かめてみます。
同規模クラスにおける優位性については、Recursiveの公式見解が報じられています。同社によれば、FlintはQwen3.6-35B-A3BやLaguna S 2.1など500億未満のパラメータを持つMoEモデル群の中で、SWE-bench Pro v2やTerminal-Bench 2.1、SWE-bench Verifiedといったコーディング指標で首位級の成績を収めたとされます。ただし、これらはまだ外部検証を経たデータではありません(参照*9)。
密モデル(Dense)との関係では、処理速度のアピールが目立ちます。Recursiveは、パラメータ数250億〜400億規模の密モデルに匹敵するコード生成精度を維持しながら、5倍以上の高速性で稼働できるとアピールしています(参照*3)。
一方で、得意・不得意のトレードオフも浮き彫りになっています。ある検証では、Terminal-Bench(55対73)やSWE-benchでQwen3-27Bに及ばず、LiveCodeBenchでほぼ互角のスコアにとどまりました。Recursiveの公開チャートでも、Flintの平均精度は約81%とされ、最高峰のローカルモデルが示す約85%に迫る水準と位置づけられています(参照*7)。
ローカルで動かす方法と必要環境
対応ランタイムと配布形式
ローカル環境で動かすにあたり、対応ソフトウェアや提供形式を整理します。
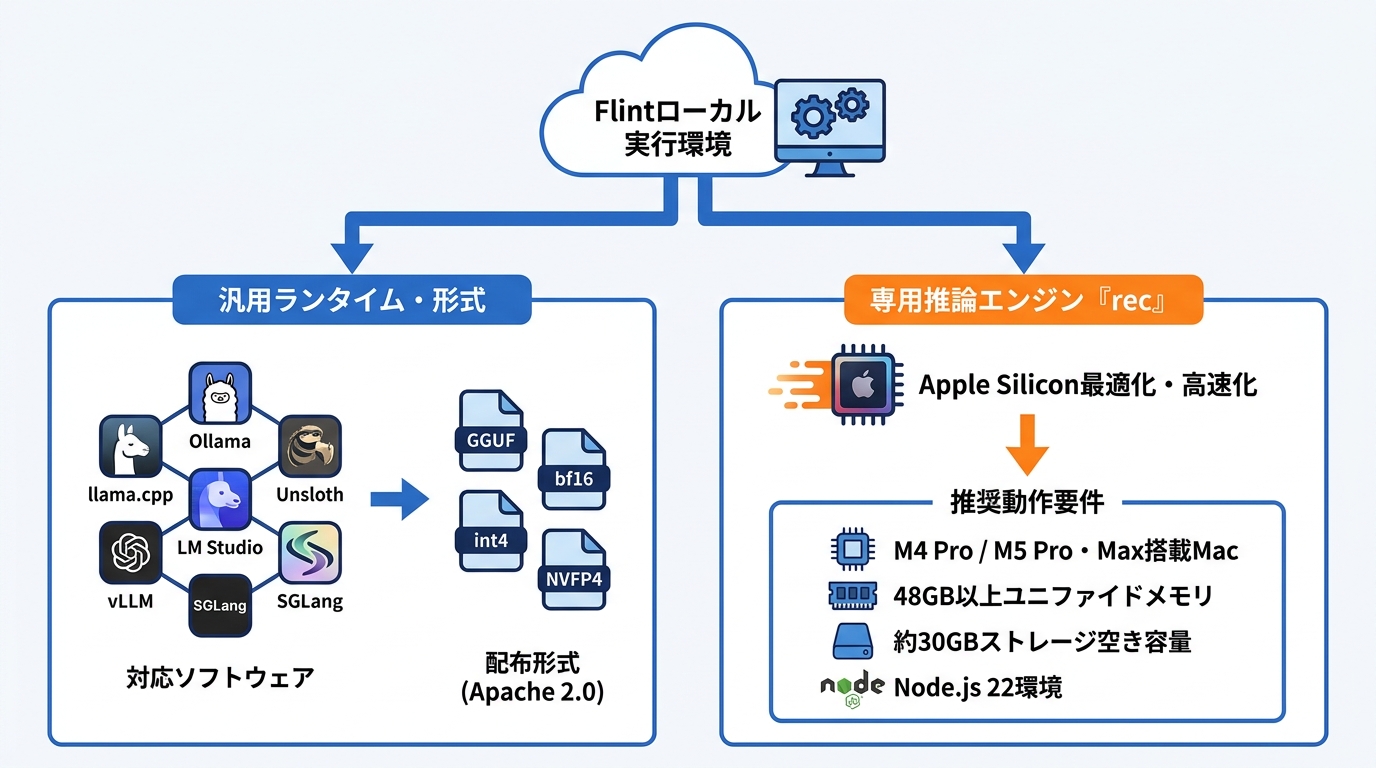
Flintは、定番のローカル実行環境に幅広く対応しています。モデルウェイトはApache 2.0で配布されており、llama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLangで稼働可能です。さらにRecursiveは、M4 ProやM5 Pro/Maxを積んだマシン向けに最適化を施した専用推論エンジン「rec」も公開しました(参照*8)。
Hugging Face上では、Apache 2.0のもとで4つのファイル形式が用意されています(参照*7)。
- GGUF
- bf16
- int4
- NVFP4
サーバー運用向けのサポート状況も整備済みです。vLLMはリリース当初からFlintをサポートし、NVFP4とBF16の両チェックポイントが単一GPUで動作します。コンテキスト長が10万トークンに達する環境でも、GB200 1基で単一リクエストを毎秒約500トークン処理できるとされています(参照*13)。
推論エンジンrecと動作要件
Apple Silicon向けの「rec」を利用するためのハードウェア条件を確認します。
recは、Recursive製モデルを手元の環境で軽快に動かすために設計されたカスタム推論エンジンです。シングルセッションの実行において卓越した推論速度を誇ります。llama.cppとの比較では、所定のコンテキスト長においてM4 Pro環境下のトークン処理速度が1.4〜2.6倍に向上すると発表されています(参照*14)。
推奨動作環境として、4つの条件が示されています(参照*14)。
- M4 Pro、M5 Pro、またはM5 Maxを搭載したApple Silicon Mac
- 48GB以上のユニファイドメモリ
- 約30GBのストレージ空き容量
- Node.js 22環境
GGUF形式で運用する際のメモリ条件はやや異なります。LM Studioの配布ページでは、FlintのGGUF版を実行するための最小システムメモリ要件が24GBと案内されています。
ただし実稼働時のメモリ消費量や生成速度は、量子化率やランタイム、ハードウェア仕様、コンテキスト長により変動します。最小要件を満たしていても、262Kトークンのフルコンテキストを安定して扱えるとは限らない点にご注意ください(参照*11)。
利用時の注意点と限界
Flintを実務に導入するにあたって、公式に示されている制限事項を把握しておく必要があります。私がAI活用の相談を受ける中で感じるのは、「便利そう」という印象だけで導入を進めると、出力検証の工程が後回しになるリスクが高いという点です。
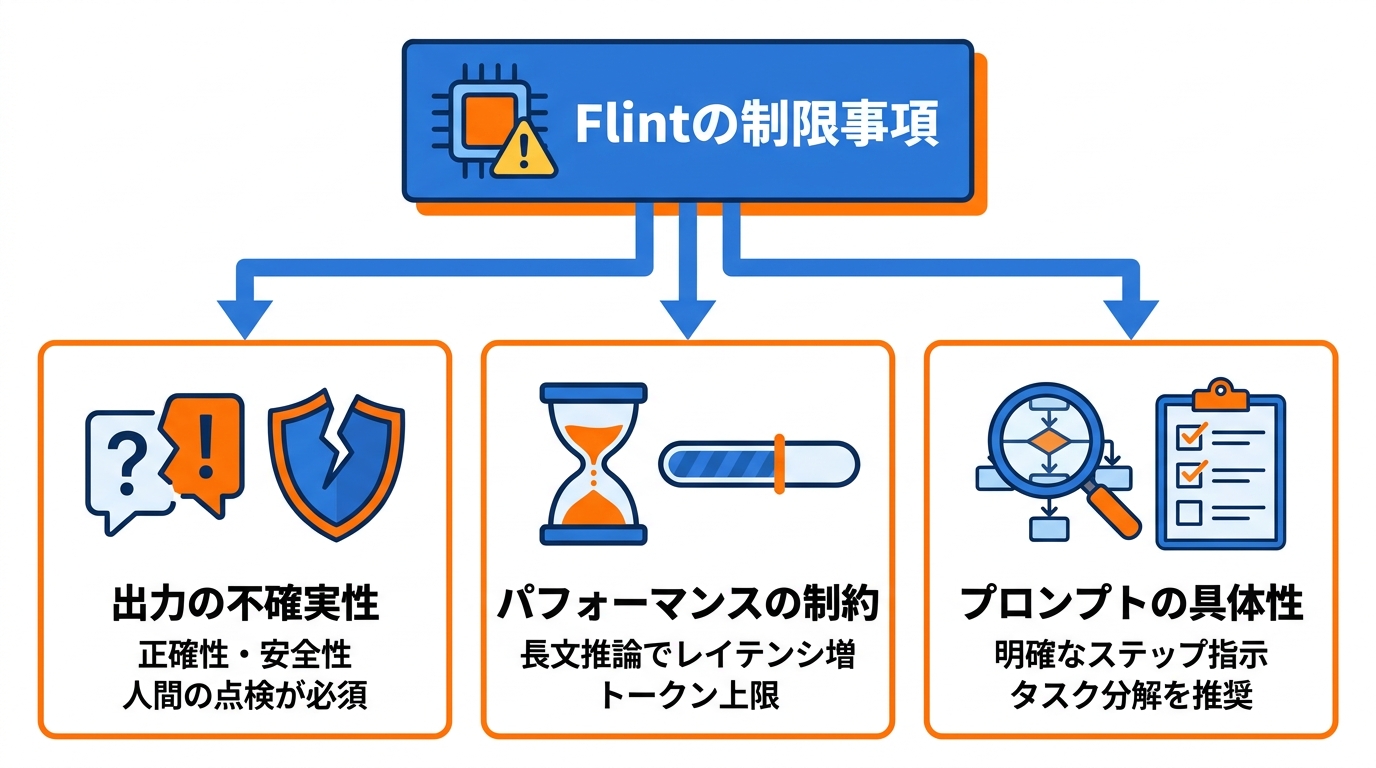
第一に、生成される出力の正確性は担保されていません。Flintの教師ありファインチューニングには安全性を高めるデータが含まれているものの、誤情報や有害な表現、不具合を含むコード、不適切なツール呼び出しを生成する危険性は残存します。
モデルカードでは、生成コードをテストし、重大なシステム変更を適用する前には必ず人間の目で点検するよう求めています。ツール連携を行うアプリケーションでは、独立した権限設定やセーフティ境界を設けるべきだとされています(参照*2)。
この点は、生成AIの業務導入全般に共通する課題です。AIの出力をそのまま使うことは、文章生成でも、コード生成でも、リスク管理の問題として扱う必要があります。誰がどの段階で確認し、間違っていた場合の責任はどこにあるかを、導入前に決めておくべきです。
長文推論に伴うパフォーマンスの低下も懸念材料です。思考ステップが長くなるとレイテンシが増加し、回答が途中で出力トークン上限に達する恐れがあります。
仕様上のコンテキスト長はあくまで最大受け入れ容量であり、あらゆる長さや難易度のタスクで均一な精度を約束するものではありません。出力品質はチェックポイントの精度や利用するランタイムによってもブレが生じます(参照*2)。
またプロンプトの記述方法に関して、Recursiveからの助言も公開されています。同社は、複雑なタスクを細かいサブタスクへ分解し、明確なステップを指示することを推奨しています。「Flintは優れた能力を備えていますが、使い慣れた巨大な商用モデルと比較すると、より具体的な指示出しを必要とするケースがあります」と案内されています(参照*15)。
おわりに
Flintは、トークンごとに最適なエキスパートを選択するMoEアーキテクチャと、4ビット量子化や専用カーネルのチューニングを融合させ、ノートPCでのエージェント開発を狙った意欲的なモデルです。データガバナンスと開発効率を天秤にかける企業にとって、Flint最大の強みは手元で完結する「自己管理性」にあります。完全オフライン環境で動作させれば、機密情報を端末内に留め、API課金も回避できます(参照*15)。私自身、クライアントからAI導入の相談を受ける際、「社外にデータを出したくない」という要求は非常に多いです。その意味で、性能と速度を両立したローカルモデルの選択肢が増えることは、現場の実態に即しています。
しかしながら、公表されたベンチマークスコアは現時点ではRecursive自身の公表値にとどまり、客観的な第三者検証は待たれる状況です(参照*9)。
Eureka Machineが果たした実際の貢献割合についても、完全な論文の開示がない以上、正確な評価を下すには時期尚早です(参照*10)。「AIが作ったAI」という表現は注目を集めますが、それが実際に何を意味するのかは、独立した検証を経て初めて判断できます。現時点では、技術的な可能性として興味深く追いつつ、主張の裏付けを待つというスタンスが適切だと私は考えています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) BenchLM – Flint Benchmarks & Context (October 2026)
- (*2) RecursiveSI/flint · Hugging Face
- (*3) Introducing Flint
- (*4) TechCrunch – Recursive launches Flint, a laptop coding model it says was largely built by AI
- (*5) NVIDIA Blog – Bringing the Spark to Europe: Local Intelligence Powers Next Wave of Agents
- (*6) TNW | Artificial-intelligence – Recursive releases Flint, a laptop coding model largely built by its own AI
- (*7) daily.dev – Recursive SI introduces Flint, a fast local coding model
- (*8) TestingCatalog AI News – Recursive releases Flint, 40B model for local coding
- (*9) The Decoder – Recursive shows first result of its AI-driven research process with Flint
- (*10) Tech Insider – Flint AI Coding Model Hits 89.7% on SWE-Bench [2026]
- (*11) Run Flint locally with LM Studio – Flint
- (*12) GitHub – SWE-bench/SWE-bench: SWE-bench: Can Language Models Resolve Real-world Github Issues? · GitHub
- (*13) GitHub – vllm-project.github.io/_posts/2026-10-21-flint.md at main · vllm-project/vllm-project.github.io · GitHub
- (*14) GitHub – recursive-oss/rec: Our lightning-fast inference engine. · GitHub
- (*15) VKTR.com – Recursive Says AI Helped Build Its New Local Coding Model in 4 Months