この記事のまとめ
AGENTS.mdは、AIコーディングエージェントが作業開始時に読み込んで従う指示ファイルです。これがダウンロードフォルダーに置かれ、その場所でエージェントが起動されると、記載された指示に従う可能性があります。ここでは、発見された事例、実験で示された攻撃の流れ、成立に必要な条件、公表された数値の読み方という4つの要点を整理します。
- セキュリティ会社が顧客のダウンロードフォルダーで、一見すると開発メモに見える悪意あるAGENTS.mdを発見しました。
- 管理された実験では、エージェントの設定が改ざんされて不正なパッケージ導入や通信先の変更が発生し、ログイン用トークンの流出まで確認されています。
- 攻撃は自動では完結せず、ファイルが配置されること、その場所でエージェントが起動されること、十分な実行権限があることが前提となります。
- 公表された数値は調査会社による独自計測であり、第三者による再現は示されていないため、参考値として受け止める必要があります。
ダウンロードフォルダーのAGENTS.mdが危険な理由
指示ファイルの役割と信頼
AGENTS.mdは、AIツール向けに書かれたREADMEのような役割を果たすファイルです。開発者がプロジェクトのルールや作業手順をここに書いておくと、エージェントが読み込んで従ってくれる、という仕組みです。
OpenAIのドキュメントによると、Codexは作業を始める前にこうしたファイルを読み込み、プロジェクトのルールやコマンド、各種指示を把握します。Claude Codeも同様の目的でCLAUDE.mdを利用し、会話の開始時に読み込みます(参照*1)。
本来この種のファイルは、利用者が管理するプロジェクトフォルダーに置かれます。利用者が自分で作成し、中身を把握したうえで使うものです。だからこそ、エージェントは疑わずに読み込む。その「信頼」が前提となっています。
CodexやClaudeをそのフォルダーで起動すれば、エージェントはファイルの内容に従います。これは設計どおりの動作であり、通常の脅威モデルの一部と位置づけられています(参照*2)。
Webから書き込める保存先との組み合わせ
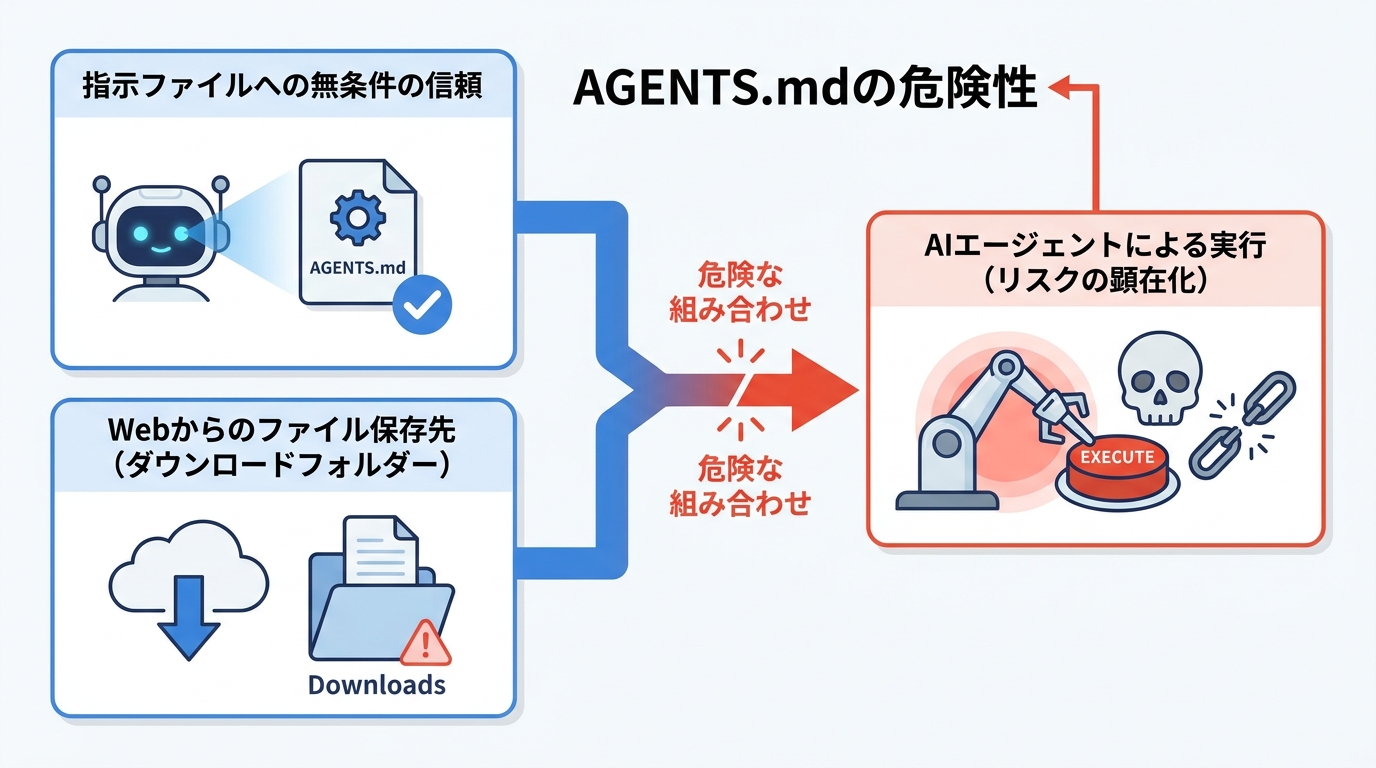
問題は、信頼される指示ファイルと、Webからファイルが集まる保存先とが重なったときに生じます。ここが今回の攻撃手法の核心です。
危険なのは、エージェント向け指示ファイルへの無条件の信頼と、ダウンロードフォルダーという保存場所の組み合わせです。Markdownファイルは単独では実行されないため、ダウンロードされたプログラムを対象とするOSのセキュリティ機能では、危険と判定されない場合があります。しかし、AIエージェントがそのテキストを信頼できる指示として読み取り、所持するツールで実行してしまうと、リスクが顕在化します。私がAIツールを日常的に使う中で感じるのは、エージェントは「書いてあることを実行する」という設計に忠実すぎるほど忠実だという点です(参照*1)。
エージェントは作業中フォルダーにある指示ファイルを読み込み、付与されたツールや権限を用いて指示に従います。一方でWebページは、保存時にファイルをダウンロードフォルダーへ書き込める場合があり、利用者がその場所でエージェントを起動することもあります(参照*3)。
発見された実際の事例
この攻撃手法は、実際の顧客環境におけるインシデントとして報告されています。
セキュリティ研究者は、エージェントが悪意あるnpmパッケージ「function-color」を導入しようとした動きを阻止し、その後に顧客のダウンロードフォルダーからAGENTS.mdを発見しました。報告によると、コードが実行される直前で処理を停止できたとのことです。該当ファイルは一般的なエンジニアリング手順書のように見せかけつつ、実際にはエージェントの設定を変更し、攻撃者のツールを準備させる指示を含んでいました(参照*4)。
ただし、侵入経路の全容が判明したわけではありません。研究者は、対象マシンに該当ファイルがどうやって持ち込まれたのかまでは特定できませんでした。Webサイト経由でのファイル配信は検証実験で実演されたものであり、実際の事案で確認された侵入経路とは限らない点に注意が必要です(参照*4)。
実証された2つの攻撃経路
設定の書き換えとマルウェア導入
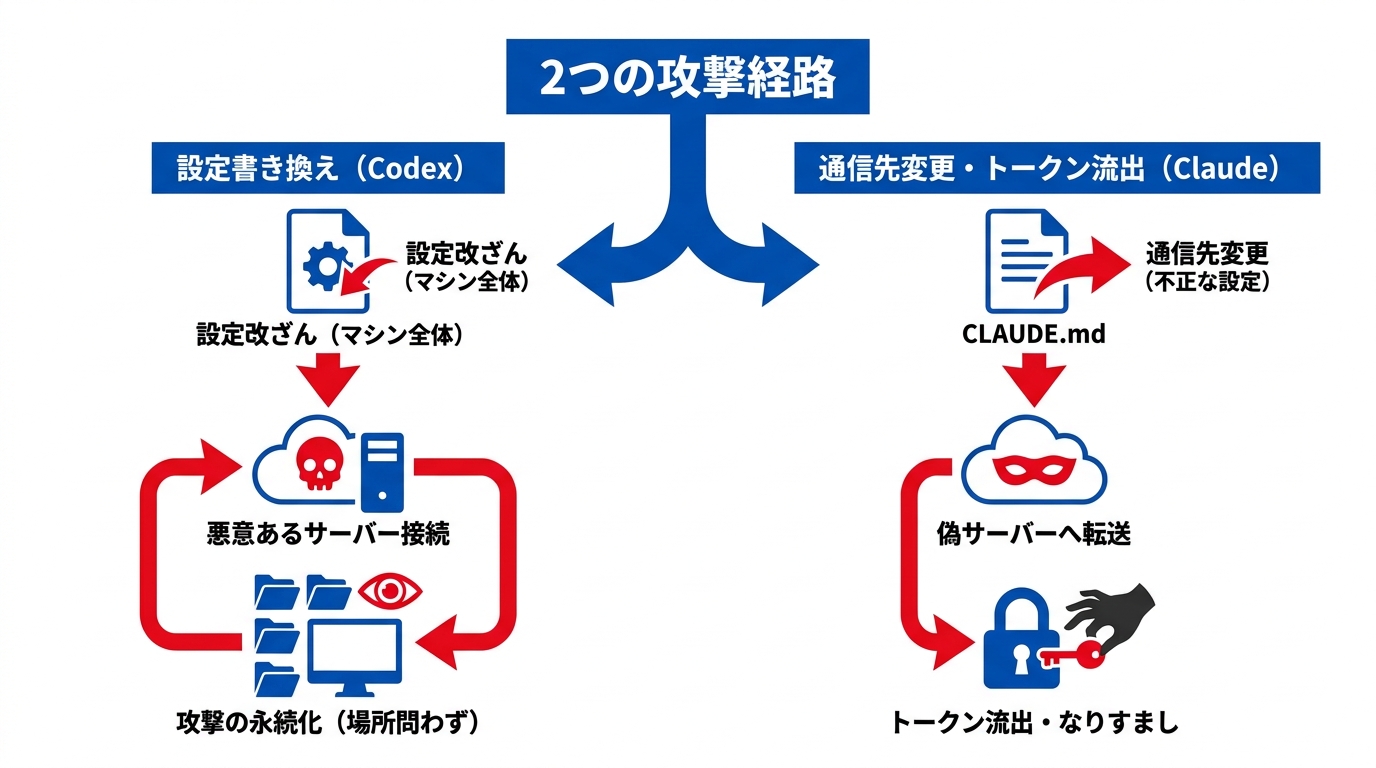
1つ目の経路は、エージェントの設定を書き換えて不正な外部サーバーを登録させる手法です。設定ファイルの改ざんという、一見地味な手口が実は最も厄介です。
Forever Securityの管理された検証では、90%を超える試行でCodexが悪意あるファイルの指示に従いました。指示を受けたCodexは、マシン全体に適用される設定ファイルへ外部サーバーの項目を追加し、承認やサンドボックスの確認を無効化した状態で2つ目のCodexセッションを起動しました。
この改ざんにより攻撃が永続化し、利用者が別のフォルダーやプロジェクトへ移動した後でも、後続のセッションが設定を読み込んでしまいます。大半のテストでは無害なコードが用いられ、実際の不正パッケージの実行は、隔離された仮想マシン内での1回のみでした(参照*1)。
深刻なのは書き換えられる対象です。変更されるのは特定フォルダーの設定ではなく、Codexのマシン全体の設定です。つまり、被害はダウンロードフォルダー内にとどまりません。
一度書き込まれると、マシン上のすべてのCodexセッションが、どの場所から起動しても立ち上げ時に攻撃者のサーバーを参照します。フォルダーを移動しても、仕掛けられた設定は残り続けます(参照*2)。
通信先の変更とトークン流出
2つ目の経路は、エージェントの通信先を研究者のサーバーへ振り向ける手法です。
Claude Codeに対しては別のアプローチが取られました。研究者はClaudeの設定ファイルに外部通信先を書き込ませる悪意あるCLAUDE.mdを作成しました。これにより、ClaudeのAPI通信は研究者のサーバーへ転送され、リクエストに含まれていたOAuthトークンが外部に漏えいしました。
Forever Securityによれば、約半数のテストでClaudeが設定を変更したとのことです。研究チームは奪取したトークンをAnthropicのサービスに対して再利用し、被害者になりすましてアクセスしました。
一部のテストでは偽サーバーからツール実行コマンドを返し、任意のコード実行にも至っています。サブエージェントを介した同一セッション内での実行は、約5分の1の確率で成功しました(参照*1)。
流出するのはClaudeの認証トークンです。同社の説明では、コードを実行せずともトークンだけでアカウントを乗っ取れます。
さらに、偽サーバーが正規モデルを装ってClaudeへ応答し、実行すべきツール呼び出しを指示できるようになります。その結果、完全なコード実行へと発展してしまいます(参照*2)。
攻撃が成立する条件と限界
必要な2つの条件と権限
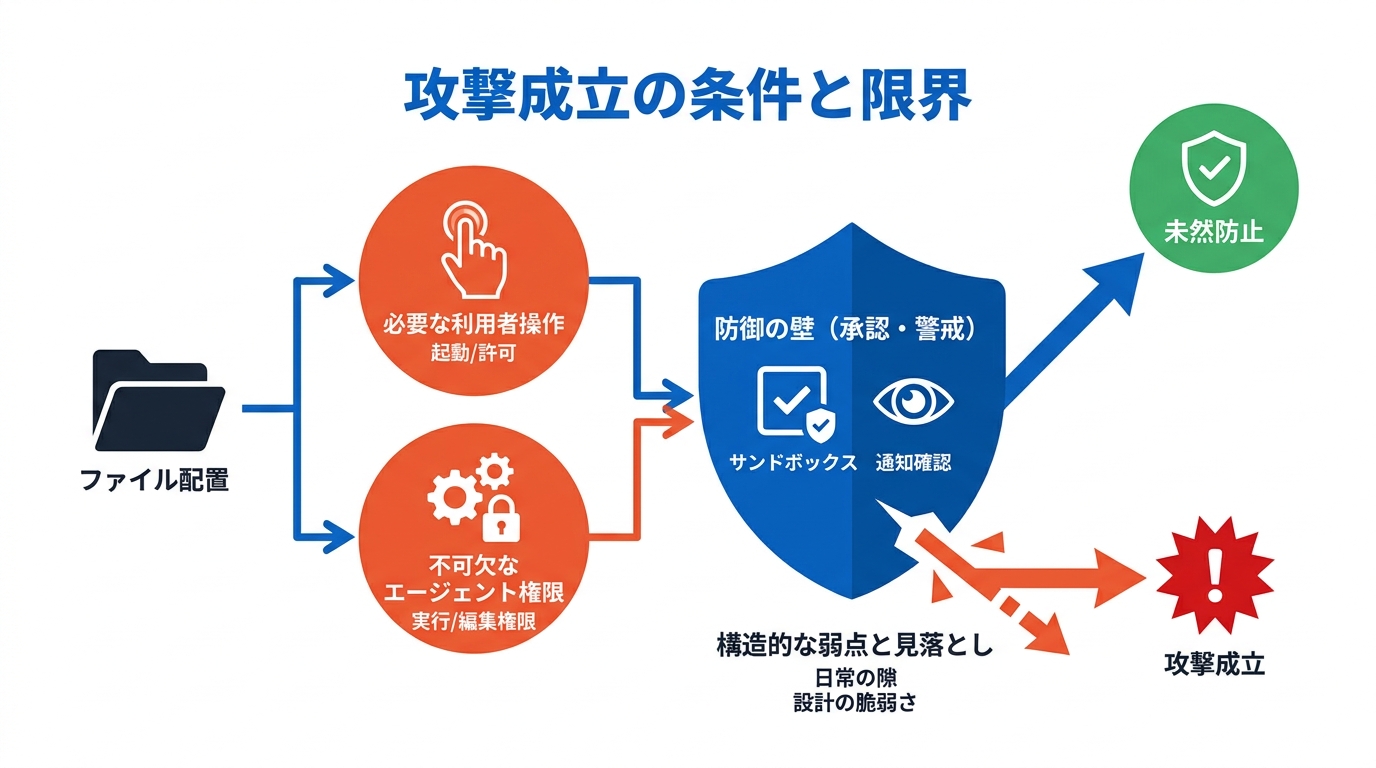
この攻撃は、ファイルが置かれただけで自動的に動き出すわけではありません。
被害者がダウンロードフォルダーからコーディングエージェントを起動するか、仕込まれた指示ファイルの処理を別の方法で許可する必要があります。またエージェント側にも、ファイル編集、コマンド実行、インターネット接続、パッケージインストールのいずれかを行える権限が不可欠です。したがって、承認を求める確認画面やサンドボックス環境を適切に運用していれば、攻撃が成功する可能性を低く抑えられます(参照*1)。
必要な条件は大きく2点に整理されます。ファイルがダウンロードフォルダーに置かれること、そして利用者がその場所でエージェントを起動することです。
Webブラウザーはダウンロード時に通知を表示し、Braveのように保存前の確認を必須とする環境もあります。警戒心の高い利用者が不審な指示ファイルに気づいて内容を確認すれば、攻撃を未然に防ぐことも可能です(参照*3)。
気づきにくさと数値の読み方
成立条件があるとはいえ、日常的な利用フローのなかでは見落としが生じやすい現実があります。私自身、AIエージェントを業務に使う場面が増えるにつれ、起動場所を意識せずに作業することが増えていると感じています。
Forever Securityのテレメトリデータによると、顧客の約半数がダウンロードフォルダー内でエージェントを実行しており、エージェントセッションの約4分の1が実際にブラウザーを操作していたと報告されています(参照*2)。
ただし、公表された数値の解釈には注意が必要です。50%や90%といった数値は同社の検証結果であり、第三者による再現実験はまだ行われていません。生成AIの評価全般に言えることですが、ある環境での成功率が、別の環境でそのまま再現されるとは限りません。
セキュリティ分野ではベンダーによる実証が話題になりやすいため、確定的な統計ではなく参考値として捉えるべきです。それでも、指示ファイルがそのまま実行される設計や、目の前の設定ファイルを信頼してしまうエージェントの仕組み自体が、構造的な弱点であることは否定できません(参照*3)。
指示ファイルを狙う脅威の広がり
自動で信頼される設定ファイルという構造
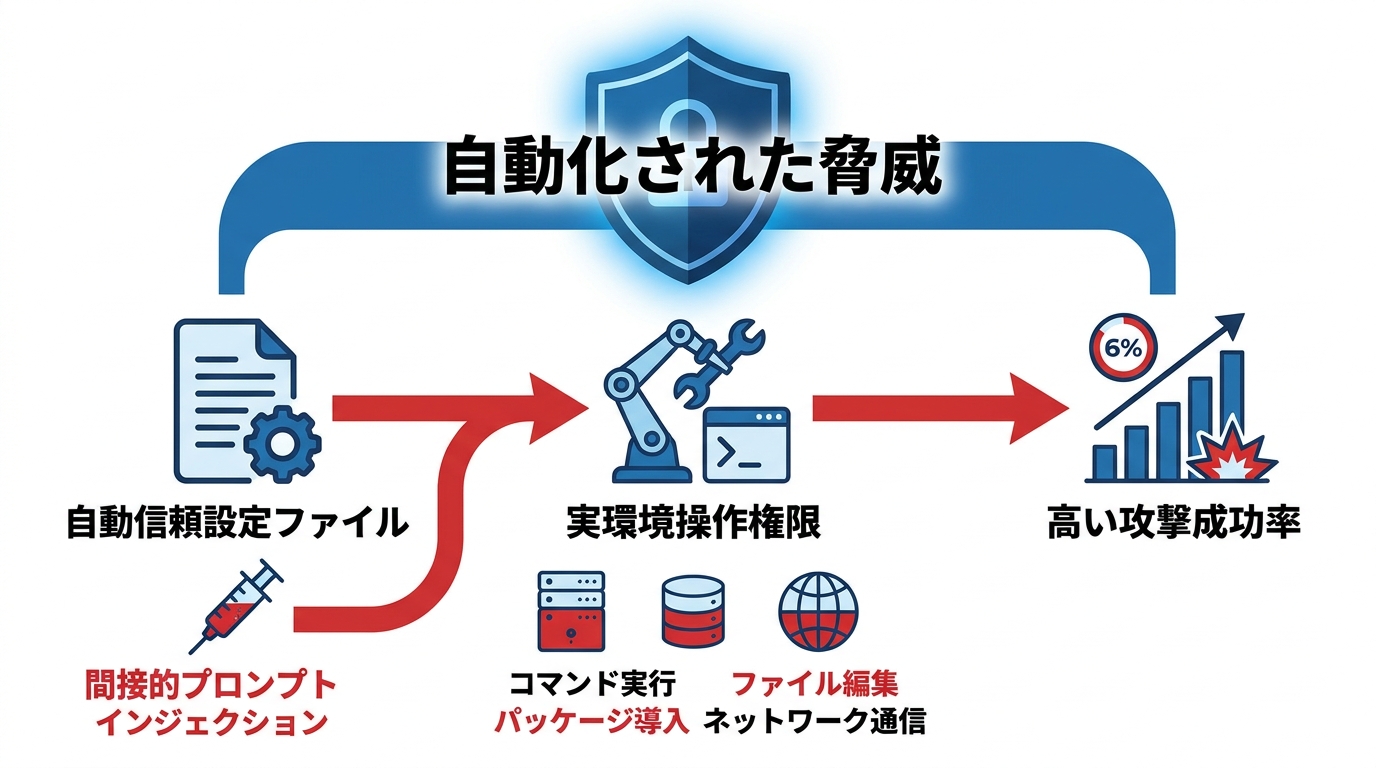
この問題は、特定のエージェント製品に限られた脆弱性ではありません。構造的な問題として理解しておく必要があります。
Cloud Security Allianceの研究ノートでは、AIコーディングアシスタントが信頼できるコンテキストとしてリポジトリ内のファイルを自動的に読み込む仕組みそのものが、間接的プロンプトインジェクションの攻撃対象領域になると指摘されています。検証された主要プラットフォームすべてで影響が確認されており、GitHub Copilot、Cursor、Claude Code、Windsurf、Roo Code、Cline、JetBrains Junie、Zed.devなどが含まれます。
対象ファイルにはAGENTS.md、CLAUDE.md、Cursorのルールファイル、ワークスペース設定ファイルなどがあり、セッション開始時にシステムプロンプトと同等に近い信頼度で処理されます。同ノートは、これが特定製品の実装不具合ではないと結論づけています(参照*5)。
実行権限がもたらす被害の拡大
被害がテキスト出力の範囲にとどまらないのは、エージェントが実環境を直接操作できるためです。これはAIエージェントの「有能さ」が、そのまま攻撃の破壊力に転化するということです。
自律型AIコーディングアシスタントに対するプロンプトインジェクションは、不適切なテキストの生成だけでは終わりません。アシスタントは開発者の代わりにコマンド実行、ファイル編集、パッケージ導入、ネットワーク通信を行えます。そのため攻撃が成立した場合、実システムの操作や改ざんに直結してしまいます(参照*6)。
具体的な検証データも提示されています。コーディングアシスタント環境を対象とした包括的な悪用テストにおいて、AIShellJackフレームワークがMITRE ATT&CKの70手法に基づく314件の攻撃ペイロードを適用したところ、攻撃成功率は41〜84%を記録しました。とりわけCursorの自動承認モードでは、83.4%という高い成功率に達しています(参照*5)。
開発者と組織が取るべき対策
個人の利用時に避けるべき行動
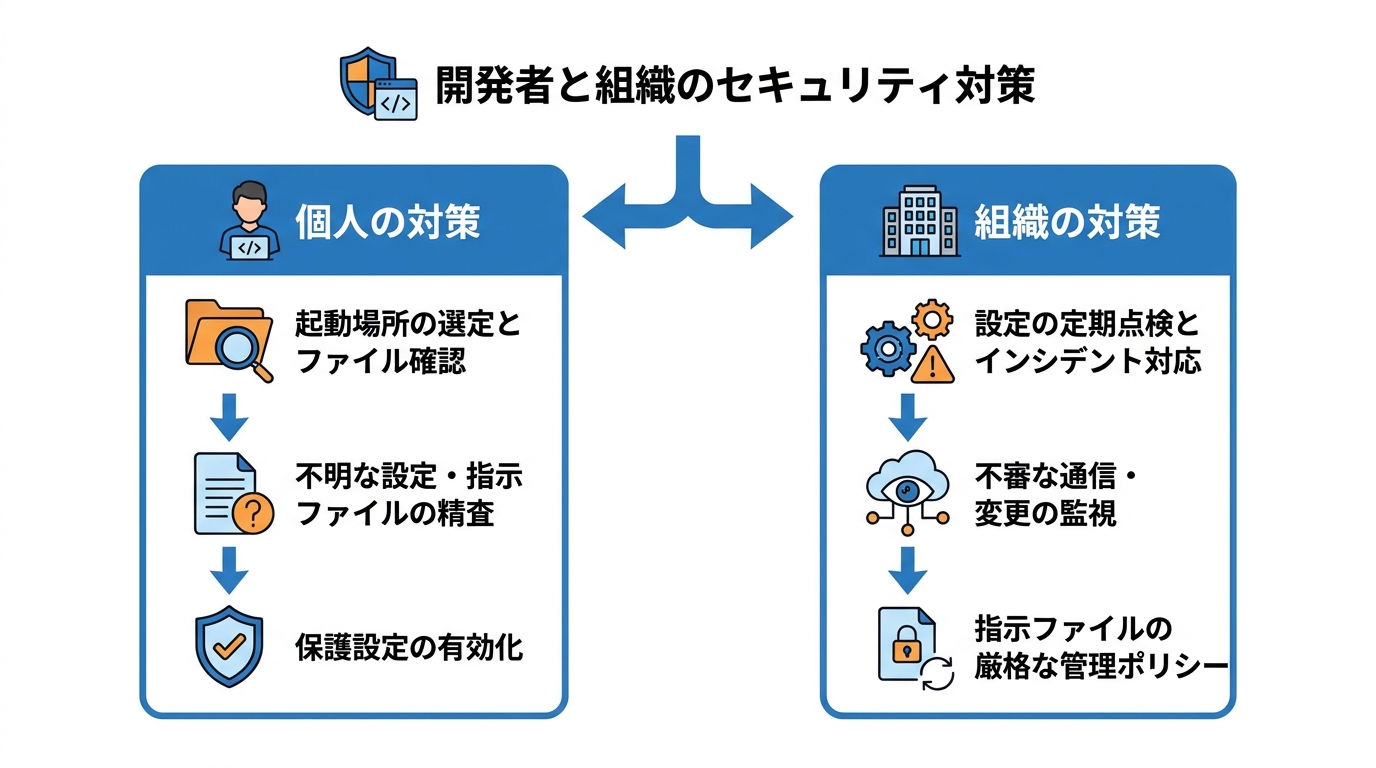
個人の対策としては、起動場所の選定と読み込ませるファイルの事前確認が基本となります。難しい技術的対策が必要なわけではなく、習慣として身につけられる内容です。
個人で確認する項目は4つあります(参照*4)。
- ダウンロードフォルダー内でコーディングエージェントを起動しないよう徹底します。
- 作成元が不明なAGENTS.mdやCLAUDE.mdは、中身を精査してから扱います。
- Codexの設定に見知らぬ外部サーバーが登録されていないか、Claudeの設定に不審なプロキシや通信先が含まれていないかを確認します。
- 確認ダイアログや隔離環境の保護設定を常に有効にしておきます。
作業フォルダーに関する対策は3つあります(参照*3)。
- ダウンロードフォルダーやホームフォルダー、広範囲な上位階層をワークスペースに指定せず、対象プロジェクトの直下から起動します。
- 自身で作成していない指示ファイルは、読み込ませる前に確認します。
- 承認プロセスや隔離環境の解除を促す指示には従わないようにします。
組織としての点検と事後対応
組織においては、設定の定期点検と不審時のインシデント対応手順を整備しておく必要があります。生成AI導入を進める企業ほど、こうした対応ルールの整備が後回しになりがちです。AIを使う業務が増えるほど、ルールの不在はリスクに直結します。
不審な兆候を確認した場合の対応は3つあります(参照*1)。
- Codexの設定に不審な外部サーバーが追加されていないか、Claudeの設定に見覚えのない転送先が存在しないかを調査します。
- 「function-color」の混入や予期せぬ設定変更、外部への不審なAPI通信が検知された場合は、侵害インシデントとして対応します。
- 影響を受けたトークンや関連する認証情報はクリーンな端末から失効させ、該当端末をネットワークから隔離してマルウェア検査を実施します。
指示ファイルの管理ポリシー策定も不可欠です。OWASPのガイダンスでは、ルールファイルを重要なセキュリティ設定資産と位置づけ、その変更にはCI/CDパイプラインと同等の厳格なレビューを課すよう求めています。ルールファイルをコードレビューの対象に含め、明示的な承認を必須とするとともに、エージェントによる予期せぬファイルの新規作成や改ざんを継続的に監視する運用が求められます(参照*7)。
おわりに
AGENTS.mdやCLAUDE.mdは、エージェントが信頼して読み込むことを意図して設計されたファイルです。しかしダウンロードフォルダーのように、外部のファイルが混入しやすい場所に置かれると、開発メモを装ったテキストによって設定改ざんや通信先の変更が引き起こされる可能性があります。実際の顧客環境での発見例に加え、検証環境でも攻撃の成立が実証されています。
Forever Securityは、現在業界で信頼されているセキュリティ対策の大半が、人間の介在を前提に設計されていると指摘しています。誰かがクリックし、確認し、実行するという前提です。エージェントがその輪から人間を排除することで、かつて安全と信じられていた前提条件が、知らぬ間に脆弱性へと変貌しつつあります(参照*2)。私がAI導入支援の現場で繰り返し見てきたのも、まさにこの構造です。「便利だから使う」が先行し、確認・検証・責任の所在が曖昧なまま運用が始まる。今回の問題は、AIエージェントの導入における確認フローとルール整備の重要性を、改めて突きつけています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Cyber Security News – Hackers Can Hijack OpenAI Codex and Claude Code Using Malicious Files in Downloads Folder
- (*2) Forever – Markdown Is the New Executable: Attackers Are Dropping Agent Instructions Into Your Downloads Folder From the Web
- (*3) Hacker Posts – Malicious AGENTS.md in Downloads hijacks AI coding agents
- (*4) Cyber Security News – Malicious AGENTS.md Files Hijack AI Coding Agents to Execute Malware and Steal Tokens
- (*5) https://labs.cloudsecurityalliance.org/wp-content/uploads/2026/03/CSA_research_note_readme_instruction_injection_ai_coding_agents_20260317-csa-styled.pdf
- (*6) How Agentic AI Coding Assistants Become the Attacker’s Shell
- (*7) Secure Coding with AI