この記事のまとめ
SWE-2 Flashは、Cognitionが低コストと高速化を目指して開発したコーディング向けモデルです。Cognitionの発表によると、大型の兄弟モデルであるSWE-2と比べて価格は5分の1、速度は3倍であり、ベンチマーク結果も近い水準に達しています。押さえておきたいポイントは次の3点です。
- SWE-2 FlashはDevin DesktopとCLIで利用でき、SWE-2比で価格5分の1、速度3倍とCognitionは説明しています。
- Terminal-Bench 4.0ではSWE-2の27.3に対してSWE-2 Flashが20.0、FrontierCode 2.0ではSWE-2の23.8に対して24.0を記録しました。モデルサイズはSWE-2のほうが10.1倍大きくなっています。
- モデルウェイトはまだ一般公開されておらず、信頼できる業界パートナーや研究機関へ安全に共有するプログラムを準備中で、詳細は数週間以内に案内される予定です。
SWE-2 Flashの概要と特徴
低コスト・高速モデルの位置づけ
SWE-2 Flashは、日常的なエンジニアリング作業にかかるコストの削減を狙った、Cognition初の「小型高速」コーディングモデルです。
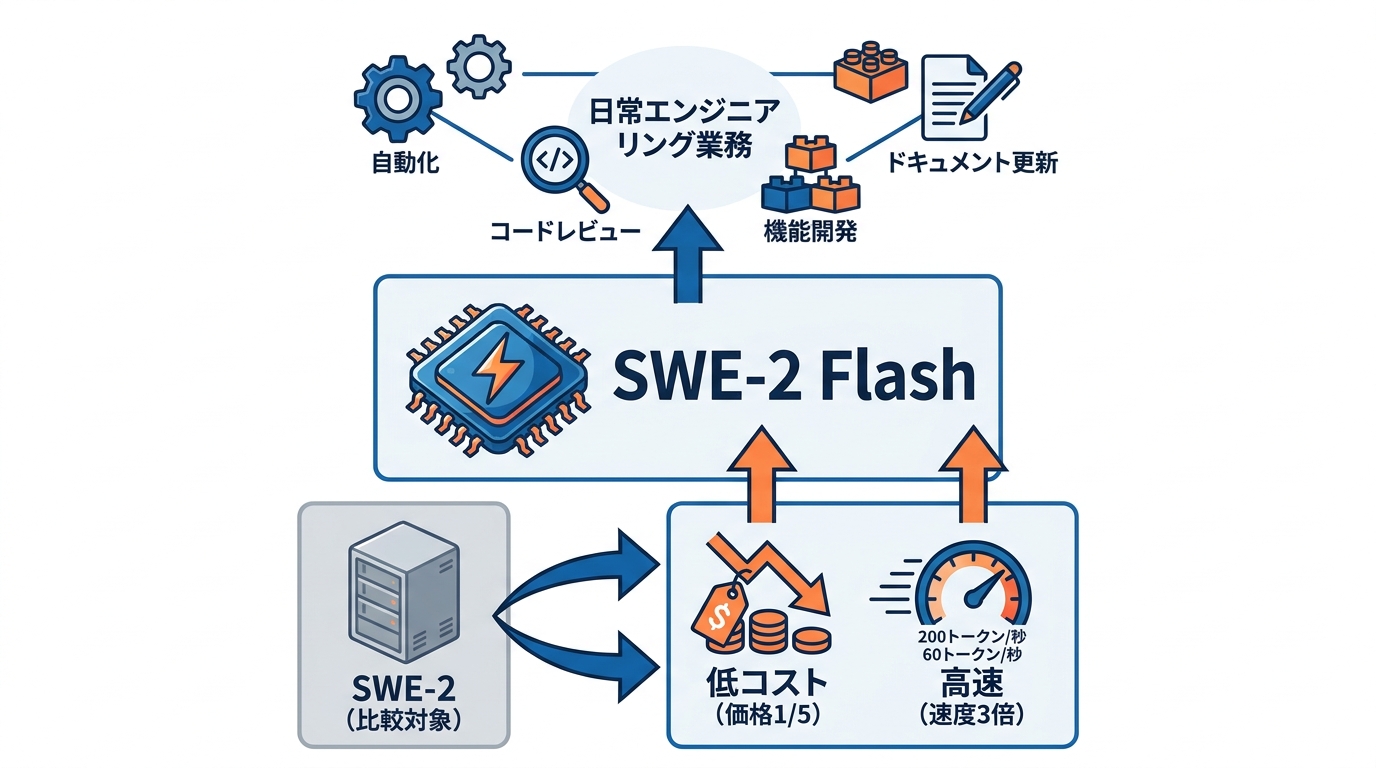
Cognitionは、モデル性能の最前線を押し広げるだけでなく、日常業務におけるエンジニアリングコストの抑制にも注力していると説明しています。同社によれば、小型モデルであっても、ソフトウェアエージェントが担う作業のうち、自動化やコードレビュー、機能開発、ドキュメント更新など多くの部分をカバーできるようになってきました。こうした需要の高まりに応えるために開発されたのがSWE-2 Flashです(参照*1)。
私がAI活用の現場を見ていて感じるのは、「性能最高峰のモデルを常に使う」という発想が必ずしも最適ではないという点です。コーディング補助にしても、ドキュメント整備にしても、タスクの9割は最先端モデルでなくても十分にこなせます。コストと速度のバランスで実務が回るかどうかが決まるため、SWE-2 Flashのような低コスト・高速モデルの登場は、現場の導入判断を変える可能性があります。
Cognitionは、SWE-2 Flashを低コストと高速性によって知能の新たな基準を確立する、完全米国製のコーディングモデルと位置づけています。本モデルでは初めて、強化学習の前に中間学習の段階が追加されました。提供環境はDevin DesktopおよびCLIです(参照*1)。
価格5分の1・速度3倍の意味
価格と速度の比較基準には、同じくCognitionが開発した大規模モデルであるSWE-2が用いられています。
Cognitionの発表によると、SWE-2 Flashは大規模な兄弟モデルであるSWE-2に比べ、価格が5分の1、速度は3倍とされています。つまり、価格を抑えつつ、トークンの出力ペースが速くなる関係にあります(参照*1)。
速度の目安として、SWE-2 Flashが1秒あたり200トークン、SWE-2が1秒あたり60トークンという数値が示されました。トークンとは、モデルが文章やコードを処理する際の細かな構成単位です。
この比較は、Terminal-Bench 4.0のgsea-proteomicsタスクにおける各モデルの挙動を、毎秒200トークンと60トークンを想定して再現したものです。比較しやすいよう、トランスクリプトは双方とも同一の長さに短縮されています(参照*1)。
SWE-2とのスコア比較
主要ベンチマークの数値
ベンチマークの種類によって、SWE-2とSWE-2 Flashのスコア差の現れ方は異なります。この点は、数字だけで優劣を断定しないために重要です。
主要な比較結果は3つあります(参照*1)。
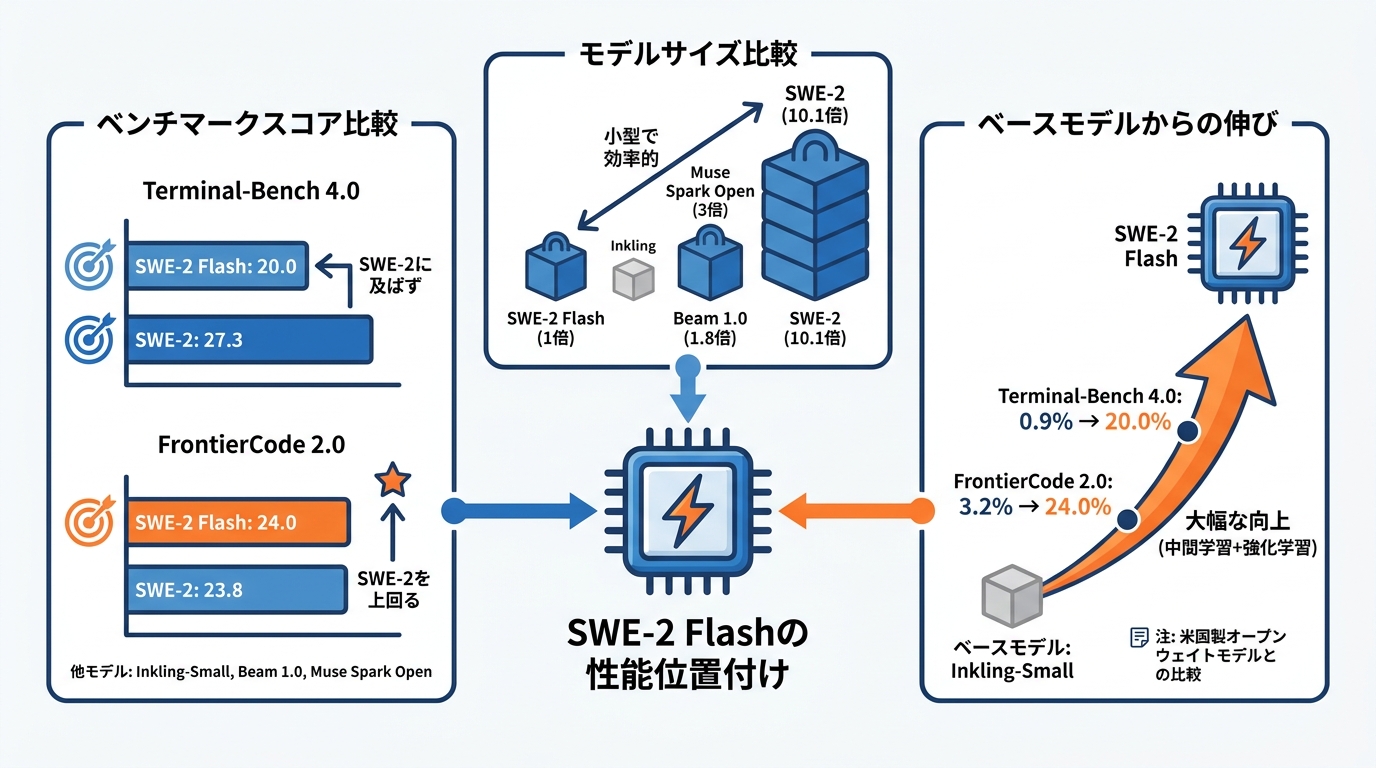
- Terminal-Bench 4.0のスコアは、SWE-2 Flashが20.0、Inkling-Smallが0.9、Beam 1.0が4.0、Muse Spark Openが8.0、SWE-2が27.3でした。このベンチマークではSWE-2 FlashはSWE-2に及んでいません。
- FrontierCode 2.0では、SWE-2 Flashが24.0、Inkling-Smallが3.2、Beam 1.0が2.9、Muse Spark Openが6.2、SWE-2が23.8となりました。
- モデルサイズは、SWE-2 Flashを1倍と置いた場合、Inkling-Smallが1倍、Beam 1.0が1.8倍、Muse Spark Openが3倍、SWE-2が10.1倍です。
FrontierCode 2.0のスコアは、各評価基準の項目に重み付けを行って集計されています。ブロッキング基準を満たさない解答は0点と判定されます。コストは、公開割引を反映したAPIの定価に基づき、1回実行あたりの平均米ドル支出額として算出されています(参照*2)。
ベースモデルからの伸び
SWE-2 Flashのスコアは、基礎となったベースモデルから大幅に向上しています。
Cognitionによると、SWE-2 FlashはベースモデルであるThinking MachinesのInkling-Smallを大きく凌駕しました。Terminal-Bench 4.0のスコアは0.9%から20.0%へ、FrontierCode 2.0のスコアは3.2%から24.0%へと向上しています。この飛躍は、中間学習と強化学習を適切に積み重ねた成果だと説明されています(参照*1)。
なお、比較対象の範囲にも留意が必要です。Cognitionは、主要な評価ベンチマークにおいて、SWE-2 Flashが3倍の規模を持つモデルを含む米国製オープンウェイトモデルをすべて上回っていると述べています。ここで比較されているのは米国製のオープンウェイトモデルに限定されており、あらゆるモデルが網羅されているわけではありません(参照*1)。
一点、留意しておきたいのは比較対象の範囲です。「米国製オープンウェイトモデルをすべて上回る」という表現は、クローズドモデルや非米国製モデルを含まない限定的な比較です。私は新モデルの発表を見るたびに、宣伝文句ではなく手元のタスクで実力を確かめることを優先しています。ベンチマーク数値は参考にしつつ、実際の業務でどの程度使えるかを別途検証する姿勢が必要です。
高い性能を支える学習の工夫
強化学習前の中間学習
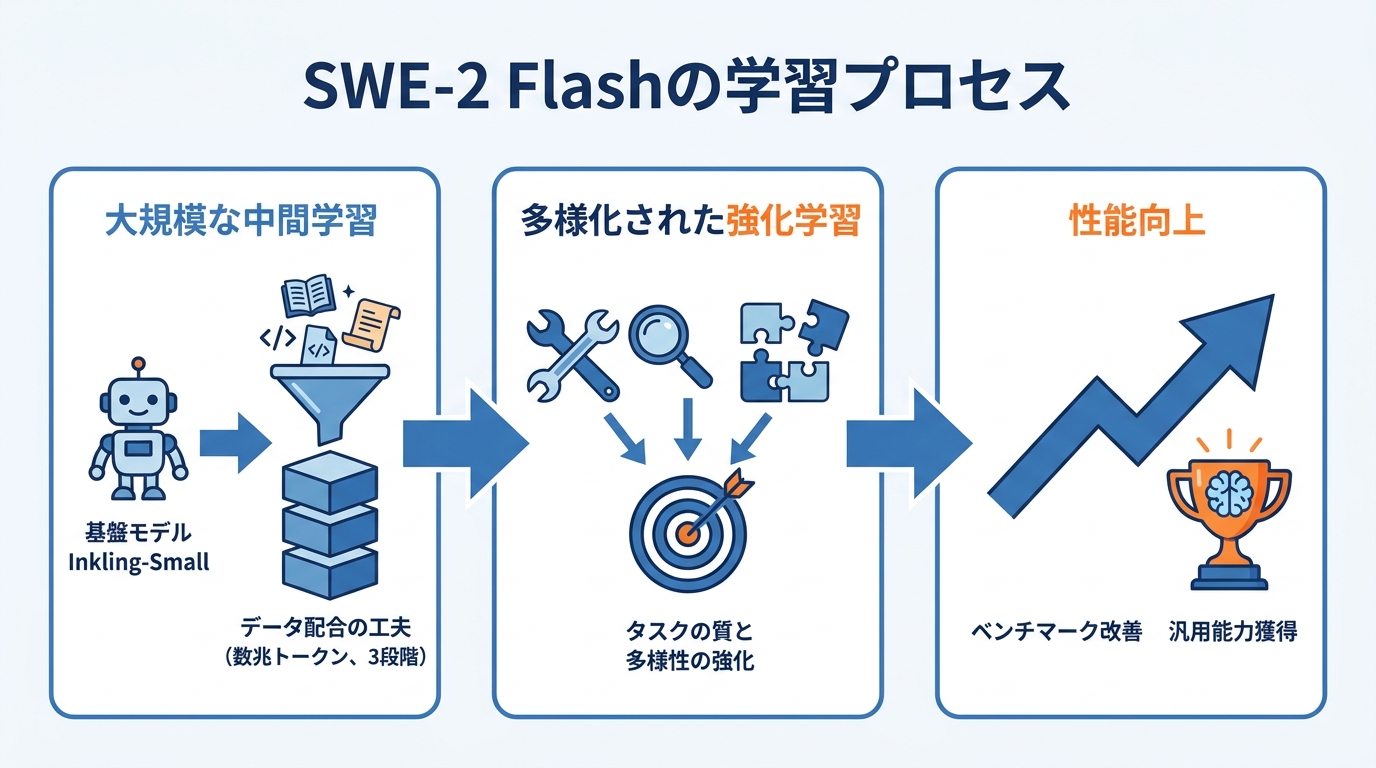
SWE-2 Flashの性能向上の鍵は、強化学習の前段階として導入された大規模な中間学習にあります。Cognitionはこのモデルで初めてこの中間学習ステップを採用しました。
出発点となったのは、総パラメーター数276B、アクティブパラメーター数12Bを誇るモデル、Inkling-Smallです。Cognitionはこのモデルを基盤に大規模な中間学習を行いました。
最大の難関は、どのデータをどのような比率で混合させるかという配合の判断でした。同社はその判断基準として、実際のソフトウェア開発現場における推論能力が正確に反映されるよう、高品質な保留コーディングデータセットを構築しました(参照*1)。
データの配合は幾度も調整され、最終的に数兆トークン規模の高品質な科学論文、ブログ、コードなどから構成されるデータセットへと結実しました。学習は3段階で実施され、最も希少で質の高いデータを後半に投入する工夫が凝らされています。全段階を通じて、検証用データにおける損失値(予測のずれ)は安定した推移で減少しました(参照*1)。
強化学習とタスクの多様化
中間学習に続いて実施されたのが、大規模な強化学習プロセスです。
Cognitionは、SWE-2で確立した強化学習手法を微調整したうえで、性能向上の大半はタスクの質と多様性を大幅に強化したことによるものだと説明しています。品質面では、タスク指示文や実行環境の設定、検証ツールの精度を綿密に再検討しました。多様性の面では、従来よりもはるかに広範な能力を網羅する新規タスクを複数設計しています(参照*1)。
同社は、これら一連の取り組みを通じて、Devinの実務運用に求められる汎用的な推論力や問題解決能力を向上させたと述べています。そして、この強化データを用いた学習により、測定対象となったほぼすべてのベンチマークで顕著な改善が確認されました(参照*1)。
ウェイト公開と安全性の扱い
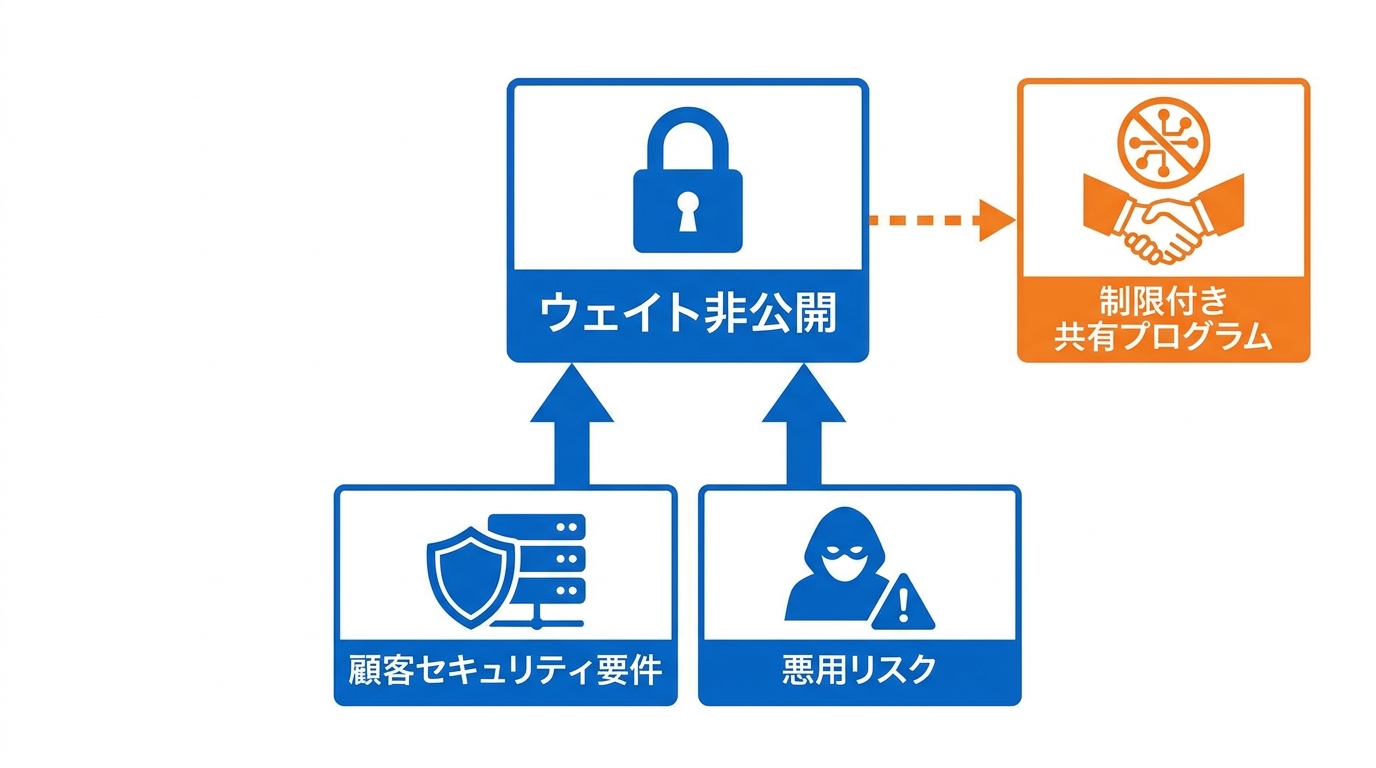
SWE-2 Flashのウェイト、すなわちモデルの内部パラメーター値は、現時点では一般公開されていません。
Cognitionは、その背景として利用企業側のセキュリティ要件を挙げています。機密性が高く極めて重要な業務環境において、顧客はAPI経由でアクセスできる高性能モデルだけを求めているわけではありません。
サイバーセキュリティ用途での重要性が増すほど、リスクもさらに高まります。そのため企業や政府機関からは、オンプレミスを含む自社インフラ上に環境を構築し、挙動を制御・監視するための可観測性が求められていると同社は述べています(参照*1)。
Cognitionは防御側の支援を目的として、サイバーセキュリティ関連タスクを学習に組み込み、モデルのExploitBenchスコアを11.3%から34.8%へと高めました。しかし、近年のサイバー攻撃の急増が物語るように、高度な能力は悪意ある攻撃者に悪用される危険もはらんでいます。そのため、同社はウェイトの一般公開に慎重な姿勢をとっています(参照*1)。
その代替策として進められているのが、制限付きの共有体制です。Cognitionは、透明性の確保と安全性の担保を両立させる方針として、信頼できる業界パートナーや学術機関にウェイトを安全に共有するプログラムを整備しています。具体的な詳細は数週間以内に公表される見込みです(参照*1)。
Devinでの使い分けの材料
リードとサイドキックの役割分担
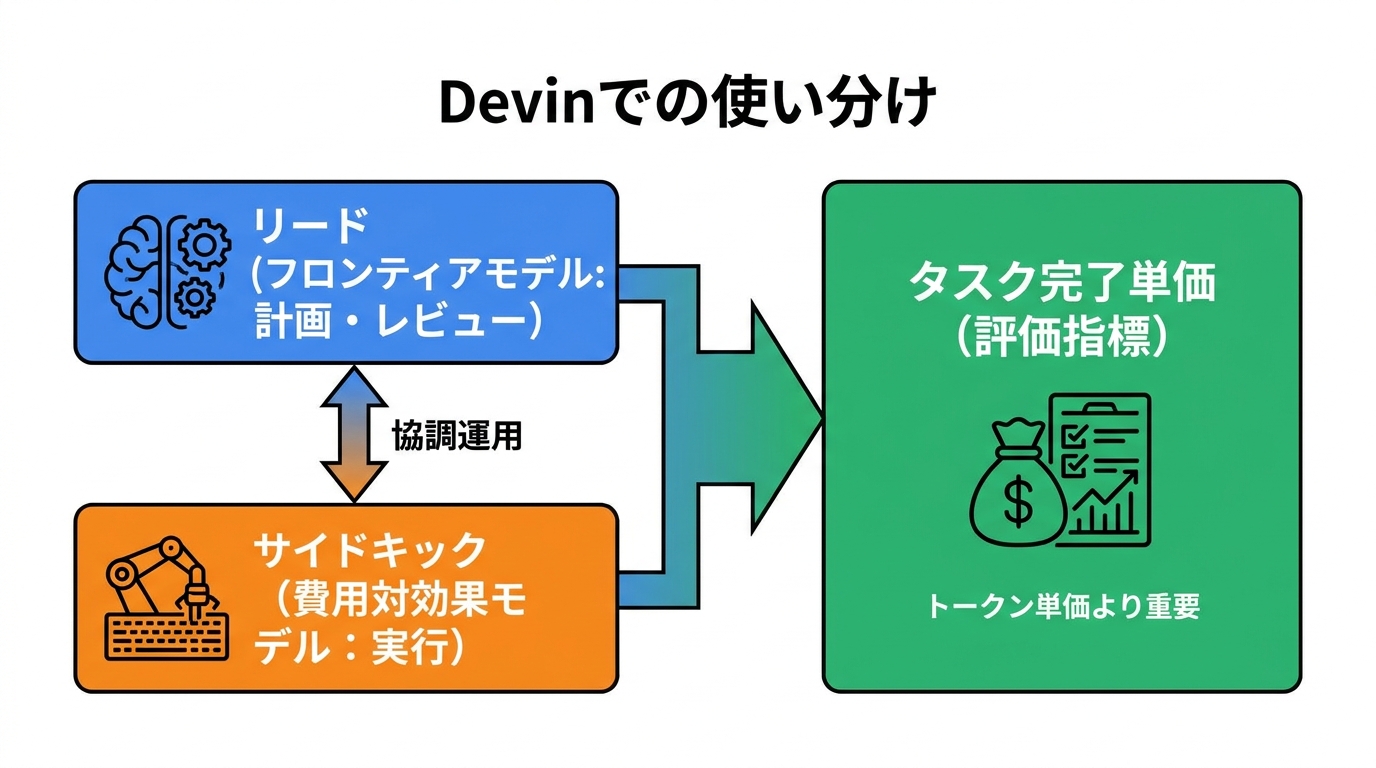
Devinでは、特徴の異なる2つのモデルを協調させて運用する設計思想が採用されています。これは、AIツールを「1つのモデルに何でもやらせる」発想から脱却した設計として注目に値します。
Cognitionの解説によると、Fusion機能では単一モデルではなく2種類のモデルを併用します。計画策定とレビューを担うフロンティアモデルを「リード」、実行を担う費用対効果の高いモデルを「サイドキック」と位置づけています。同社は最良の結果を得られる組み合わせとして、Opus 5.5とGPT-6 Lunaのペアを推奨しています(参照*3)。
ただし、適切な役割分担には課題も残ります。すべての開発タスクに最先端水準の知能が必要なわけではなく、定型作業は低価格モデルに任せ、高度な推論や設計が必要な場面でのみ高性能モデルを動かす手法は一見効率的です。しかし、初期のプロンプト入力の段階ではタスクの真の難度を正確に見極めにくいという問題も指摘されています(参照*3)。
トークン単価よりタスク単価
開発コストの最適化は、単なる1トークンあたりの価格だけでは判断できません。この視点は、生成AIの業務導入を検討する際に見落とされがちな重要な点です。
Cognitionは、より単価の高いモデルを採用したほうがシステム全体のトータルコストを削減できる事例が存在すると述べています。これはリードとサイドキックの双方に該当します。
トークン単価は総コストを構成する一要素にすぎず、先端モデルのトークン消費効率が向上している点や、両モデル間の連携プロセスが洗練されている点が背景にあります。これらを踏まえ、同社は2026年にはモデルやハーネスの構成をトークン単価ではなくタスク完了単価で評価すべきだと提唱しています(参照*3)。
私自身、生成AIの導入支援をしていて気づくのは、「トークン単価が安いモデルを選べばコストが下がる」という思い込みが意外と根強いという点です。実際には、精度が低いモデルを使うと再実行や人間による修正コストが増え、トータルでは高くつくケースがあります。タスク完了単価という発想は、AI活用の費用対効果を正確に測るうえで、現場に定着させたい考え方です。
実例として、サイドキックにGPT-5.6 Luna(高)を用いた場合、公称価格は100万トークンあたり0.20ドルであり、Astra(高)Fusionでのスコアは62.0、FrontierCodeでのコストは2.39ドルでした。一方、サイドキックをSWE-2(中)に置き換えると、100万トークンあたり0.75ドルと単価は275%跳ね上がるものの、結果は63.4へと向上し、総コストは2.34ドルと2%圧縮されました(参照*3)。これは特定のベンチマーク環境下で計測された検証値です。
おわりに
SWE-2 Flashは、Devin DesktopおよびCLIに対応したコーディング向けモデルであり、Cognitionの発表によればSWE-2比で価格が5分の1、速度が3倍に達します。Terminal-Bench 4.0ではSWE-2の27.3に対して20.0、FrontierCode 2.0ではSWE-2の23.8に対して24.0と、測定基準によって優劣の出方は異なります。ベンチマーク数値は単一の指標で評価せず、実際の業務タスクへの適合性とセットで見ることが重要です。
モデルサイズはSWE-2が10.1倍と大きく、小型モデルでありながら肉薄する水準を示している点が特徴です。モデルウェイトはまだ一般公開されておらず、信頼できる業界パートナーや研究機関向けの安全な共有体制について、詳細は数週間以内に案内される予定です。「タスク完了単価」という観点でモデルを選ぶ時代に、SWE-2 Flashは選択肢の一つとして具体的に検討できるモデルになっています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))