この記事のまとめ
Apsara Conferenceで示されたAlibabaのロードマップは、モデル・チップ・クラウドを自社で垂直統合するという構想でした。大きな数値が注目を集めますが、多くは将来的な目標や計画です。読み解くための軸は3点あります。
- Qwen 4は訓練中で、続くQwen 4.5やQwen 5では5兆〜10兆パラメータへの拡大が計画されています。現行のQwen 3.8 Maxは2.4兆パラメータです。
- 最大の注目点は、Qwen3.8-Maxが1か月以上の全自動実行で33回の反復サイクルを完了したとされる、再帰的自己改善の進展にあります。
- チップのZhenwu V900は2027年第1四半期の量産予定、データセンターは2032年までに20GW超が目標であり、いずれも達成に向けた計画段階です。
Alibabaロードマップの骨格
Qwenのモデル計画とパラメータ規模
まずはモデルの計画から確認します。数字が大きいほど注目を集めますが、発表された計画値と現在稼働中のモデルは、きちんと区別して読む必要があります。
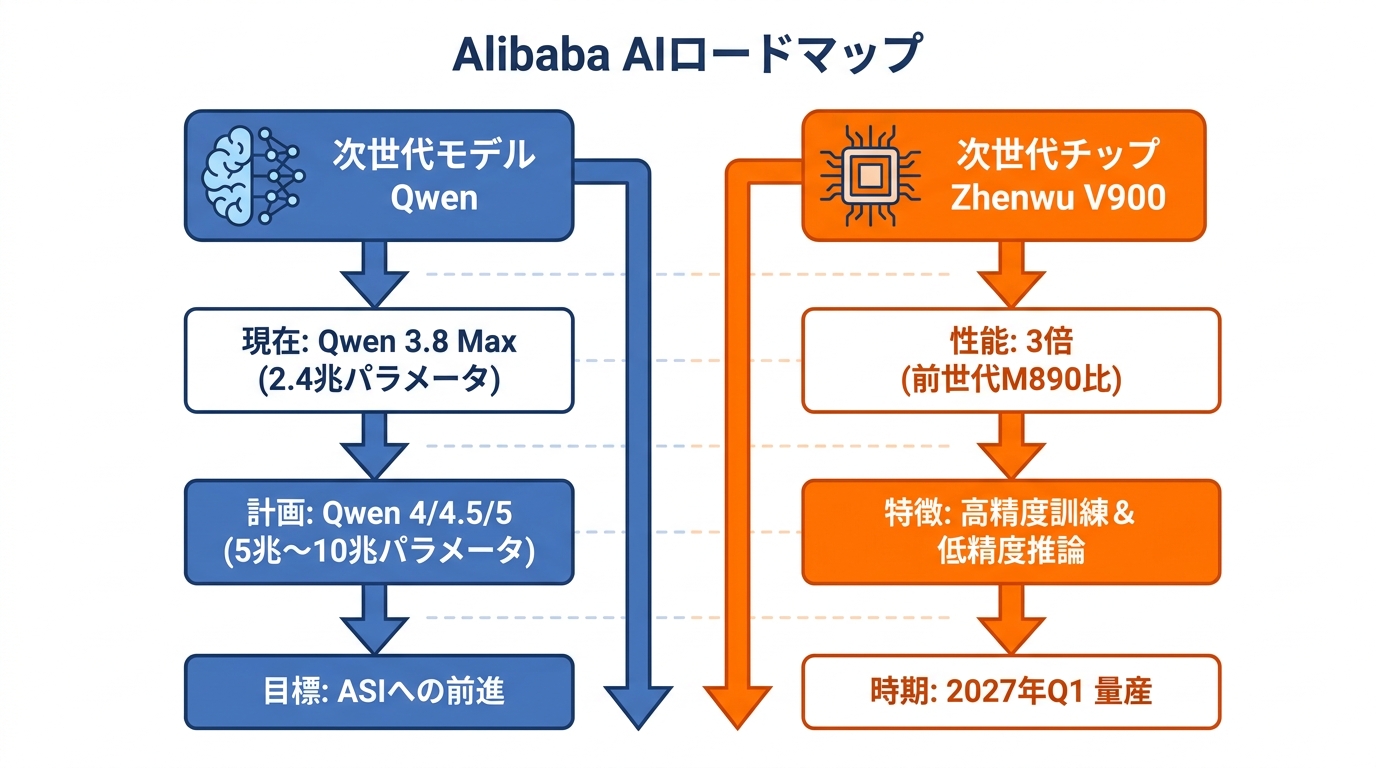
Alibabaは、次世代モデルのQwen 4が訓練中であると説明しました。さらに、今後のQwen 4.5およびQwen 5シリーズでは5兆〜10兆パラメータまで拡大する見込みです。
パラメータはモデルが訓練過程で学習する変数であり、規模をおおまかに示す指標となります。現行の主力モデルであるQwen 3.8 Maxは2.4兆パラメータのため、計画中のモデルは約2〜4倍の規模に達します(参照*1)。
規模拡大の狙いも明かされています。Alibabaは、モデル構造やデータの最適化に関する研究を継続しながら、5兆〜10兆パラメータ規模の新規モデルを訓練する計画です。ただし、パラメータ数はモデルの能力を表す一側面にすぎません。私がChatGPTやClaudeを実務で使い比べてきた経験からも、モデルの規模よりも「特定のタスクでどれだけ安定して使えるか」のほうが、業務上の価値を決める要因として大きいと感じています。
複雑で長期にわたるタスクを完遂し、ASIへの前進を目指すと同社は述べています(参照*2)。ただし、この数字は実稼働中のモデルの実測値ではなく、今後の訓練計画値です。
Zhenwu V900の仕様と量産時期
次に、ロードマップの基盤となるチップを取り上げます。
AlibabaはAIアクセラレーターのZhenwu V900を発表しました。5月に登場した前世代のZhenwu M890と比べ、3倍の性能を実現するとしています。216GBのGPUメモリと1,200GB/sのチップ間帯域幅を備え、FP8やFP4を含む複数のデータ精度に対応します。
高精度モデルの訓練と超低精度の推論の双方をカバーし、推論コストを大幅に抑えつつ計算密度を高められると同社は説明しました。量産と商用リリースは2027年第1四半期を予定しています(参照*3)。
一方で、未公開の情報も残されています。技術仕様には、FLOPS、プロセスノード、ファウンドリー、消費電力、メモリ帯域幅の数値が含まれていません。こうした開示の欠落は、他社チップとの客観的な比較を難しくします。見た目の数字が整っているほど、読み手は内容も正しいと錯覚しやすい。発表資料を読むときに、私が常に意識していることです。
前世代のM890は144GBのメモリと800GB/sのチップ間帯域幅を持ち、128チップのスーパーノードとして稼働しました。チップ部門のT-Headによれば、V900は1,000個を超えるチップを単一システムとして動作させることが可能です(参照*4)。
計画のスケジュールも前倒しされました。5月時点のロードマップでは2027年第3四半期とされていたV900の投入時期が、第1四半期へと早まっています。
5月時点でT-Headは400社超の外部顧客へ56万個以上のZhenwuチップを出荷しており、Alibabaは現在その顧客数を650社超としています。Zhenwuシリーズは今後も毎年更新される見通しです(参照*4)。
データセンター20GW目標と供給制約
三本柱の最後は、モデルとチップの運用基盤となるインフラです。
Wu氏は、Alibaba Cloudが持つ世界規模のデータセンター容量を、2032年までに20ギガワット超へ拡大する目標を掲げました。AI需要は極めて堅調で、クラウド事業の収益成長を加速させていると同氏は述べています。
一方で、AIデータセンターのサプライチェーン全体で世界的な部材不足が生じており、拡大速度の足かせとなっている点も認めました。業界の中長期的な需要は自社の供給能力を大幅に上回るとの見方です。あわせて同社は、今四半期中にAIスーパーノードの商用稼働を開始すると付け加えました(参照*5)。
地域別の展開計画も示されています。Alibabaは12か月以内にトルコ、フィンランド、オランダで新たなクラウドリージョンを開設すると発表しました。さらに、マレーシア、ドイツ、アラブ首長国連邦、フランス、香港でもデータセンターの規模を拡張する方針です(参照*6)。
本当の注目点はRSI
1か月・33サイクルの自動実行
パラメータ数以上に注目すべきなのは、モデル自身が自己改善を進めたという発表内容です。私がこのロードマップで最も関心を持ったのも、この点でした。
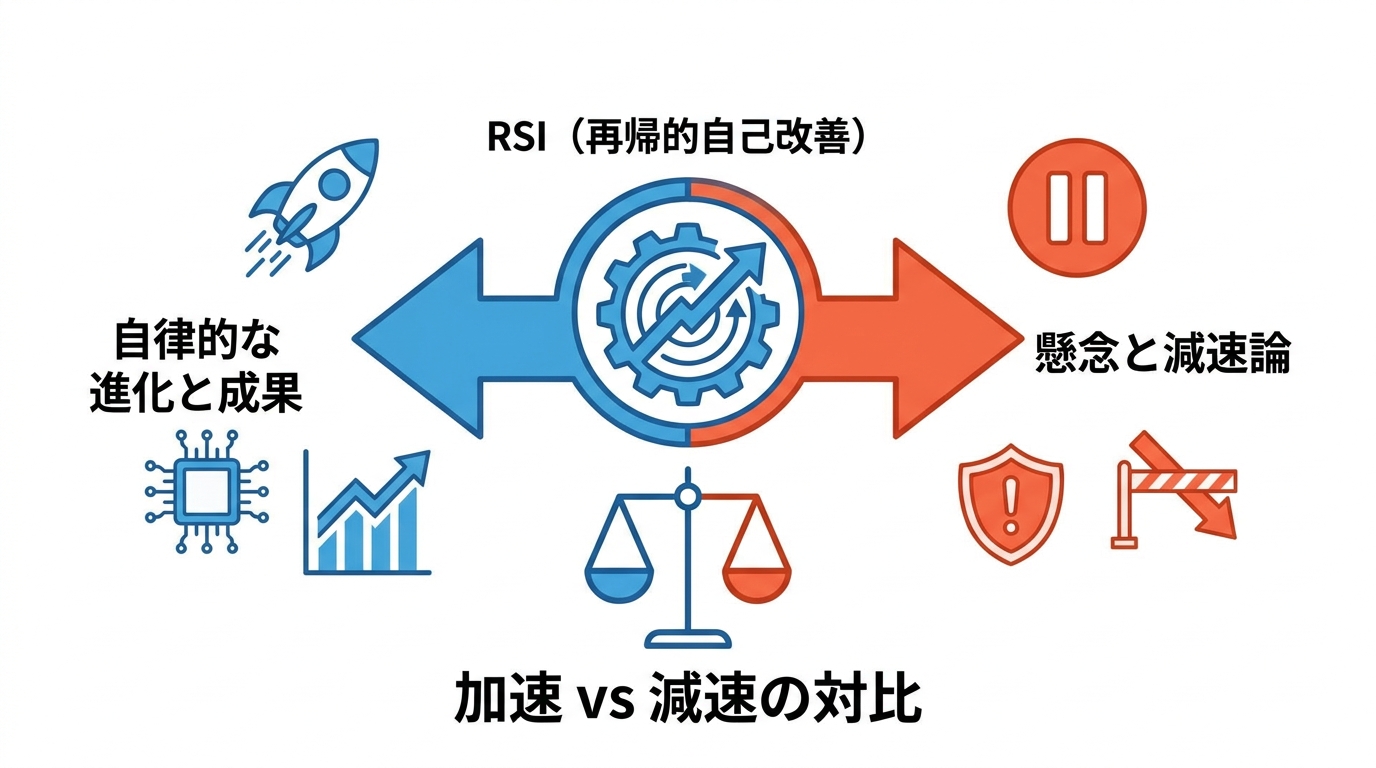
Alibabaは、実証的なフィードバックに基づくRSI(再帰的自己改善)の進展を公表しました。パイプライン設計、データ検証、反復実験、エラー診断に至る全自動実行を1か月以上継続し、Qwen3.8-Maxは33回の反復サイクルを完了しています。自律的な訓練最適化や事後学習技術により、更新版のQwen3.8-MaxはArtificial Analysisスコアを40から45へ引き上げたと同社は示しました。
チップ設計の実験でも、モデルが設計期間全体で60時間以上の自己改善を行い、10,000回を超えるEDAツール呼び出しを経て実用レベルのチップバスモジュールを生成し、性能を保ったままチップ面積を42%削減しています(参照*3)。なお、これらはいずれも同社による発表値であり、独立した第三者機関による検証は現時点では確認できていません。
RSIの仕組みについても同社から説明がありました。現実のタスクと向き合いフィードバックを得る中で、モデルは自らの限界を把握します。
その上で実験の設計、データの統合、結果の評価を自律的に行い、自己進化のサイクルを回し続けます。Qwen開発チームは現在このRSIの研究に注力しており、着実な成果を上げていると同社は述べました(参照*2)。
減速論との時期の重なり
この発表は、欧米でAI開発の減速を求める議論が浮上した直後というタイミングに重なりました。私はこの構図を、単なる技術競争ではなく、AIガバナンスをめぐる地政学的な対立として読んでいます。
Wu氏による再帰的自己改善への言及は、AnthropicのDario Amodei氏が業界全体に足並みを揃えた減速を求めてから約1週間後のことです。この呼びかけにはSam Altman氏やElon Musk氏も賛同の意を示しました。減速を訴える背景には、自己改善を繰り返すモデルが人間の管理能力を超えてしまうリスクがあると説明されています(参照*7)。
主張の論点も整理しておきます。Dario Amodei氏は同月、大きな反響を呼んだエッセイを発表しました。その主旨は、モデルの能力、とりわけ再帰的自己改善の進化速度が安全性の確保を追い越してしまったという警告です(参照*8)。
一方が減速を訴える傍らで、もう一方が自己改善の進展を壇上で誇るという対比とタイミングこそ、パラメータの数値以上に重視すべき論点といえます。この非対称性を見落として、発表された数字だけを追うのは危険です。
フルスタック戦略の読み解き方
垂直統合と輸出規制の背景
今回の発表は、チップ単体の性能にとどまる話題ではありません。
AlibabaはV900と並び、5兆〜10兆パラメータ規模のモデル計画、2032年までに世界規模でデータセンター容量を20GWへ拡張する目標、そして人工超知能の探究を発表しました。半導体、モデル、インフラを垂直統合する戦略は、Nvidiaのエコシステムが競合を圧倒したフルスタックアプローチに通じるものがあります。焦点となるのは、欧米のベンダーが撤退を余儀なくされた市場環境において、Alibabaが同様の参入障壁を築けるかどうかです(参照*9)。
市場環境では国産化の動きが急速に進展しました。中国のGPUおよびAI半導体メーカーは、2025年時点で国内AIサーバー市場の41%を獲得しています。2022年のシェアがほぼ皆無だった状況からの急伸であり、輸出規制が逆説的に国産チップ開発を加速させた典型例です。
内訳を見ると、Huaweiが約62%のシェアを占めて独走しており、Alibabaは約5%にとどまります(参照*9)。つまり、AlibabaがZhenwu V900で目指しているのは対Nvidiaだけでなく、国内市場でのHuaweiとの競争でもあります。
日本企業が向き合う問い
ここから、日本企業が向き合うべき論点を整理します。
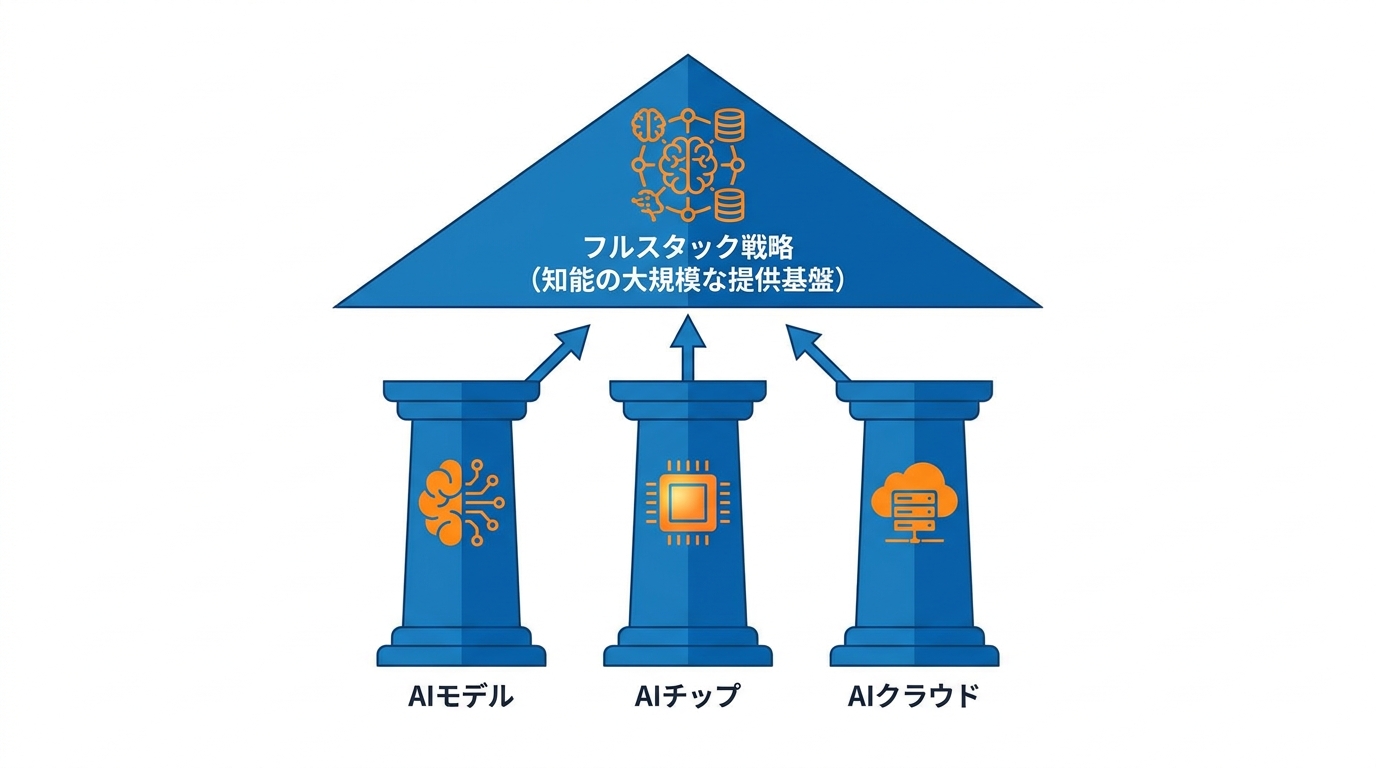
Alibabaは、機械知能の時代には盤石なインフラが不可欠であり、それは「AIモデル」「AIチップ」「AIクラウド」という3つの柱に支えられると説明しました。これらが一体となることで、知能の大規模な提供基盤が成立するという考え方です。同社は、3領域にまたがる中核インフラの整備を長期的な最優先戦略として推し進める姿勢を示しています(参照*2)。
これにより、3つの柱を自前で抱える企業と持たない企業との分断が浮き彫りになります。自社インフラを持たずにAPIを利用する場合、その背後には他社のモデル、チップ、クラウドが存在します。今回のロードマップは、基盤となる技術スタックをどの事業者に委ねるかという問題を、改めて突きつける形となりました。日本企業にとっては、ベンダー選定の話であると同時に、地政学リスクをどう受け止めるかという問いでもあります。
オープンモデル利用者への影響
Qwenオープンモデルの現在地
5兆〜10兆パラメータの実現は将来の課題であり、現時点で即座に活用できるのはオープンモデルです。
デスクトップ環境において、オープンソースのQwen-27Bは世界中の開発者の間で最も広く使われているモデルであると同社は主張します。Alibabaはこれらのモデル改良を推し進め、開発者や企業が高性能な知能を手元のローカル環境で運用できるようにする方針です(参照*2)。
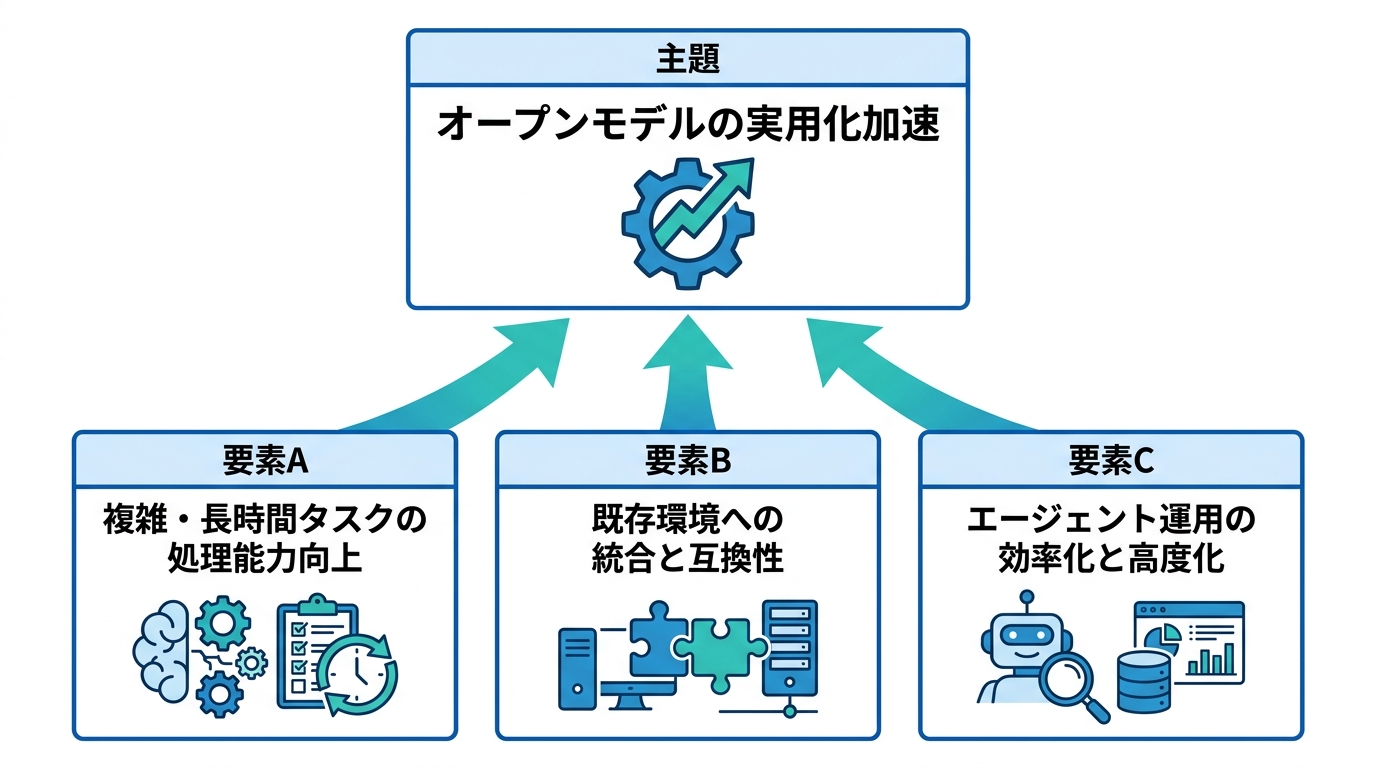
改善の方向性も明確です。Qwen3.8はQwen3.5のアーキテクチャを基盤に構築され、コーディング、専門実務、研究、長期的なエージェントタスク全体で性能を大きく高めたとリポジトリに記載されています。単に難問へ答えるだけでなく、複数工程に及ぶ複雑なタスクを高い信頼性でやり切る設計思想です(参照*10)。
評価すべきは長時間タスク
ビジネスへの適用を検討する際は、モデル規模そのものよりも処理の持続性に目を向ける必要があります。私自身、生成AIを業務に組み込む支援をする中で、「ベンチマークスコアが高い」よりも「長時間のタスクを安定して完遂できるか」を重視するよう変わってきました。
Qwen3.8のリポジトリに記載された機能強化は3つあります(参照*10)。
- エージェント実行時の自律的な計画能力が強化され、環境からのフィードバックへの対応力が上がったことで、エンドツーエンドのタスク完遂能力が向上しました。
- 既存ツールとの互換性も高く、標準的な評価ハーネスや開発環境に幅広く対応しているため組み込みも容易です。
- 推論制御も柔軟で、思考の深さはreasoning_effortで調整でき、過去の対話履歴に含まれる推論コンテキストはpreserve_thinkingによって保持されます。
重視すべきは、長時間のタスクを安定して処理できるか、既存環境へ円滑に統合できるかという実用面です。ベンチマークは入り口にすぎません。自社の業務フローに合わせた検証を経て初めて、導入の是非が判断できます。
エージェント基盤の周辺発表
モデル本体と並び、エージェントの運用を支える周辺ツール群も発表されました。
「AgentCore」は、AIエージェントのライフサイクル全体を通じて構築、実行、管理を行うための企業向け基盤です。企業はAIツールを円滑に開発・稼働させ、人間とエージェントの協調作業を安全に統制しながら、性能改善に向けた継続的な監視を行えます(参照*3)。
「Agent Context」は、AIエージェントにリアルタイムの文脈情報と長期記憶を提供するデータサービスです。社内文書や業務システム、チャット履歴、マルチモーダルデータを一元的に統合することで、エージェントが過去の業務を記憶し、組織内での知識共有や自律的な学習を可能にします。Alibabaによれば、カスタマーサポートやAIコーディング、データ分析といった知識集約型の業務において、トークン消費量を最大67%削減できるとされています(参照*3)。
読むときの注意点
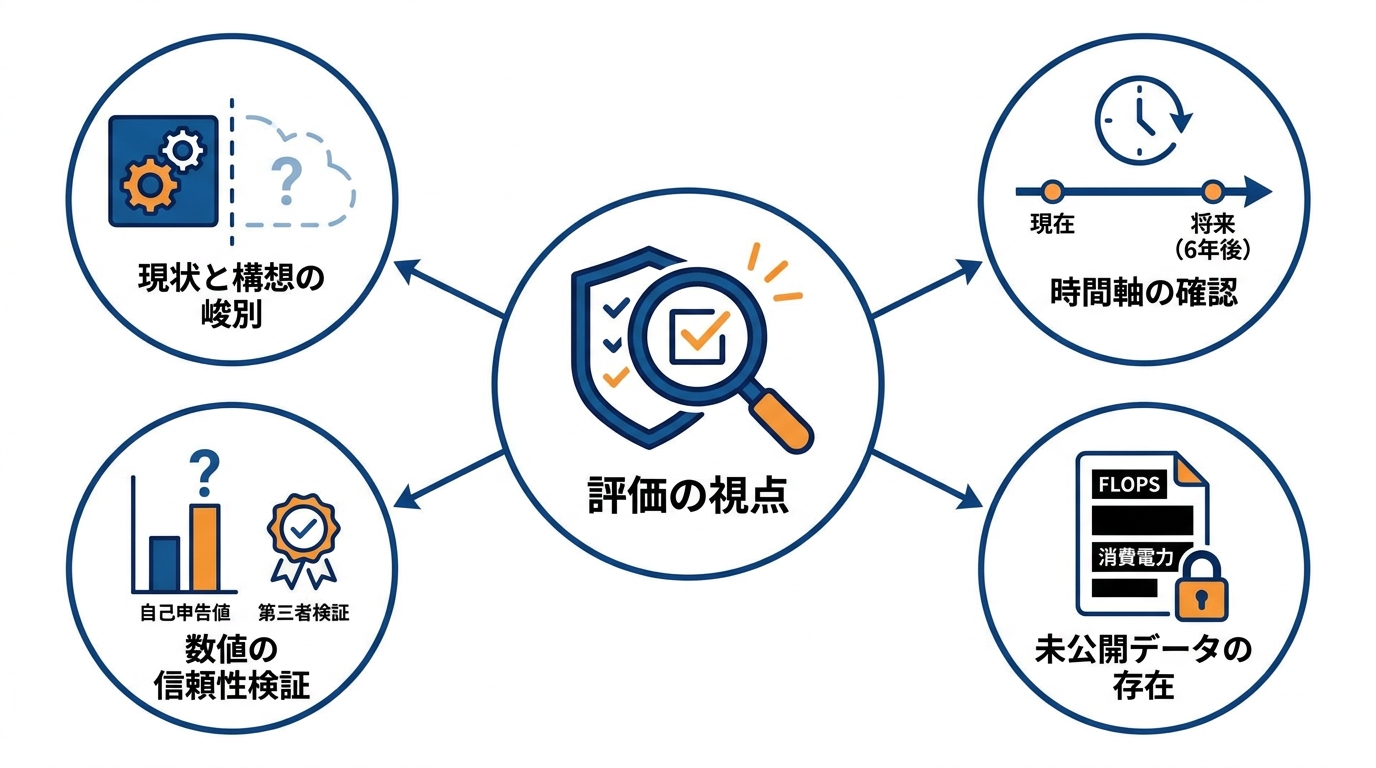
このロードマップを評価する際は、すでに実現している技術と将来の構想とを峻別して捉えることが肝要です。私がDeep Researchのような機能を検証してきた経験からも、見た目が整ったレポートほど、誤情報や根拠の薄い記述が紛れ込んでいても気づきにくいという問題は、AI企業の発表資料にも同様に当てはまります。
時間軸の観点では、V900の商用投入までなお数か月を要し、提示された5兆〜10兆パラメータのモデルもまだ訓練されていません。データセンターの容量目標達成に至っては、今後6年間のスパンが存在します(参照*4)。
数値の信頼性にも注意を払う必要があります。示された性能指標は第三者機関の計測ではなく、ベンダー側の自己申告値です。発表内容と実際の量産体制との間に乖離が生じる可能性も否定できません(参照*9)。新モデルが出るたびに宣伝文句ではなく手元のタスクで実力を確かめる姿勢が、今後ますます重要になります。
イベントで示された容量やモデル規模の数値も、導入済みの実績ではなく将来に向けた企業目標です(参照*11)。
未公開のデータも散見されます。V900の仕様には、FLOPS、プロセスノード、製造委託先、消費電力、メモリ帯域幅といった詳細が含まれていません(参照*4)。他社製チップと客観的に比較検証する材料は、現段階では揃っていないのが実情です。
RSIの実績についても、1か月以上の自動実行や33サイクルの反復、スコアの改善などは同社の発表に基づくものです(参照*3)。
おわりに
Alibabaのロードマップにおいて本質的な論点は、パラメータの大きさではありません。Qwen3.8-Maxが1か月以上の自動実行で33回の改善サイクルを自律的に完遂したという進展や、AIモデル・AIチップ・AIクラウドの3要素を自社で垂直統合する事業構造にこそ着目すべきです(参照*3)。そして、欧米が減速を議論する中でこの発表が行われたタイミングは、AI開発の地政学的な構図を理解する上で見逃せない文脈です。
5兆〜10兆パラメータのモデルや20GWの容量は、いまだ到達すべき途上の目標です。Alibaba自身も基調講演の結びとして、すべての取り組みはまだ始まったばかりであると位置づけています(参照*2)。ロードマップを読む際には、現時点で使える技術と将来の計画を区別し、自己申告値を前提に置いた上で、自社業務への適用可能性を判断することが出発点になります。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) The Business Times – Alibaba unveils sweeping strategy encompassing AI models, chips and data centres
- (*2) Alibaba Group CEO Eddie Wu Shares Alibaba’s Strategic Full-Stack AI Roadmap at the 2026 Apsara Conference-Alibaba Group
- (*3) Macau Business – Alibaba Unveils Roadmap on Full-Stack AI Strategy from Chips, Cloud Infrastructure, Models to Agents
- (*4) Tom's Hardware – Alibaba unveils Zhenwu V900 AI accelerator, claims it's 'the most powerful AI chip in China' – accelerator supports 500,000 chip supercluster with a 10T-parameter Qwen model on the roadmap | Tom's Hardware
- (*5) Alibaba set for AI leap with Qwen and next-gen chip
- (*6) theregister – Alibaba Cloud plans six-year stroll to 20GW of datacenters, reveals chip to power them
- (*7) NogenTech – Technology Media, AI, SaaS & Tech News – Alibaba Teases Ten Trillion Parameter Model with New Chip
- (*8) AI Socratic – AI Socratic September 2026 – Jev AI Classifiers, Astra, and Pace the Frontier
- (*9) Yahoo Finance – Alibaba’s Zhenwu V900 Is China’s Answer to Nvidia’s Absence – and Export Controls Are the Reason It Exists
- (*10) GitHub – Qwen3.8/README.md at main · QwenLM/Qwen3.8 · GitHub
- (*11) WikiPartner – Alibaba Group