この記事のまとめ
Microsoft-Decision-1は、文章を生成する代わりに、事前に定義した選択肢ごとの確率を返すAIモデルです。状況や質問、回答候補を入力すると、1回の処理でJSON形式の判断結果が出力されます。ここでは仕組み、料金、活用場面、注意点の4つのポイントを整理して解説します。
- MicrosoftがQwen3.5-9Bを追加学習して構築したモデルで、Microsoft FoundryとOpenRouterで提供が開始されました。
- 入出力はテキストのみで、コンテキスト長は32,768トークンです。質問形式にはnoul、choice、scoreの3種類が用意されています。
- 分類や振り分け、優先順位付け、AI出力の評価などが想定用途であり、文章生成や会話、翻訳、要約には対応していません。
- 公表された精度や速度の数値はMicrosoftによる独自測定であり、第三者の計測結果とは乖離があるため、自社データでの検証が推奨されています。
Microsoft-Decision-1の基本情報
発表と提供形態
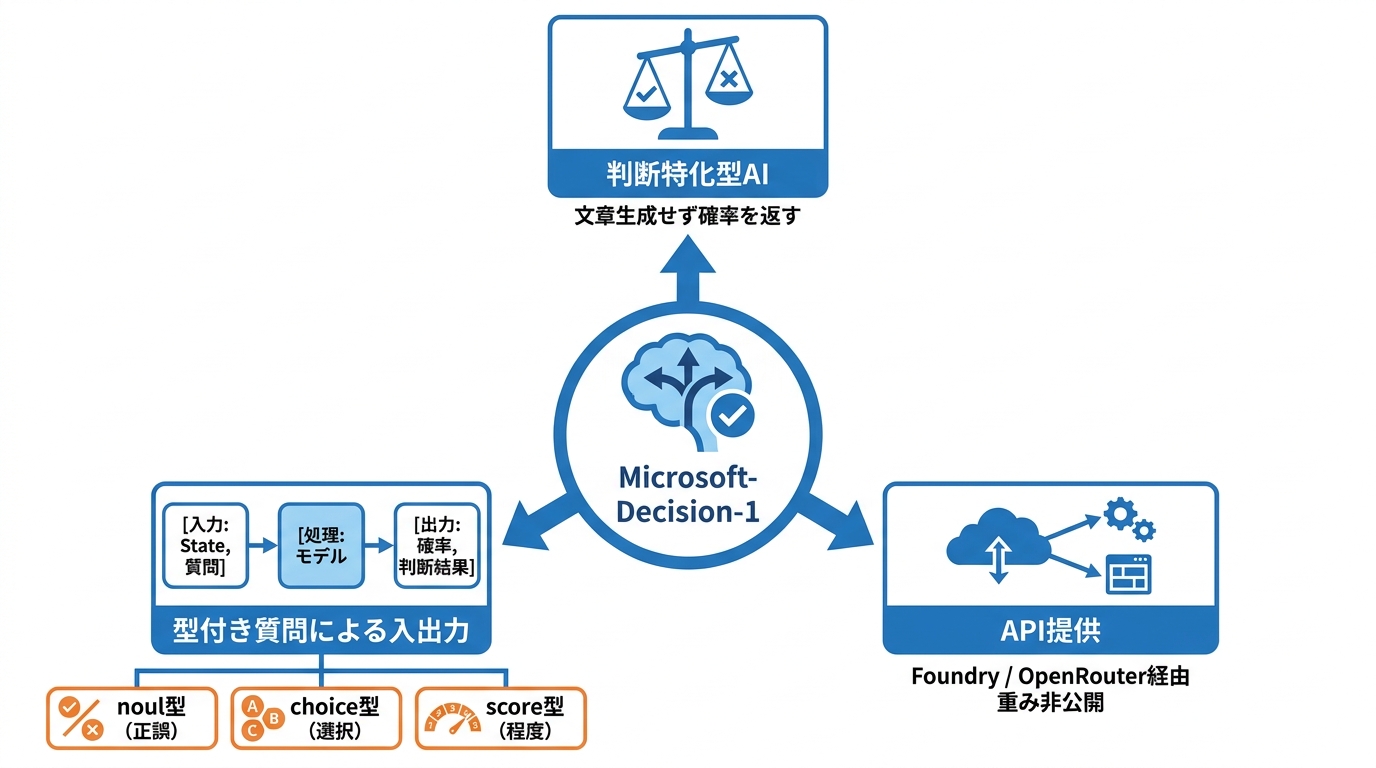
米Microsoftは10月9日(現地時間)、テキストを生成する代わりに、あらかじめ提示した選択肢ごとの確率を返す判断特化型AIモデル「Microsoft-Decision-1」を発表しました。開発者向けには、AI開発基盤であるMicrosoft Foundryと、複数のAIモデルをAPI経由で利用できるOpenRouterを通じて提供が開始されています。
利用料金は入力100万トークンあたり0.042ドルで、出力は無料です。ベースモデルには中国Alibaba Groupのオープンウェイトモデル「Qwen3.5-9B」を採用し、Microsoftが追加学習を施しています(参照*1)。
私がこのモデルを注目した理由は、料金体系にあります。入力100万トークンあたり0.042ドル、出力は無料という設定は、分類や振り分けを大量に処理するシステムにとって非常に現実的な単価です。生成AIのコスト設計は、プロトタイプ段階では見えにくく、本番稼働に入ってから「想定より出力トークンがかさんだ」というケースをコンサルティングの現場でも何度か見てきました。そういう意味で、出力無料という割り切りは、使い方が明確な業務には刺さる設計だと思います。
公開日の記載は資料によって異なり、MicrosoftのOffice of the CTOでソフトウェアエンジニアリング担当VPを務めるAchint Srivastavaが2026年10月9日に発表した一方、Foundryのモデルカードに記載されたリリース日は10月8日です。モデルの重み自体は配布されていません。セルフホストはできません(参照*2)。
入出力と仕様
Microsoft-Decision-1は、state値と1つ以上の型付き質問を受け取ります。stateにはテキスト形式のほかJSON形式も指定可能で、アプリケーションが必要とする判断内容に合わせて質問の型を選択します。
アプリ側がstateと限定された質問を渡すことで、モデルは文章を生成せず判断結果のみを出力します。質問の型は3種類です(参照*3)。
- 「正しいかどうか」を問う質問にはnoul型を用い、0から1の確率が返されます。
- 「どの選択肢か」を問う形式にはchoice型を用い、選定された選択肢と各選択肢の確率が取得できます。
- 「どの程度か」を問う形式にはscore型を用い、順序尺度上の値と各段階の確率が返ってきます。
入力可能なデータ量と形式にも仕様が定められています。コンテキストや状態、質問、定義済みの選択肢を渡すと、モデルは各選択肢に対する調整済みの確率を返し、説明文などのテキストは出力しません。
入力はテキスト形式のみに対応し、最大長は32,768トークンです。なお2026年10月12日時点で、Microsoftはレート制限、選択肢数の上限、質問数の上限、scoreの最大レベル数を公表していません(参照*2)。
文章を書かないAIが判断を担う理由
生成型LLMとの役割の違い
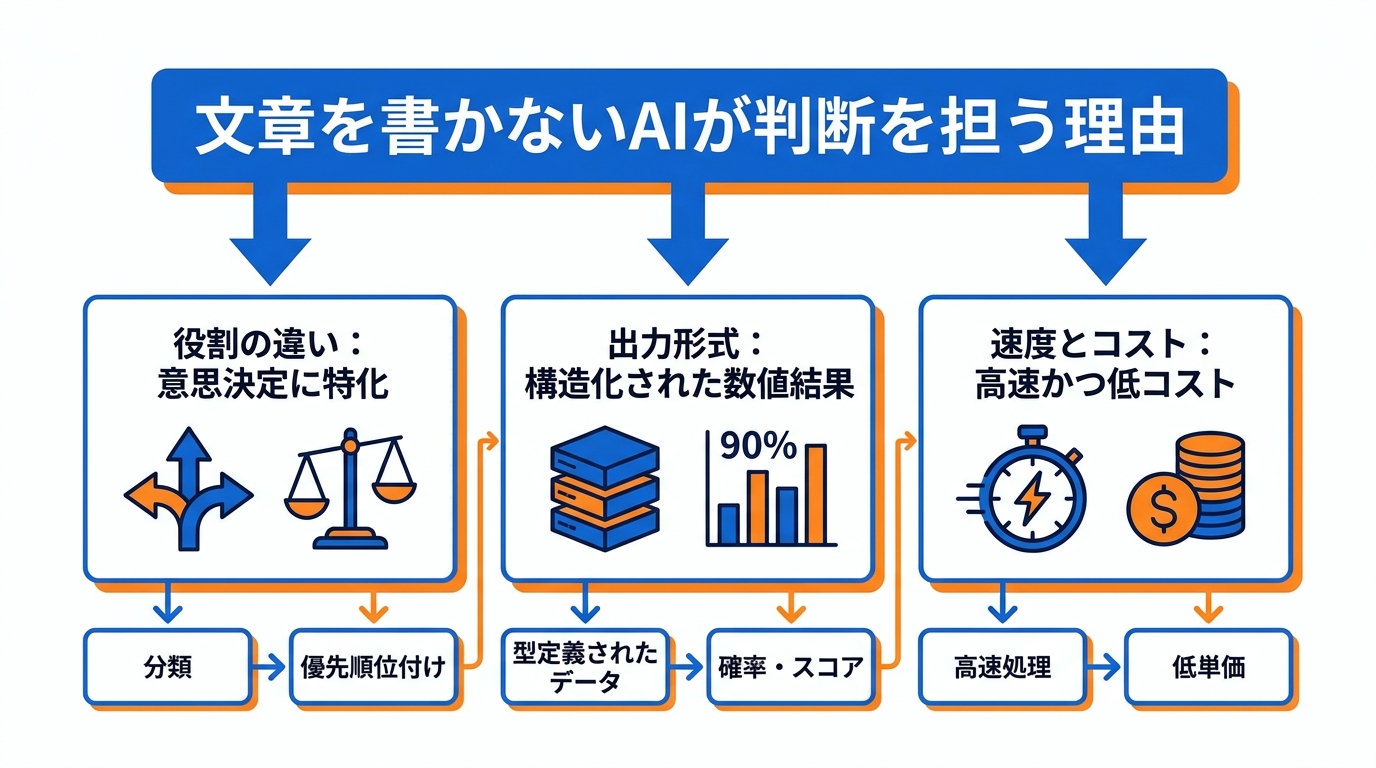
文章をあえて生成しない設計を採用した背景には、処理工程全体の見直しがあります。これは単なる機能の絞り込みではなく、AIをシステムの中のどこに置くか、という問いへの一つの答えだと私は受け止めています。
AIアプリケーションにおけるすべての工程で、大規模言語モデルによるテキスト生成が必須なわけではありません。頻繁に呼び出される処理の多くは、入力の分類、選択肢の絞り込み、スコアの付与、条件の検証、項目の優先順位付け、ワークフローの分岐制御といった「意思決定」に分類されます。こうしたタスクを高速かつ構造化されたリクエストで処理するために、新たなアプローチのモデルが開発されました(参照*4)。
出力形式の明確な差異も特徴の一つです。一般的な生成型LLMとは異なり、Microsoft-Decision-1は自由文の回答や論理的根拠となる文章を作成しません。この「説明しない」という割り切りが、速度とコストの両面で効いてきます。
テキストやJSONの入力に対して焦点を絞った判定を行い、型定義された数値結果を出力します。定型化された応答や、しきい値判定・順位付けに直結する確率値を求めるアプリケーションに適した設計です(参照*3)。
確率とキャリブレーションの役割
出力される確率は単なるスコアではなく、APIの基盤機能として設計されています。
アプリケーションは、処理をそのまま実行するか、保留にするか、あるいは人間の確認フローに回すかを決める判断材料として信頼度を活用します。そのため代表的な指標では、90%と予測されたケースは10回中およそ9回正解となる較正精度が求められます(参照*5)。
ただし、確率が高いことの意味合いには明確な限界も存在します。確率値は提示された質問と評価基準に基づくモデルの予測に過ぎず、確率の高さがユーザーの主張の正しさを客観的に証明するわけではありません。削除された設定ページに関するユーザー報告をモデルが正しく認識できたとしても、ドキュメント担当チームは実際の製品仕様を自ら検証する必要がある、という事例が挙げられています(参照*6)。
速度とコストが変える使い方
判断の処理速度と料金設定は、システム内に組み込める意思決定の頻度に直結します。この点は、生成AIを業務フローに組み込む際に見落とされがちな論点です。
判定ステップを1つ追加するごとにレイテンシーが加算され、先行処理に依存するシーケンスではその影響が顕著になります。たとえば20回連続する判定処理にそれぞれ100ミリ秒要した場合、パイプライン全体で2秒の遅延が生じる計算です。Microsoftによれば、Microsoft-Decision-1のP50レイテンシーはGPT-6 Solと比較して約35倍高速とされています(参照*5)。
コスト構造もシステム設計に大きく影響を与えます。Microsoftは入力100万トークンあたり0.042ドルという単価を設定し、出力トークンを無料としました。
短いリクエストを頻繁に処理するシステムにおいて、直接的な推論コストを大幅に抑制できる体系です。運用費用は実質的に、モデルへ投入する入力コンテキストの分量によって決まります(参照*7)。
一方で、「安い・速い」という数値は、あくまでMicrosoftの公表値であることを忘れてはいけません。後述しますが、第三者による計測ではレイテンシーに大きな乖離が確認されています。コスト試算をするなら、まず自社環境での実測値を取ることが先です。
想定される用途と対象外の用途
分類・ルーティングなどの想定用途
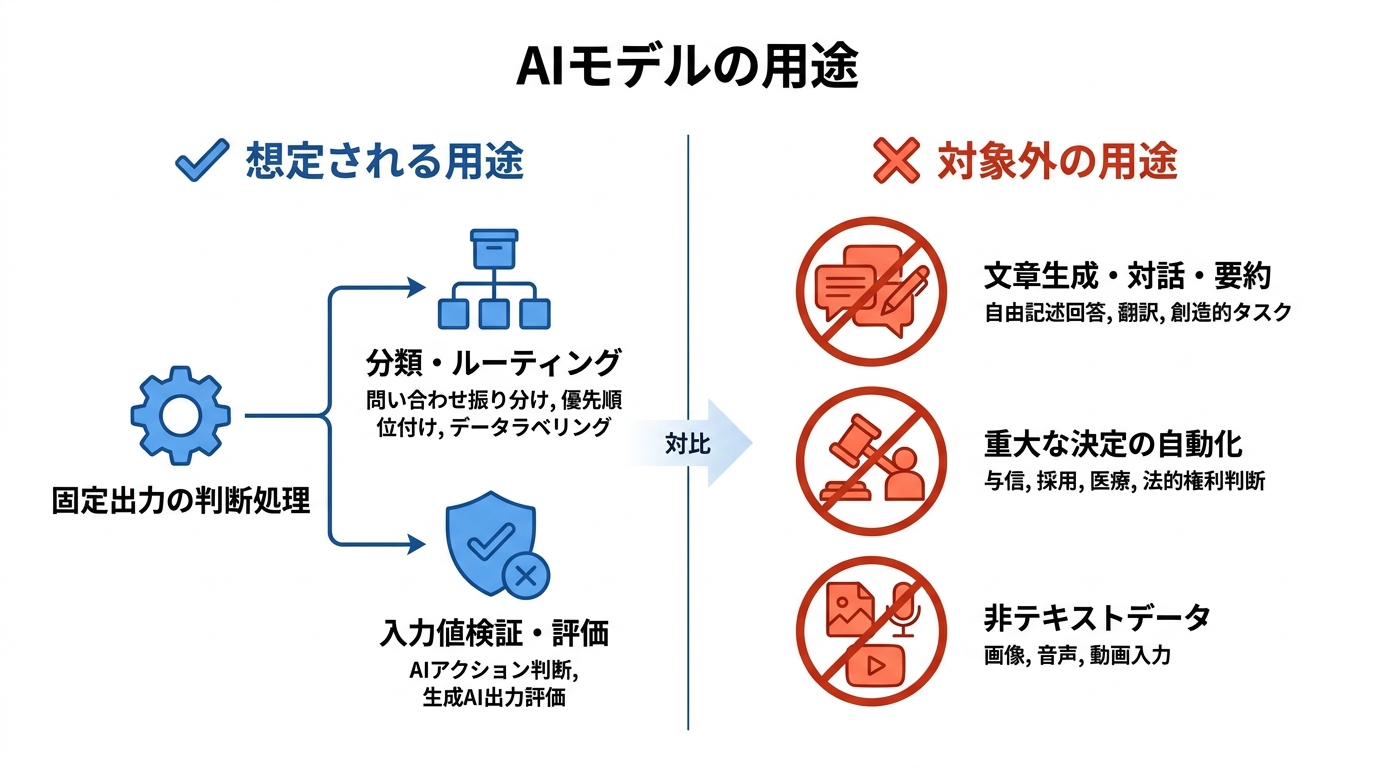
本モデルが適しているのは、出力形式があらかじめ決定されている判断処理です。
具体的な想定用途として、問い合わせの分類や振り分け、優先順位付け、入力値の検証、AIエージェントの次のアクションの可否判断、生成AIの出力評価、データのラベリングなどが挙げられます(参照*1)。固定された選択肢から単一のラベルを選ぶ処理にはchoice型の質問を用います。
サポートチケットのルーティング、問い合わせ意図や文書形式の分類、利用モデルやツールの選択、要因別のアラート仕分けなどが代表例です(参照*3)。
マイクロソフト社内における導入実績も示されています。XBOX Researchは、アンケートやSTEAM、Twitter/Xから収集した1万件以上の自由記述フィードバックをMicrosoft-Decision-1で解析しました。
事前に定義したテーマリストへ分類することで、各種タイトルやリリース、配信に関するユーザーの声を整理しています。その結果、GPT-6 Solと同水準の品質を維持しながら、14倍以上の処理速度を達成し、コストは200分の1だったと報告されています(参照*5)。
この事例は、使い方の典型を示しています。1万件を超える非構造化テキストを人手で読み分類するのは現実的ではなく、かといって汎用LLMで処理すると速度もコストも課題になります。出力形式が確率値と分類ラベルで完結するなら、それ専用のモデルを使う判断は合理的です。ただ、「GPT-6 Solと同水準の品質」「14倍の速度」「コストは200分の1」という数字は、すべてMicrosoft社内での比較であることを踏まえて読む必要があります。
対象外とされる用途
一方で、適用が推奨されない業務領域についても明確に規定されています。
モデルカードによると、文章生成や自由記述形式の質問応答、対話、翻訳、要約を想定した設計にはなっていません。選択肢が事前に定義されていないタスクや、入力データ外の知識を前提とする処理も対象外です。
さらに、人間に影響を及ぼす重要事項の決定プロセスにおいて、唯一の自動判断システムとして運用することは想定されていません。与信、採用、住宅、保険、教育、医療、法的権利など、重大な影響を伴う判断の根拠として単独で採用してはならない旨が明記されています(参照*8)。
対応可能なデータ形式や言語環境にも留意が必要です。テキスト生成や対話、要約といった開かれたタスクに非対応であるほか、画像、音声、動画データの入力は受け付けていません。Microsoftの発表によれば、主に英語データへ最適化されているため、他言語環境や医療、法務、金融といった専門性の高い領域では十分な精度が出ない可能性があります(参照*2)。
公表された性能値と読み方
精度とキャリブレーションの数値
発表されたベンチマーク指標は、測定主体と評価環境を十分に把握した上で解釈する必要があります。私がAIモデルを評価するときに常に意識するのは、「誰が、何と比べて、どの条件で測ったか」という三点です。この観点でMicrosoft-Decision-1の数値を見ると、慎重に読むべき点がいくつか出てきます。
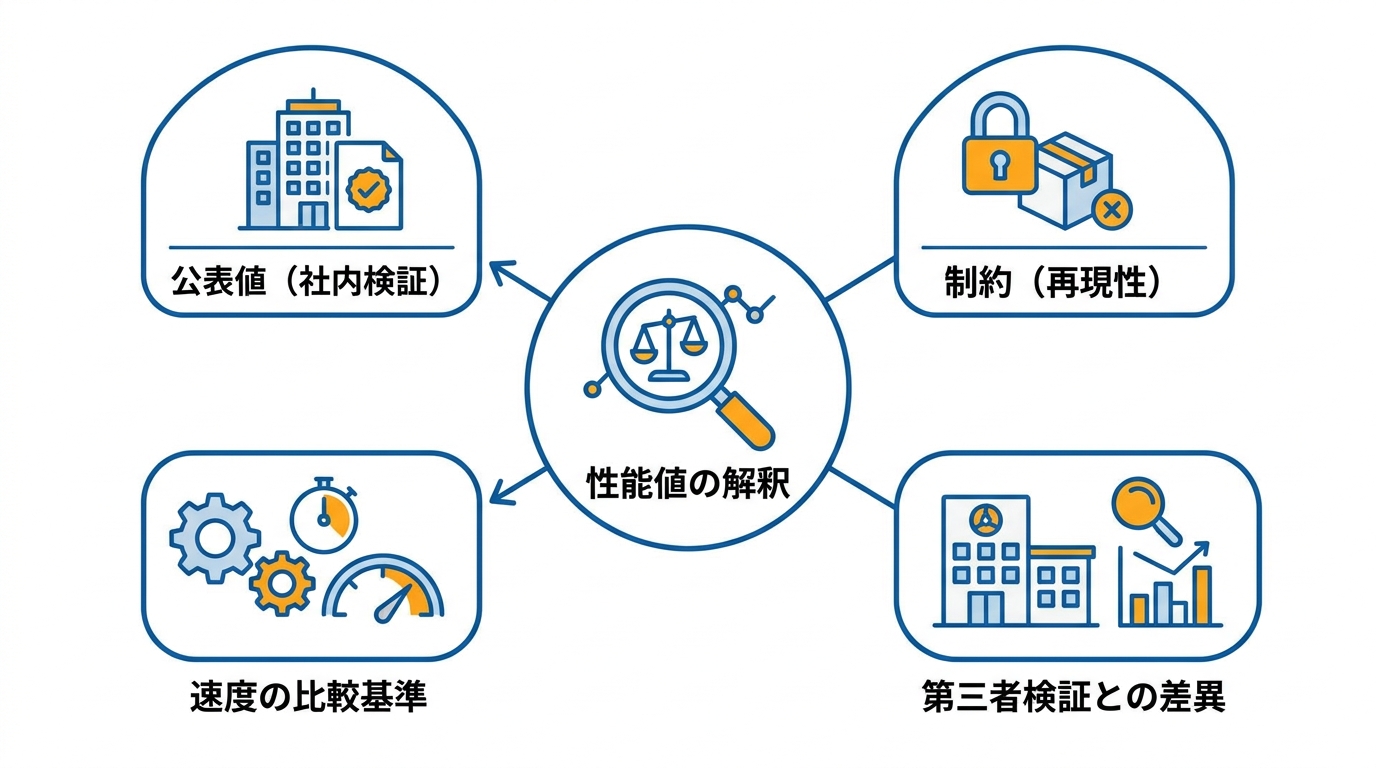
公表されている精度およびキャリブレーションスコアは、Microsoft自身が実施した社内検証の結果です。36種類の公開・非公開ベンチマークと147,137件の質問を用いた評価において、平均精度は83.5%を記録しました。
比較対象モデルでは、Jev 1.13.0が82.3%、Quyet-1.0-Largeが81.9%、GPT-6 Luna Decisionsが79.4%、H2O-Lightning-4Bが77.2%となっています。また、キャリブレーションスコアは100点満点中92.2点で、7モデル中3位でした(Jevは93.7点、Quyetは93.1点)(参照*2)。
ただし、これらの数値には第三者による再現性が担保されていない制約があります。評価に用いられた36件のベンチマーク詳細は非公開とされ、学習データへの混入を防ぐため機密扱いとされているため、同一条件下での再検証は困難です。自社での検証なしに、このスコアを導入の根拠にするのは早計です(参照*2)。
速度の主張と独立測定の差
公表された処理速度のデータも、比較基準と計測条件によって受け止め方が異なります。
大きく取り上げられている「約35倍高速」という表記は、汎用生成モデルであるGPT-6 Solを基準にした数値です。同一系統の意思決定特化型モデルであるGPT-6 Luna Decisionsと比較した場合、公表値ベースでの差は約3.5倍にとどまります(参照*9)。
第三者機関による検証データもあります。2026年10月10日以降、Benchmark HeavenのJevBenchホステッドAPIランキング(v1.7.31)にデータが登録されています。Azure Foundry経由のネイティブ環境において、非公開データ1,200件と公開データ300件を用いて計測されました。
その結果、JevBenchのCapability Scoreは70.78、Calibrationは84.40でした。また、レイテンシーの中央値は459ミリ秒であり、Microsoftが公表した85ミリ秒とは約5倍以上の開きがあります(参照*2)。
この乖離は、測定環境の違い(ネットワーク条件、リージョン、負荷状況など)が原因として考えられますが、詳細は公表されていません。「35倍高速」という見出しを信じてシステム設計をすると、本番環境で想定外のレイテンシーに直面するリスクがあります。新モデルが出るたびに公式発表だけを見て判断するのではなく、自分の手元で試す習慣が重要だと、私は繰り返し実感してきました。
プロンプトの表記ゆれに対するロバストネスも検証されています。同一リクエストに8パターンの改変を加えて判定の安定性を評価したところ、Microsoft-Decision-1で判定に変化が生じた割合は平均1.3%でした。選択肢の言い回しを変更した場合や、選択肢の配置順序を逆順・ランダムに変更した検証では、判定結果に変化は見られませんでした(参照*5)。
導入前に確認したい注意点
自前データでの検証としきい値
本格導入に向けたアプローチとして、実データを用いた検証としきい値設計の重要性が指摘されています。これはMicrosoftの推奨というだけでなく、生成AI導入全般に共通する鉄則だと私は考えています。
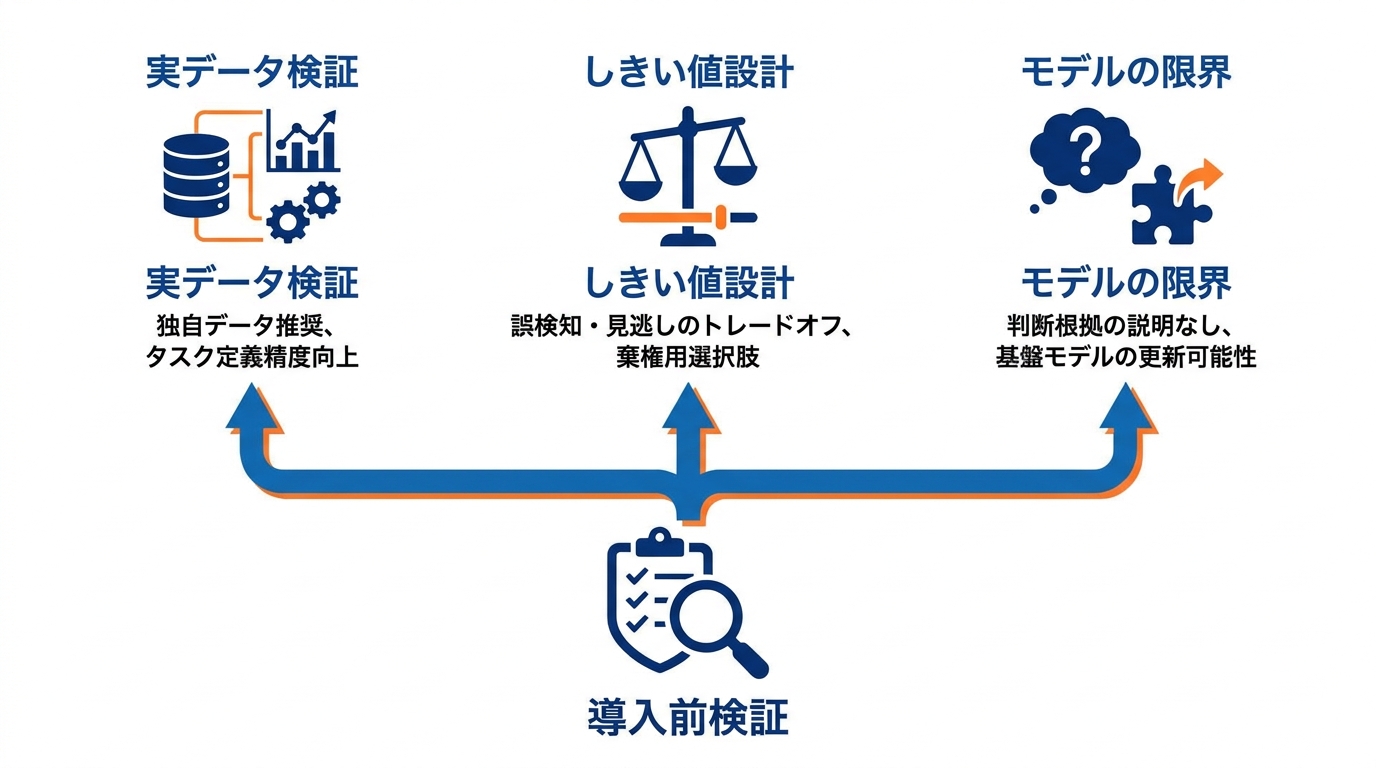
Microsoftが推奨する検証と設定の要点は4つあります(参照*3)。
- 実際の業務ケースを反映した独自データによる検証が強く推奨されています。
- stateやinstructions、選択肢の各パラメーターを調整し、構造化データやコードを含んだstateを活用することで、タスク定義の精度を高めることが可能です。
- 信頼度のしきい値は誤検知と見逃しのトレードオフを考慮して設定し、確証が得られない場合に備えて「判断不能」といった棄権用の選択肢を用意することも有効です。
- 質問や選択肢は明瞭かつ中立的な表現を保ち、選択肢の順序シャッフルによる結果の変動がないかテストすることが推奨されます。
モデル評価時に着目すべき観点も示されています。期待される結果が明確なタスクにおいては、本番を想定した入力を用いて品質、レイテンシー、コストの要件を比較します。
境界線上の事例を含む判定精度、想定トラフィック下での応答速度、判定1回ごとのコストが検討基準となります。信頼度スコアを自動処理や有人エスカレーションの分岐に用いる際は、必ず自社データを用いて較正精度を検証することが求められます(参照*4)。
説明がないことと今後の変更
判断根拠となる解説文が出力されない点や、将来的に基盤モデルが更新される可能性については事前の把握が必要です。「なぜこの判定になったのか」を問われたとき、確率値しか返ってこない設計は、説明責任が求められる業務では使いにくい場面があります。
出力の信頼性について、一般的なタスク形式では高い較正精度を発揮するものの、モデル自体は判断理由の説明を出力せず、学習データの鮮度に依存する場合があります。コンテンツモデレーションへの活用においては、境界線上の有害コンテンツを見落としたり、無害な表現を誤検知したりするリスクが示唆されています(参照*3)。
また、現在のベースモデルが恒久的なものではない点にも注意が必要です。現在はコンテキスト長32,768トークンのテキスト特化構成ですが、将来的にはMicrosoft AIや米OpenAIのモデルを基盤とした構成への刷新も予告されています(参照*1)。ただし、この更新計画について具体的な実装スケジュールは明かされていません。
おわりに
Microsoft-Decision-1は、テキストを生成せずに選択肢ごとの確率のみを出力するという、従来のLLMとは一線を画すアプローチのモデルです。分類やルーティング、優先順位付けのように目的が定義されているタスクにおいて、判断特化型の選択肢となります。私自身、生成AIをシステムに組み込む相談を受けるとき、「すべての処理に汎用LLMを使う必要はない」という話をよくします。その文脈で言えば、このモデルの存在意義はわかりやすいと思います。
もっとも、公表されている性能指標の多くはMicrosoft独自の検証値であり、JevBenchなどの第三者による測定値とはレイテンシー面で大きな差異も見られます。「速い・安い」という印象だけで導入を決めず、自社の実用環境を反映したデータで精度や較正状況を確かめることが、結局は最短経路だと思います。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) ITmedia AI+ – Microsoftも“判断特化”AIモデル「Microsoft-Decision-1」、Qwenベースで「Jev」と同価格
- (*2) System One Models – decision model specs and pricing
- (*3) Docs – Deploy and use Microsoft-Decision-1 in Microsoft Foundry
- (*4) TECHCOMMUNITY.MICROSOFT.COM – Introducing Microsoft-Decision-1 in Microsoft Foundry for decision and classification workloads
- (*5) Command Line – Our model for fast decision-making
- (*6) Vercel – What is Microsoft Decision-1?
- (*7) Data Studios ‧Exafin – Microsoft Decision-1: 35× faster AI agent decisions
- (*8) Microsoft Foundry – Microsoft-Decision-1 | Model Catalog | Microsoft Foundry
- (*9) The Inference – Microsoft's $0.042 decision model runs on Alibaba's free Qwen, and Redmond plans to replace it