この記事のまとめ
llms.txtを自社サイトに設置し、生成AI機能でのインプレッション、AIでの言及状況、クローラーのアクセスログという3つの指標を導入前後で見比べる検証のやり方をまとめます。効果を約束する記事ではなく、条件を決めて記録し、言える範囲だけを書くための進め方を示します。読むときのポイントは次の3つです。
- 検証では期間を区切り、同時期の他の変更を抑え、測定方法を記録します。前後比較は変化を示すだけで、理由までは分かりません。
- 設置するファイルは、サイト名の見出しと概要、リンク一覧という形で組み立てます。置く場所によって対象になる範囲が変わります。
- Google検索は生成AI機能を含めてllms.txtを使わないと説明しており、作っても可視性や順位に悪影響も好影響もありません。手間とリスクを踏まえて判断することになります。
検証の設計と測定方法
検証期間と条件の固定
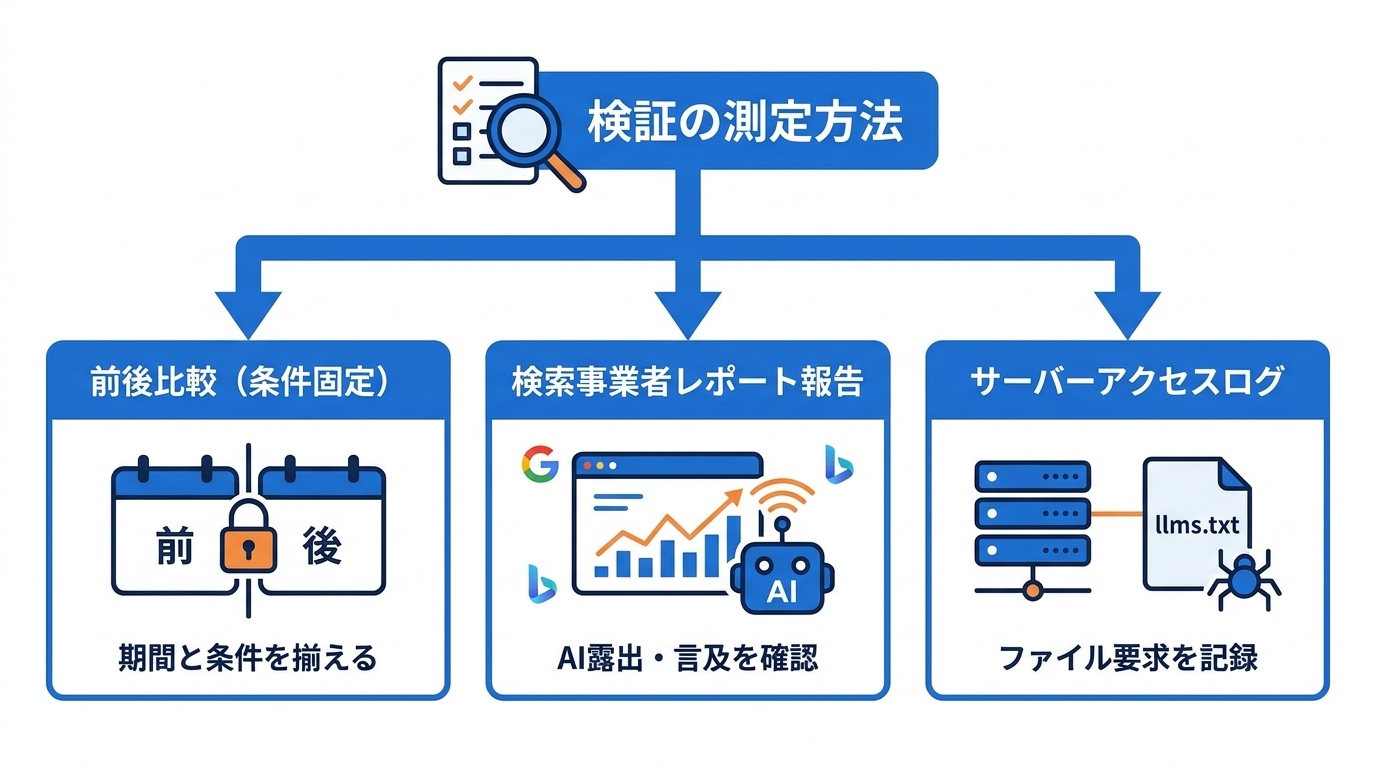
導入の前後を比べるには、期間の区切りと、同じ時期に動かさない条件を先に決めておく必要があります。これはllms.txtに限った話ではなく、どんな施策でも効果を記録するうえで最低限必要な設計です。
手順は3つです。
- 設置日を境にして前の期間と後の期間を同じ長さでそろえます。
- その間は大きなコンテンツ更新やサイト構造の変更をできるだけ重ねないようにします。
- 設置したファイルの内容、公開日、使った測定ツールと取得日を記録に残します。
こうして条件をそろえても、前後比較だけで原因は特定できません。Bing Webmasterのヘルプは、コンテンツを更新したあとの割合の変化をCitation Shareで確認できるものの、因果関係を示すものではないと説明しています(参照*1)。私自身、メディア運営の中で「施策前後で数値が動いた」という記録を積み重ねてきましたが、それが原因かどうかを断言できた経験はほとんどありません。
1つのサイトだけの検証では、他の要因と切り分けることはできません。記録を残す目的は、あとから条件を確認できるようにすることです。「効果があった」という結論ではなく、「このタイミングで何をしたか」という事実を残すことに意味があります。
AI経由流入と言及状況の測り方
AIでの露出は、検索事業者が用意しているレポートで確認します。
Google検索のブログによると、Search Consoleの新しいレポートでは、AI OverviewsやAI Modeなど検索の生成AI機能と、Discoverの生成AI機能でのインプレッションを専用のビューで確認できます。このデータは全体のパフォーマンスレポートにも含まれ、引き続き追跡されます。確認できる内訳は、サイトのURLが生成AI機能に表示された頻度を示すインプレッション、AI機能内に表示されたURLが分かるページ、国ごとの可視性を示す国です(参照*2)。私が運営するメディアでもこのレポートを月次で確認していますが、GA4の標準分類だけでは見えにくいAI経由の流入を把握する手がかりとして、現時点では有効だと感じています。
言及の指標は、流入の指標とは分けて読みます。Bing Webmasterのヘルプは、引用はAIが生成した回答でコンテンツが目に見える形で参照または表示されたことを示すもので、トラフィックやクリック、ユーザーエンゲージメントを表すものではないと明記しています。また、AI Performanceレポートの比較機能を使うと、現在の表示と同じグラフに過去の期間を重ねて表示でき、引用指標が時間とともにどう変化したかを視覚的に確かめられます(参照*1)。ここで重要なのは、「引用された=クリックされた」ではないという点です。AIO/GEOの文脈では、クリックされない接触もブランド形成には影響するため、流入だけを見ていると見落とすシグナルがあります。
クローラーのアクセスログの見方
3つ目の指標は、サーバーのアクセス記録に残るファイルへのリクエストです。
llms.txtの提案では、エージェントが必要な情報を見つけるためにllms.txtを確認または検索し、関連するリンクをたどることが想定されています。そのため、ファイル内のリンクは、元のページのMarkdown版など、LLMに適したコンテンツを指す必要があるとしています(参照*3)。この想定に沿って、ログではファイル本体が取得されたかと、そこに記載したリンク先が続けて取得されたかの両方を確認します。クローラーの種別も記録しておくと、どのシステムがアクセスしているかの傾向が見えてきます。
ただし、取得された記録があっても、その内容が回答に使われた証拠にはなりません。ログで分かるのは、いつ、どのファイルにリクエストがあったかという範囲です。
導入手順と設置ファイルの中身
ファイルの構成と設置場所
設置するファイルには決まった形式があり、置く場所で対象範囲が変わります。
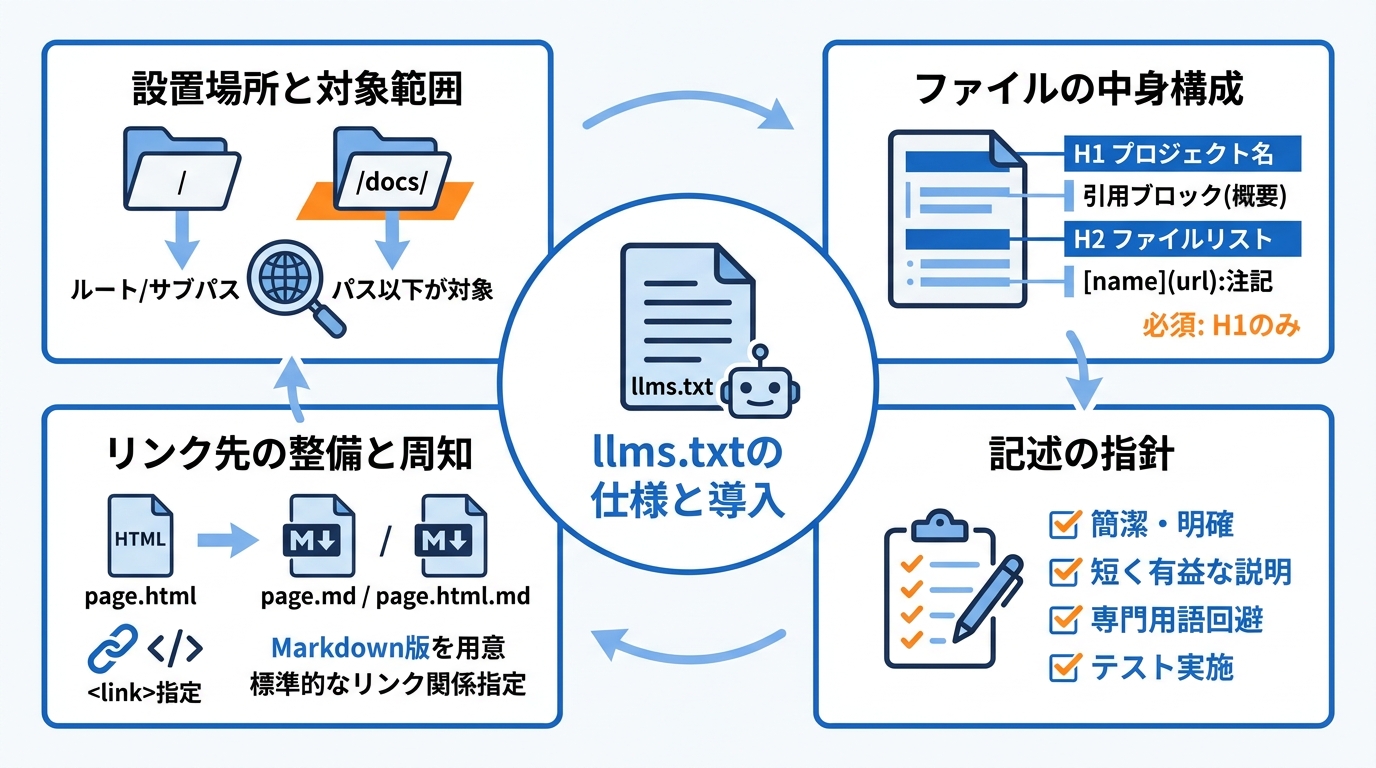
llms.txtの提案では、ファイルの置き場所はサイトのルートパスの「/llms.txt」、または任意のサブパス(例:「/docs/llms.txt」)で、ファイルはそのパス以下のURLを対象とします。複数のファイルが該当する場合、エージェントは最も具体的なものを使う必要があります。中身の構成は5つです(参照*3)。
- 任意のバイトオーダーマーク
- プロジェクト名またはサイト名を示すH1見出し
- プロジェクトの短い概要を示す引用ブロック
- 見出し以外の任意のMarkdownセクション
- H2見出しで区切られた「ファイルリスト」のセクション
必須のセクションはH1見出しだけで、概要の引用ブロックや各セクションはそれ以外の位置づけになります。各ファイルリストはMarkdownのリストで、必須のMarkdownリンク「[name](url)」に続けて、任意で「:」とファイルについての注記を書きます。
この仕様は標準化団体の規格ではなく提案です。公開元のリポジトリでは、2年間の導入を通じて学んだことを踏まえて更新した提案のv2だと説明し、何千ものサイトがllms.txtファイルを公開し、ドキュメントプラットフォームが自動生成している状況を挙げています(参照*4)。標準化されていない提案である以上、各AIシステムがこれをどう扱うかは各社次第であり、robots.txtのように業界全体で統一的な扱いが保証されているわけではありません。
リンク先の整備と見つけてもらう工夫
ファイルを置くだけでなく、リンク先の形と、ファイルの存在の伝え方もあわせて整えます。
llms.txtの提案では、エージェントが必要とする可能性のある情報を載せたページについて、元のページと同じURLにすっきりしたMarkdown版を用意することが勧められています。やり方は、ファイル名の末尾に「.md」を足す方法(page.html.md)か、拡張子を「.md」に置き換える方法(page.md)です。
クライアントがこれらのファイルを見つけられるよう、標準的なリンク関係の使用も勧めています。ページのMarkdown版を指す指定と、そのページを対象とするllms.txtファイルを指す指定の2種類です(参照*3)。
中身を書くときの指針は4つあります(参照*3)。
- 簡潔で明確な言葉を使うこと
- リソースへのリンクに短く有益な説明を付けること
- 曖昧な言葉や説明のない専門用語を避けること
- llms.txtだけを出発点としてエージェントにコンテンツについて質問し、ファイルをテストすること
AI事業者と検索事業者の対応状況
検索側の公式見解
検証結果を読む前に、検索側がこのファイルをどう扱うと公表しているかを押さえます。
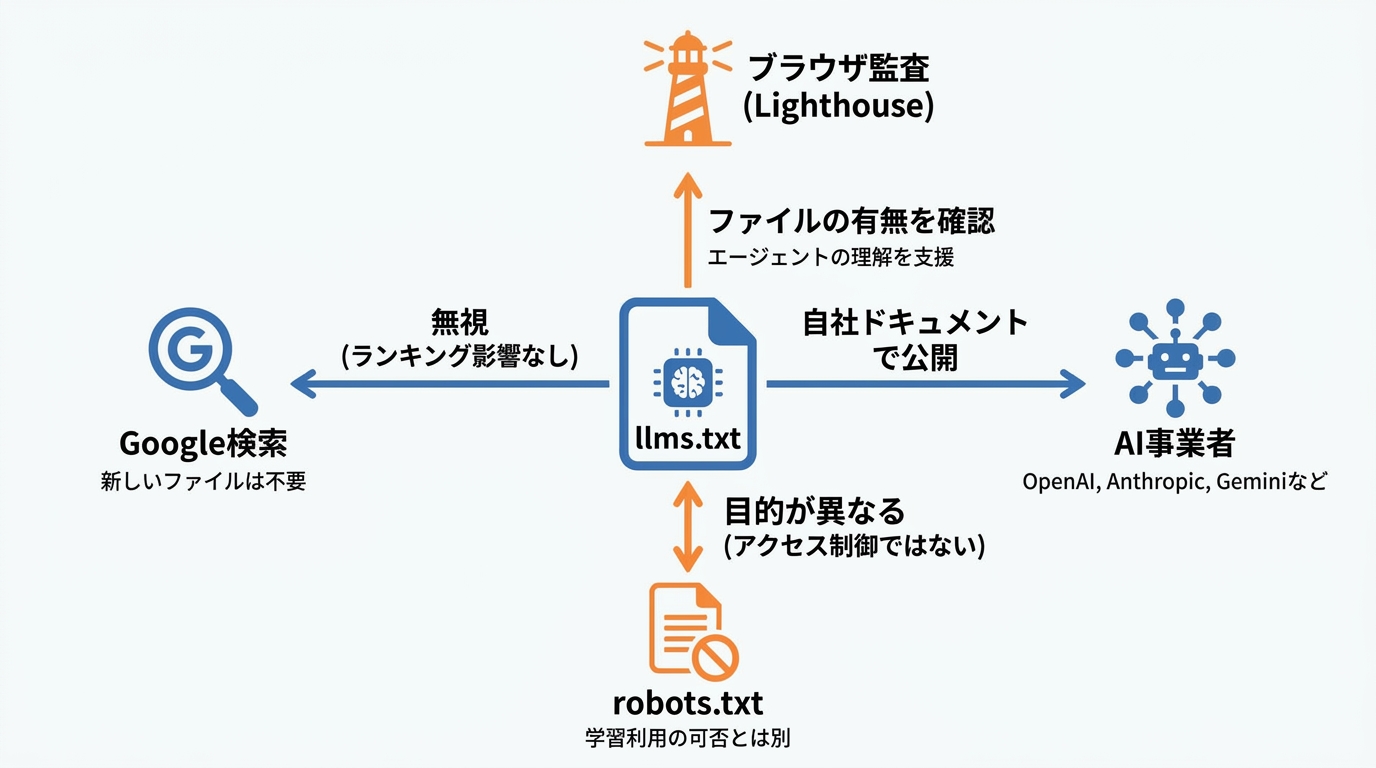
Googleの検索向けガイドは、生成AI機能を含むGoogle検索に表示されるために、新しい機械可読ファイル、AIテキストファイル、マークアップ、Markdownを作る必要はないとしています。理由として、Google検索はこれらを使用しないと説明しています。あわせて、これらのファイルを使う他のサービスやシステムのためにLLMS.txtファイルや同様のファイルを作成し、管理することは問題ないとも記しています。
Google検索はそれらを無視するため、作成してもGoogle検索でのサイトの可視性やランキングに、悪影響も好影響もないという整理です(参照*5)。この説明は、同社の検索製品を対象としたものです。つまり、Google検索での効果を期待してllms.txtを導入するのは、現時点では根拠のある判断とは言えません。
ブラウザ監査での扱い
一方で、ブラウザ側のツールではファイルの有無が検査項目になっています。
Search Engine Journalの記事によると、GoogleのLighthouseツールはバージョン13.3を公開し、新たに「Agentic Browsing」カテゴリを追加しました。このアップデートには、サイトがファイルを提供しているかを確認し、取得時にサーバーエラーがあると警告するllms.txt監査が含まれています。
同記事は、このカテゴリがSEO監査とは別のもので、llms.txtが検索順位やAIによる引用を改善するのではなく、ブラウザを利用するエージェントがサイト構造を理解するのに役立つことを示していると説明しています(参照*6)。検査項目にあることは、効果の根拠にはなりません。「Lighthouseで検査される=SEOに効く」と受け取るのは、ツールの用途を混同した解釈です。
AI事業者側の公開状況
AI事業者自身も、自社のドキュメント向けにファイルを公開しています。
llms.txtの提案元は、AI研究所が自社の開発者向けドキュメント用にllms.txtファイルを公開していると説明しています(参照*3)。
実際にある開発者向けファイルでは、見出しに続けて、各種機能や学習リソースのためのドキュメントハブだという概要が置かれています(参照*7)。
ここから言えるのは、自社で公開しているという事実までです。他社サイトのファイルを読むという約束とは別の話になります。自社がllms.txtを設置することと、AIが実際にそれを読んで回答に使うこととの間には、まだ大きな距離があります。
robots.txtとの違い
llms.txtは、アクセスを制御する仕組みではありません。
提案元の説明では、robots.txtとllms.txtは目的が異なります。robots.txtは、検索エンジンのインデックス作成用ボットなどの自動ツールに、サイトへのアクセスで許容される範囲を知らせます。llms.txtの情報は、エージェントがユーザーを支援する際に、特定の話題について情報が必要になったときに使われます(参照*3)。
学習利用の可否を伝える共通の設定についても、アクセス制御とは分けて考える必要があります。報道によれば、この設定はAI学習への利用を許可・拒否する意向を示すもので、クローラーのアクセス自体を遮断するものではなく、アクセスを制限するには従来のルールを別に設定する必要があります。
企業独自の設定や個別契約が優先される場合もあります。対応時期は事業者ごとに異なり、今後の実装予定や公表時期にも差があります(参照*8)。
3指標の変化と結果の読み方
変化が見えなかった場合の書き方
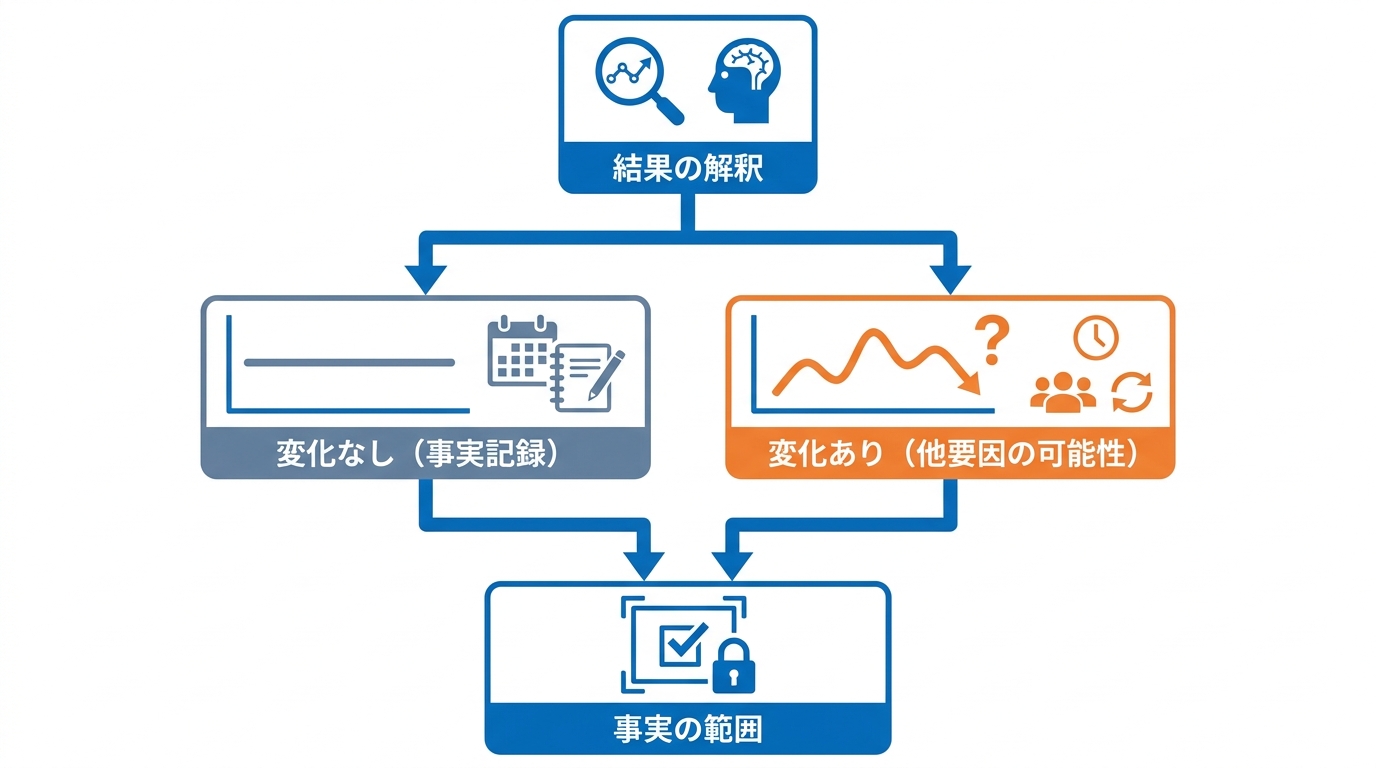
指標が動かなかったときは、期間と条件を添えた事実として記録します。
Googleの検索向けガイドは、LLMS.txtファイルや同様のファイルを作成し管理することは問題ないとしたうえで、Google検索はそれらを無視するため、作成してもGoogle検索での可視性やランキングに悪影響も好影響もないと説明しています(参照*5)。検索経由の指標が動かないことは、この説明と矛盾しません。
書き方としては、検証した期間、対象サイト、測った指標、使ったレポートを並べ、その範囲で変化が確認できなかったと書くにとどめます。期間を延ばした結果や、ファイルの内容を変えたあとの結果は、日付を添えて追記していきます。この積み重ねが、あとから読み返せる記録になります。
数値が動く他の要因
指標が動いたとしても、その原因をllms.txtの導入に結びつけることはできません。
Bing Webmasterのヘルプは、引用量が変わる理由として、ユーザーの需要、コンテンツの鮮度、モデルの更新、パートナーの更新サイクル、ユーザーが尋ねるトピックの変化を挙げています。さらに、比較機能については、2つの期間の間に何が変わったかは示すものの、変化の理由は説明しないと明記しています(参照*1)。
つまり、前後の数値がそろっても、そこから言えるのは「増えた」「減った」という事実までです。導入の効果として解釈すると、この範囲を超えてしまいます。これはllms.txtに限らず、AIO/GEO全般の測定に共通する難しさです。定量と定性を組み合わせながら、傾向を見るしかない時期が続きます。
導入すべきかの判断基準
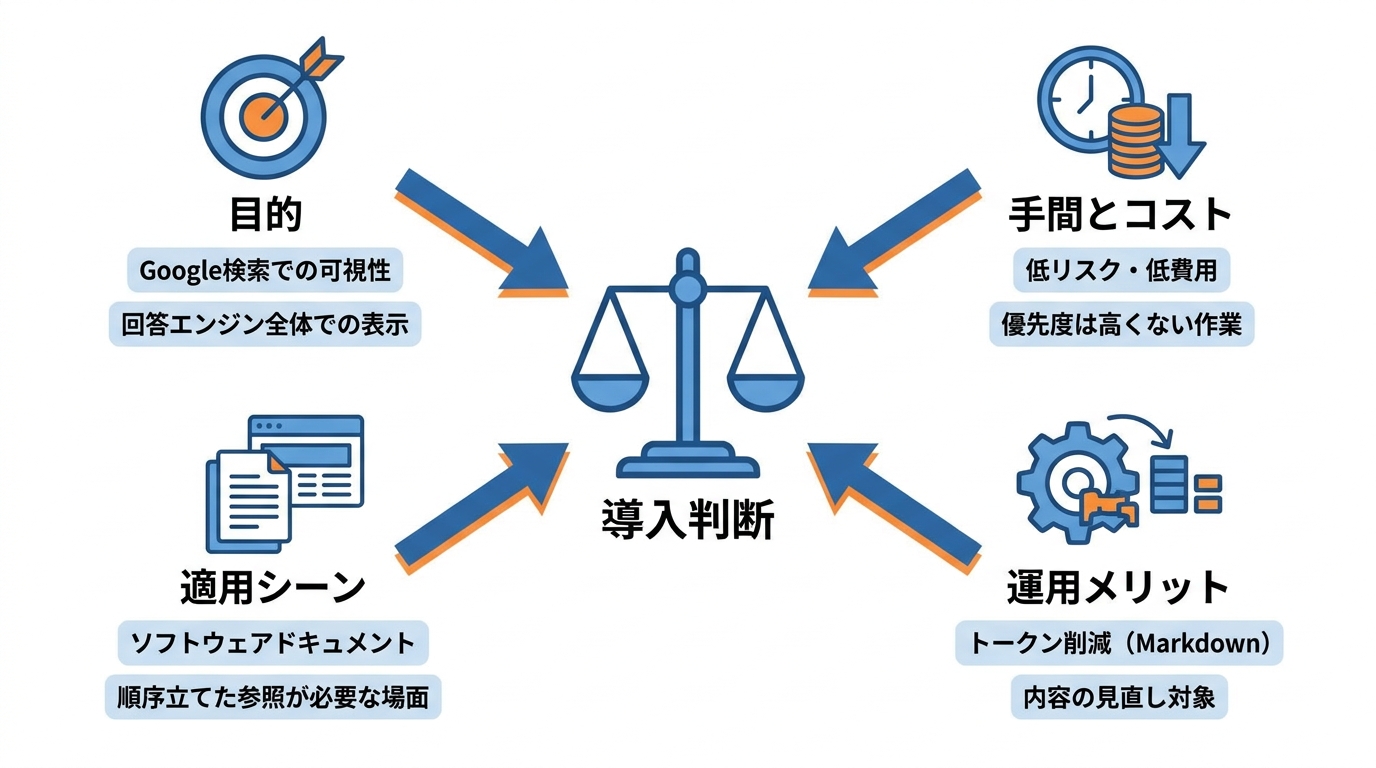
導入するかどうかは、何を目的にするかと、どれだけ手間がかかるかで整理できます。私が実際にこの問いを立てたとき、まず確認したのはGoogle検索以外の表示面をどこまで意識しているかという点でした。
Googleの検索向けガイドは、AEOやGEOの裏技より効果的なSEO戦略を優先するよう示し、Google検索ではコンテンツのチャンク化、llms.txtのような不要なAIテキストファイルの作成、不自然な言及を追求することなどの手法は気にする必要がないとしています(参照*5)。Google検索での可視性だけが目的なら、優先度は高くない作業です。その時間をコンテンツの質や1次情報の整備に使うほうが、現時点では費用対効果が高いと考えています。
別の見方もあります。ある解説記事は、広がりつつある回答エンジン全体でAI上の表示を目指すなら、llms.txtの管理はリスクが低く、読み取ることを選んだシステムには役立つ可能性があるとしています。
公開にほとんど費用はかからず、Googleでの評価を損なうこともないという整理です。そのうえで、順位を上げる近道ではなく、Google以外の表示面に向けた任意の実験として扱うことが重要だと述べています(参照*9)。
サイトの種類も判断材料になります。llms.txtの提案元は、このファイルがコーディングエージェントがAPIリファレンスやチュートリアルを探すソフトウェアドキュメントで特によく使われているとし、同じ構造は、エージェントがサイトのコンテンツを順序立てて参照する必要がある場面ならどこでも使えるとしています(参照*3)。
運用の面では、Cloudflareのスタイルガイドが、AIの料金の多くは入力トークンと出力トークンに基づいており、Markdownを使うと必要な入力トークン数を大幅に減らせると説明しています(参照*10)。リンク先と中身は、公開したあとも内容と合っているかを見直す対象になります。
おわりに
今回の整理で分かったのは、検証のやり方と、そこから言える範囲の線引きです。期間と条件をそろえ、生成AI機能のインプレッション、引用の指標、サーバーのアクセス記録を並べれば、変化の有無までは記録できます。一方で、その理由までは前後比較から分かりません。これは厳しい制約ですが、逆に言えば、「効果があった」と言い切っている記事があれば、その根拠を疑うべきだということでもあります。
Google検索はllms.txtを使わないと明示しており、作っても可視性や順位への影響はないとしています。だからこそ、効果を言い切るのではなく、測った条件と日付を添えて記録を残し、必要に応じて追記していく形が現実的です。AI検索対策全般に言えることですが、まずは手動で代表的なプロンプトを試し、自社がどう言及されているかを観察するところから始めるのが順序として正しいと思います。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) AI Performance – Bing Webmaster Tools
- (*2) Google for Developers – Introducing Search Generative AI performance reports in Search Console
- (*3) llms-txt – The /llms.txt file, v2
- (*4) GitHub – AnswerDotAI/llms-txt: The /llms.txt file, helping language models use your website · GitHub
- (*5) Google for Developers – Google's Guide to Optimizing for Generative AI Features on Google Search
- (*6) Search Engine Journal – Google's llms.txt Guidance Depends On Which Product You Ask
- (*7) https://developers.openai.com/llms.txt
- (*8) Yahoo!ニュース – robots.txtで「クロールはOK、でもAIの学習には使わないで」を明示可能に OpenAIやGoogleら
- (*9) Media Broker Daily – Google Says LLMs.txt Is Fine to Use, but It Will Not Help Your Rankings
- (*10) Cloudflare Docs – AI consumability