この記事のまとめ
AI検索で自社と競合のどちらが挙がるかは、感覚ではなく記録で確かめられます。同じ質問群を複数のAIに投げ、「言及率」「推薦順位」「引用元」の3指標で整理すると、差がどこにあるかが見えてきます。進め方は4つの流れです。
- 質問リストを作る
- 複数のAIで調べる
- 差の要因を分析する
- 施策の優先順位を決める
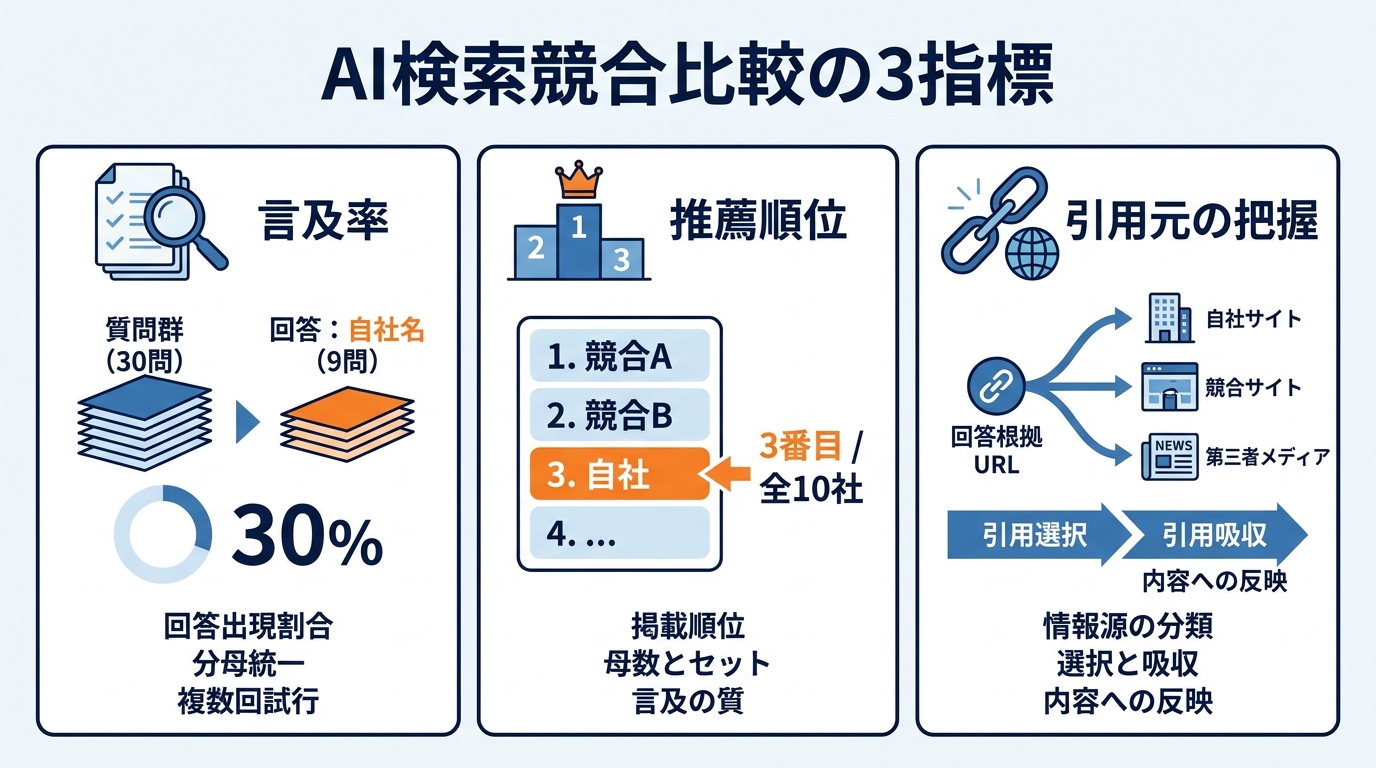
- 言及率は、同じ質問群のうち自社名や競合名が回答に出た割合です。分母となる質問数と試行回数をそろえて数えます。
- 推薦順位は、回答の中で何番目に挙がったかを見る指標です。一緒に挙がったブランド数とあわせて確認します。
- 引用元は、回答の根拠として示されたURLを自社・競合・第三者メディアに分けて集計します。
- 分析では、引用元ページの構成や内容、第三者メディアでの言及量を手がかりに仮説を立て、小さく検証します。
AI検索の競合比較で見る3指標
言及率の意味と数え方
言及率は、用意した質問群のうち、回答に自社名や競合名が出てきた割合です。AI検索において「自社が認知されているか」を最も直接的に測れる指標であり、まず最初に確認すべき数字です。
数え方はシンプルです。たとえば質問を30問用意し、そのうち自社名が出た回答が9問なら、言及率は30%になります。競合についても同じ質問群で数えると、横に並べて比べられます。
重要なのは分母をそろえることです。自社だけ質問を増やしたり、競合だけ試行回数を減らしたりすると、割合の意味がずれてしまいます。比較は条件が同じだからこそ意味を持ちます。
また、AIの回答は同じ質問でも毎回同じとは限りません。1回だけの結果を確定した数値として扱わず、同じ質問を複数回試して記録する形にしておくと、ぶれが小さくなります。
私が自社メディアの調査を始めた当初、同じ質問を1回だけ投げて「出た・出なかった」と判断していましたが、翌日試すと結果が変わることを何度も経験しました。AIの回答には確率的なゆらぎがあるため、最低でも同じ質問を3〜5回は試し、平均的な傾向として見るようにしています。
推薦順位の意味と比較
推薦順位は、回答の中で自社が何番目に挙げられたかを見る指標です。
言及率だけでは、名前が出たかどうかしか分かりません。同じ「出た」でも、最初に紹介されるのと、最後に一言だけ触れられるのとでは、読み手の受け取り方がまったく変わります。AIの回答で最初に挙げられるブランドは、人間が検索結果の1位クリックするのと同じような効果があると私は見ています。そこで、回答に挙がったブランドを上から順に並べ、自社が何番目かを記録します。
このとき、一緒に挙がったブランドの数もあわせて残します。3社しか出ていない回答の3番目と、10社出ている回答の3番目では、意味が違うためです。
順位と母数をセットで見ることで、言及の有無だけでは分からない差が整理できます。
引用元の把握と自社・第三者の切り分け
引用元は、回答の根拠として示されたURLを集めて、どこのサイトが使われているかを見る指標です。
集めたURLは、自社サイト、競合サイト、第三者メディアの3つに分けて数えます。こう分けると、名前は回答に出ているのに自社サイトは参照されていない、といった状態に気づけます。逆に、自社サイトが引用されていても回答の中心は競合の話、という形も見えてきます。
研究者たちは、AI検索での見え方を、引用されること自体と、そのページの中身が回答にどれだけ反映されたかに分けて捉えています。選ばれた情報源の幅を「引用選択」、回答への影響の深さを「引用吸収」と呼ぶ2段階の枠組みを示しました(参照*1)。この枠組みは、私が実際に複数のAIサービスで自社コンテンツの引用状況を確認するときにも有用で、「URLが表示された=回答に影響している」ではない点を常に意識するようになりました。
つまり、引用元の一覧は出発点で、そこに載ることと内容が回答に活きることは別の段階として見ることになります。
調査する質問リストの作り方
営業現場の質問と比較検討キーワード
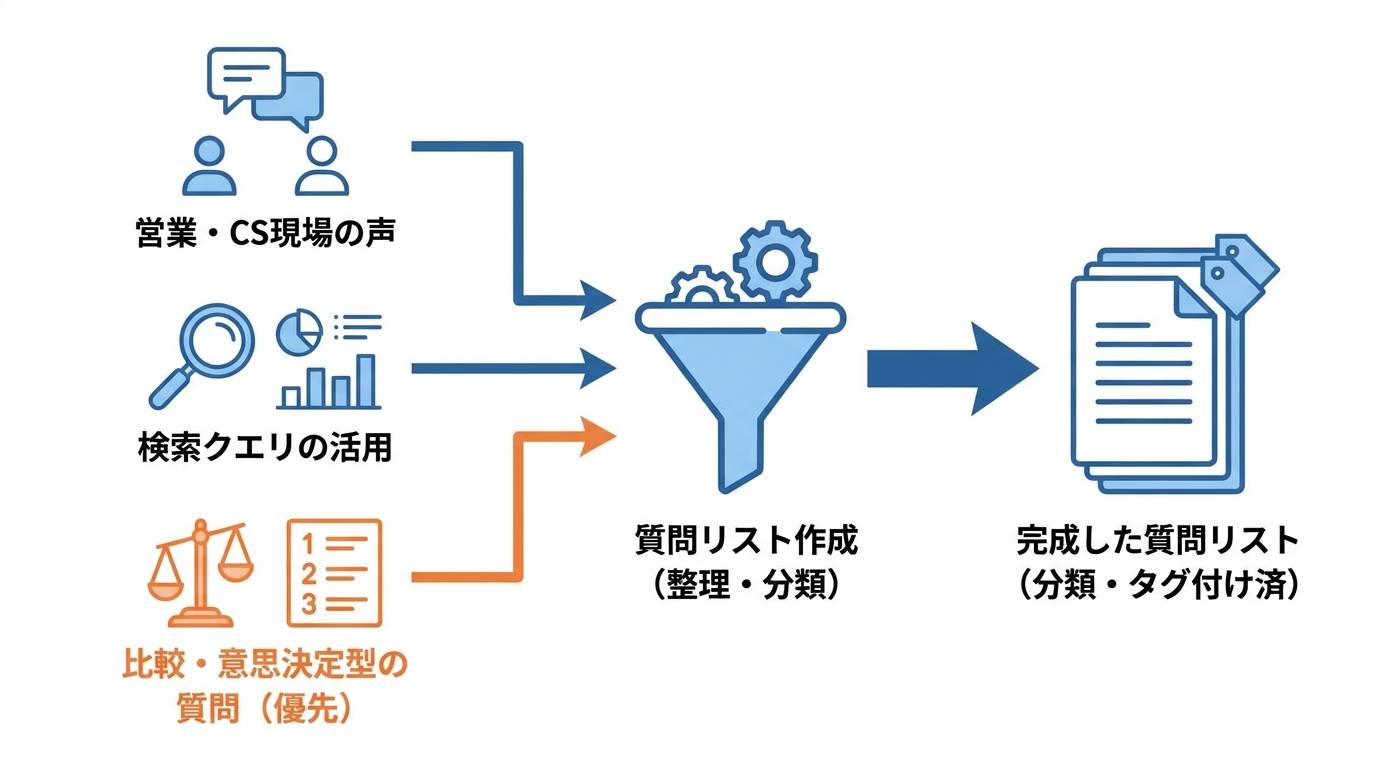
質問リストの出発点は、すでに社内にある「お客様から実際に聞かれている質問」です。ここを飛ばして、いきなりキーワードツールで作ろうとする企業が多いですが、順序が逆です。
営業やカスタマーサポートには、商談や問い合わせで繰り返し出てくる質問がたまっています。導入前に何を比べたか、どこで迷ったか、どんな条件を気にしたかを拾い出し、そのままAIに投げられる文章に直します。こうした現場の言葉は、AIが回答を生成するときに使う「実際のユーザープロンプト」に最も近い形をしています。
あわせて、比較、おすすめ、選び方、条件での絞り込みといった検討段階の言葉を組み合わせると、購買に近い質問が作れます。
このとき、自社名を入れた質問ばかりにしません。自社名を指定すれば自社の話が返るのは当然で、競合と並べたときの差が分からなくなります。業界やカテゴリの名前で聞く質問を軸にそろえます。
検索クエリの活用と質問の分類
実際に検索された言葉も、質問リストの材料になります。
Google Search Consoleのような検索管理の画面では、自社サイトが表示された検索語を一覧で確認できます。難しい操作は不要で、表示された検索語を期間で絞って書き出すだけで十分です。短い単語の並びになっていることが多いので、人が話すときの言い方に直してAIへの質問文に仕上げます。
集めた質問は、そのまま並べると管理しづらくなります。情報収集の段階か、比較の段階か、導入直前かといった検討段階と、どの商材やカテゴリの話かでタグを付けておきます。
分類しておけば、集計のときに段階別やカテゴリ別で言及率を出せます。
比較・意思決定型の質問を優先する理由
限られた時間で調べるなら、比較や絞り込みを含む質問から手を付けます。
Googleは、米国のAI Modeについて、短いクエリも長いクエリも増えており、AI Modeでの検索の平均的な長さは従来の検索クエリの3倍だと説明しています。さらにトレンドデータとして、アイデア出しに関するクエリが開始以来クエリ全体よりも30%速く増えており、「どこへ行く」「どこに行くべきか」「〜のアイデア」といった言葉で始まる検索も増えているとしました(参照*2)。これは米国のAI Modeで見られた傾向ですが、日本市場でも同じ方向に動くと考えておくべきでしょう。
質問の型による違いも報告されています。研究では、「AとBのどちらが良いか」といった比較クエリや、「トップ10は何か」といったリスト型のクエリが、最も高い影響スコアをもたらすと示されました。
こうした場面では、AIが回答に必要な基準や項目を外部の情報源に頼らざるを得ないためだと説明されています(参照*1)。
複数AIでの調査手順と記録方法
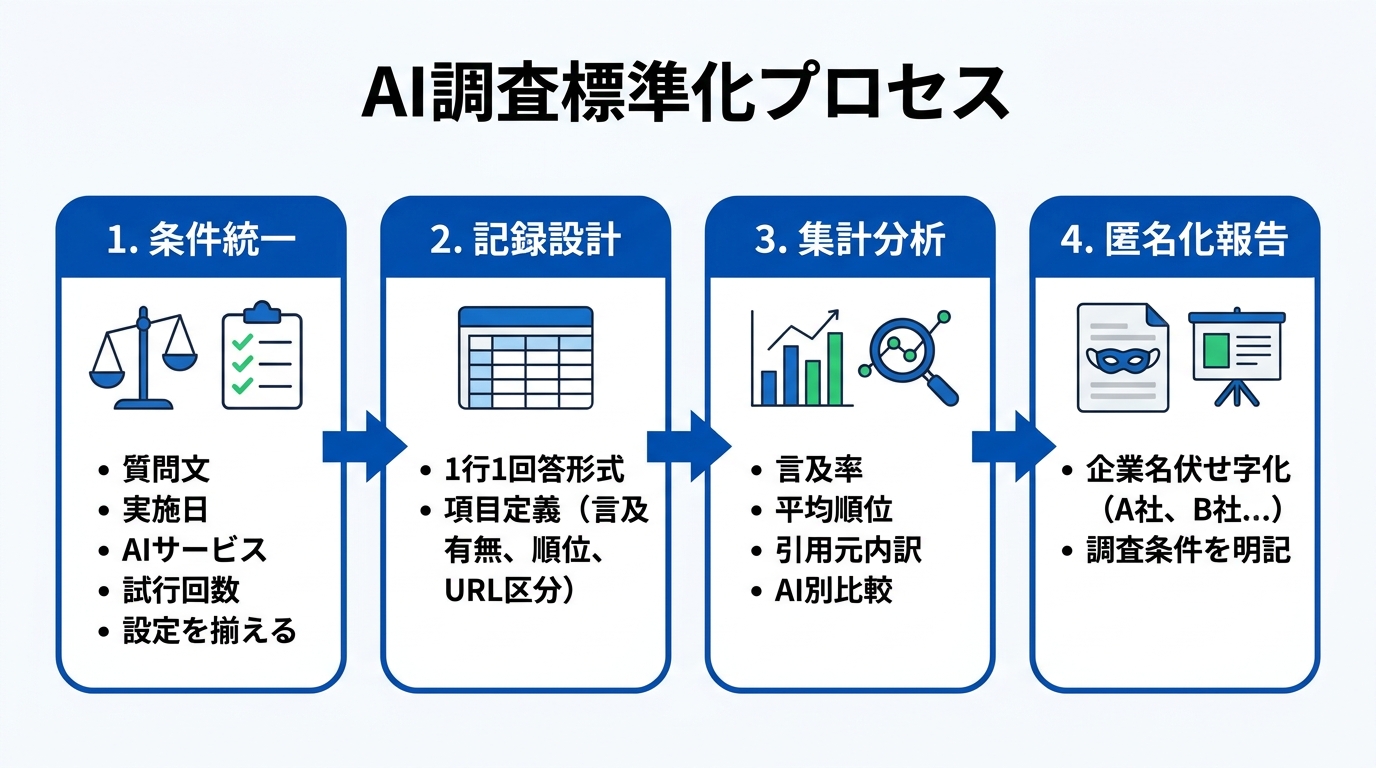
調査条件のそろえ方
比較できる結果にするには、質問を投げる前に条件をそろえておきます。
そろえる項目は5つあります。
- 質問文
- 実施日
- 使ったAIサービス
- 同じ質問を何回試したか
- 地域や言語の設定
質問文は一字一句同じものを使い、AIごとに言い回しを変えないようにします。試行回数も、自社に有利な質問だけ多く試すといったことがないよう統一します。この点は、プロンプトをテストするときと同じ発想です。変数を一つに絞らないと、何が影響したのかが分からなくなります。
過去のやり取りが残っていると回答が引きずられることがあるため、毎回新しい会話で聞く形にそろえておくと条件が安定します。
AIの回答は日によって変わります。1回の結果だけで自社と競合の優劣を結論づけず、日をずらして複数回記録します。
調査シートの項目設計
記録は、1行に1回答という形でためていくと集計が楽になります。
列として用意する項目は11あります。
- 質問文
- 検討段階などのタグ
- AIサービス名
- 実施日
- 何回目の試行か
- 自社名が出たかどうか
- 自社の推薦順位
- 同じ回答に出てきた競合名
- 回答に挙がったブランドの数
- 引用されたURL
- そのURLの区分
区分は自社サイト、競合サイト、第三者メディアの3つに分けます。
この形でためておくと、言及の有無の列から言及率、順位の列から推薦順位の平均、URL区分の列から引用元の内訳と、3指標にそのまま変換できます。
ここで挙げた項目は記録の一例です。扱う商材や調べたい観点に応じて、列を足したり減らしたりして使う形になります。
AIごとの違いの扱い方
集計は全体の平均だけでなく、AIサービス別にも出しておきます。私自身、複数のAIサービスに同じ質問を投げると、引用されるURLも言及されるブランドも意外なほど異なることを確認しています。
研究では、さまざまな業界やタスクの種類にまたがる602のプロンプトを含む、geo-citation-labという管理されたデータセットを使い、主要なAI検索プラットフォームごとの行動の型が調べられました。プラットフォームごとに、引用するソースの数や、回答への反映のされ方には差があると報告されています(参照*1)。
これらは特定のデータセットでの測定結果であり、いつでも同じ値になるものではありません。ただ、傾向としてプラットフォームごとに引用の広さや回答への反映度に違いがあると知っておくと、どのプラットフォームの対策を優先するかの判断材料になります。引用の広さと内容が回答に反映される深さは別物なので、AI別に集計しないと差が見えにくくなります。
匿名化した調査結果のまとめ方
社外に結果を見せるときは、企業名を伏せた形に整えます。
自社をA社、競合をB社、C社と置き換え、対応表は社内だけで持ちます。そのうえで、使った質問群の内容と数、調査した期間、1問あたりの試行回数、対象にしたAIサービスの数を本文に明記します。
条件が書かれていれば、読み手はその数字がどの範囲の話かを判断できます。
本記事では実測値そのものは示しませんが、整理の型としてはこの形になります。
競合との差を生む要因の分析
引用元ページの構成と内容の確認
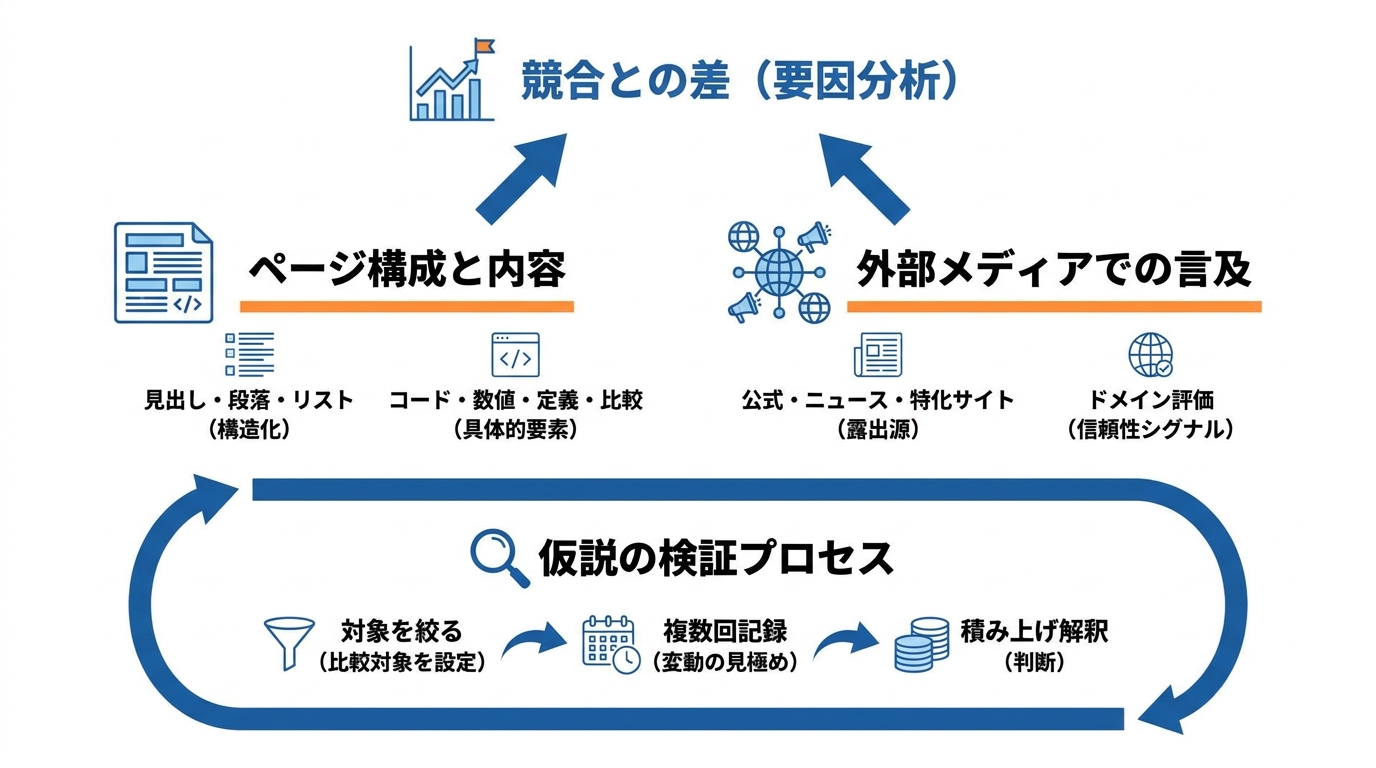
差の要因を探る最初の手がかりは、競合側で引用されているページそのものです。私がクライアントの調査を手伝うとき、競合の引用ページを実際に開いて読む作業を必ず入れます。データだけ見ていると、なぜ選ばれているかの感覚が掴めないからです。
研究では、影響力スコアが上位25%のページは、下位25%のページと比べて見出しが12倍以上、段落が5倍多く、リストの密度もはるかに高いと報告されています。情報がまとまった単位に整理されていると、AIが内容を取り出しやすいことを示唆するとしています。
さらに、影響力の向上が大きかった内容要素として、コードスニペットが76.9%、数値と統計が61.5%、定義マーカーが57.3%、比較コンテンツが55.3%と挙げられました。
ただし、形式を整えれば必ず引用されるわけではありません。同じ研究では、強調スニペット向けに広まったQ&A形式そのものが、生成された回答への吸収とわずかな負の相関、-5.74%を示したと報告されています(参照*1)。SEO向けの定石がAI検索ではむしろ逆効果になる可能性があり、従来の最適化手法をそのまま持ち込むのは危険です。
第三者メディアでの言及量の確認
引用元の内訳を見ると、自社のページを修正すべきか、外部での露出を増やすべきかを切り分けられます。この判断を感覚でやると、効果のない施策に時間を使うことになります。
研究では、情報源の選ばれ方は比較的一極集中しており、公式ウェブサイト、ニュースメディア、特定分野に特化したサイトが、すべてのプラットフォームで引用の79%から87%を占めていました。ドメイン評価で測られる信頼性のシグナルは最初の選択では効くものの、その内容が回答に吸収されることまでは保証しないとしています(参照*1)。
自社の調査で、競合の引用元が第三者メディアに偏っているなら、外部での言及量が差の候補になります。自社サイトが引用されているのに回答の中身に出てこないなら、ページの内容側を見る順番になります。
仮説の検証と変動の見極め
分析で出てくるのは、あくまで差の理由についての仮説です。ここを「結論」と扱ってしまうのが、AI検索対策でよくある失敗です。
検証するときは、手を入れる対象を絞ります。たとえば特定のカテゴリの質問に関係するページだけを見直し、他のカテゴリは変えないまま残します。変えない側を比較対象として置いておけば、全体が同じように動いたのか、手を入れた側だけが動いたのかを見分けやすくなります。
AIの回答は日によって変わります。変更の前後それぞれで同じ質問を複数回記録し、同じ条件で並べて比べる形にします。
1回の上下で判断せず、記録を積み上げてから解釈する進め方になります。
分析結果からの施策の優先順位
着手する質問の選び方
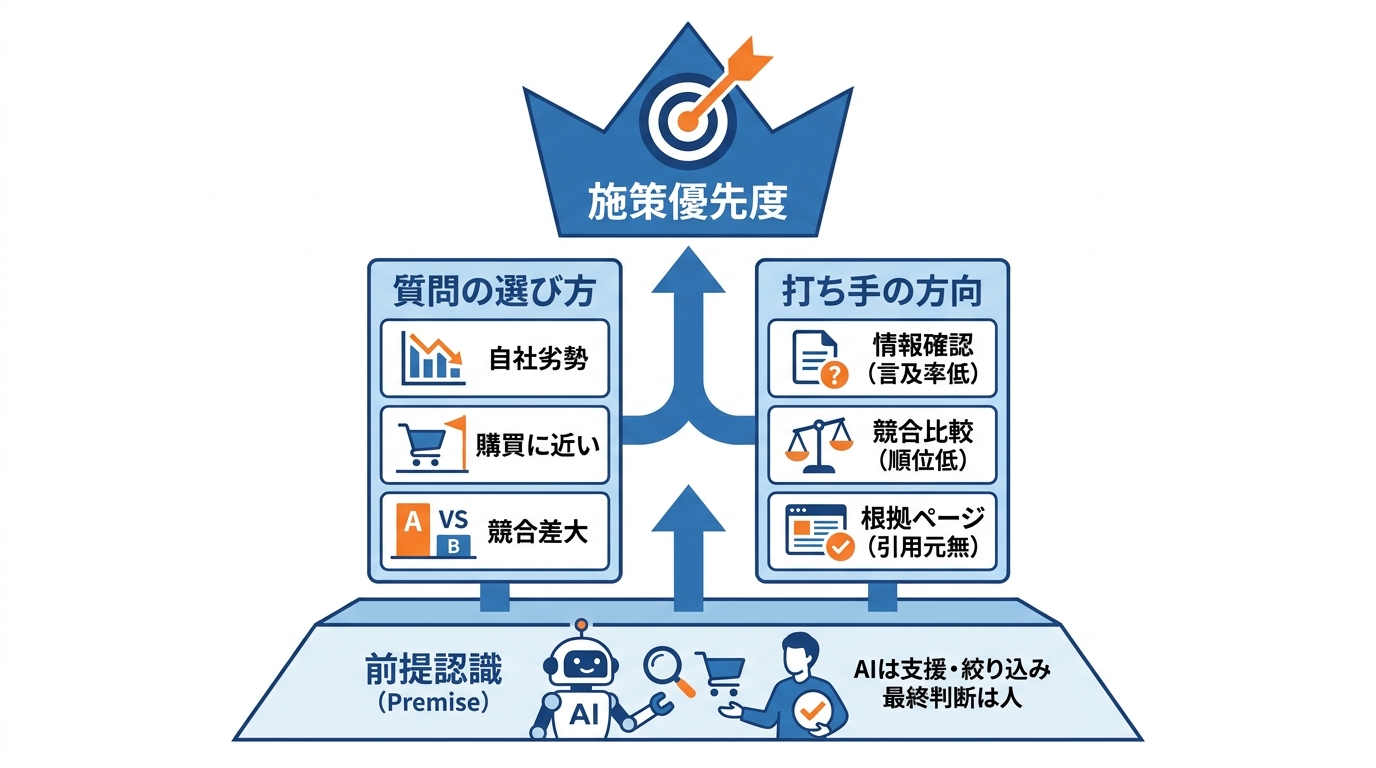
すべての質問に同時に取り組むのは難しいため、並べ替えて上から着手します。
観点の1つ目は、自社が劣勢な質問です。言及率が低い、順位が下のほうに固まっているといった質問は、伸びしろがそのまま課題として見えています。2つ目は、検討段階が購買に近い質問です。比較や絞り込みの段階での言及は、情報収集段階より直接的に商談に影響します。
質問リストに付けたタグを使えば、比較や絞り込みの段階の質問をすぐ取り出せます。3つ目は、競合との差が大きい質問です。
同じ回答に競合が繰り返し出て、自社が出ていない質問は、差の要因を分析する対象としても扱いやすくなります。
この並べ方は判断の枠組みの一例で、商材や体制によって順番は変わります。
指標別に見る打ち手の方向
3指標のどれが弱いかによって、見直す対象が変わります。
言及率が低い場合は、そもそも自社が候補として扱われていない状態なので、その質問に対応する情報が世の中に出ているかから確認します。推薦順位が低い場合は、候補には入っているので、同じ回答に挙がった競合がどう紹介されているかと見比べる形になります。
引用元に自社サイトが入らない場合は、回答の根拠として使われるページがあるかどうかが論点です。
どの方向に動くかは、引用元ページの構成や内容、第三者メディアでの言及量といった分析の結果とあわせて決めることになります。
購買行動を踏まえた期待値の置き方
AI検索での見え方は、買い手の判断材料の一部として位置づけます。ここで過度な期待を持つのも、逆に軽視するのも、どちらも現実を見ていないと私は考えています。
Gartnerが2026年1月に米国の消費者322人を対象に実施した調査では、商品の選択肢を絞り込むAIツールへの抵抗感はより低いことが分かりました。家庭用品の購入でAIに選択肢を絞り込ませてもよいと考える人は31%、家電製品では28%でした。
同社のマーケティング部門バイスプレジデント兼アナリストであるKate Muhl氏は、消費者は買い物の判断をAIに委ねたいわけではなく、より良い情報を見つけ、価格を比較し、お得な商品を見つけ、選択肢を絞り込むためにAIを使いたい一方で、最終的な判断は自分で行いたいと考えていると述べています(参照*3)。
これは米国の消費者を対象とした、時期と人数が限られた調査の結果です。ただ、「最終判断は自分でしたい」という感覚は日本の購買行動とも重なります。AI検索は選択肢を絞り込む段階で使われる、という前提でコンテンツを設計するほうが現実的です。
おわりに
AI検索での競合比較は、言及率、推薦順位、引用元の3指標で整理すると、自社と競合の差がどこにあるかを言葉にできます。質問リストを作り、条件をそろえて複数のAIで調べ、1行1回答の形で記録すれば、そのまま3指標に集計できます。大切なのは、ツールや自動化から入るのではなく、まず手動で20〜30問を試し、自社の状況を自分の目で確かめることです。
差の要因は、引用元ページの構成や内容、第三者メディアでの言及量を手がかりに仮説を立て、変えない比較対象を置いて小さく確かめます。回答は日によって変わるため、記録を続けて通常の変動と施策による変化を見分ける形になります。SEO対策と同じく、AI検索対策も即効性を期待するより、数ヶ月単位で傾向を積み上げていく姿勢が必要です。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))