この記事のまとめ
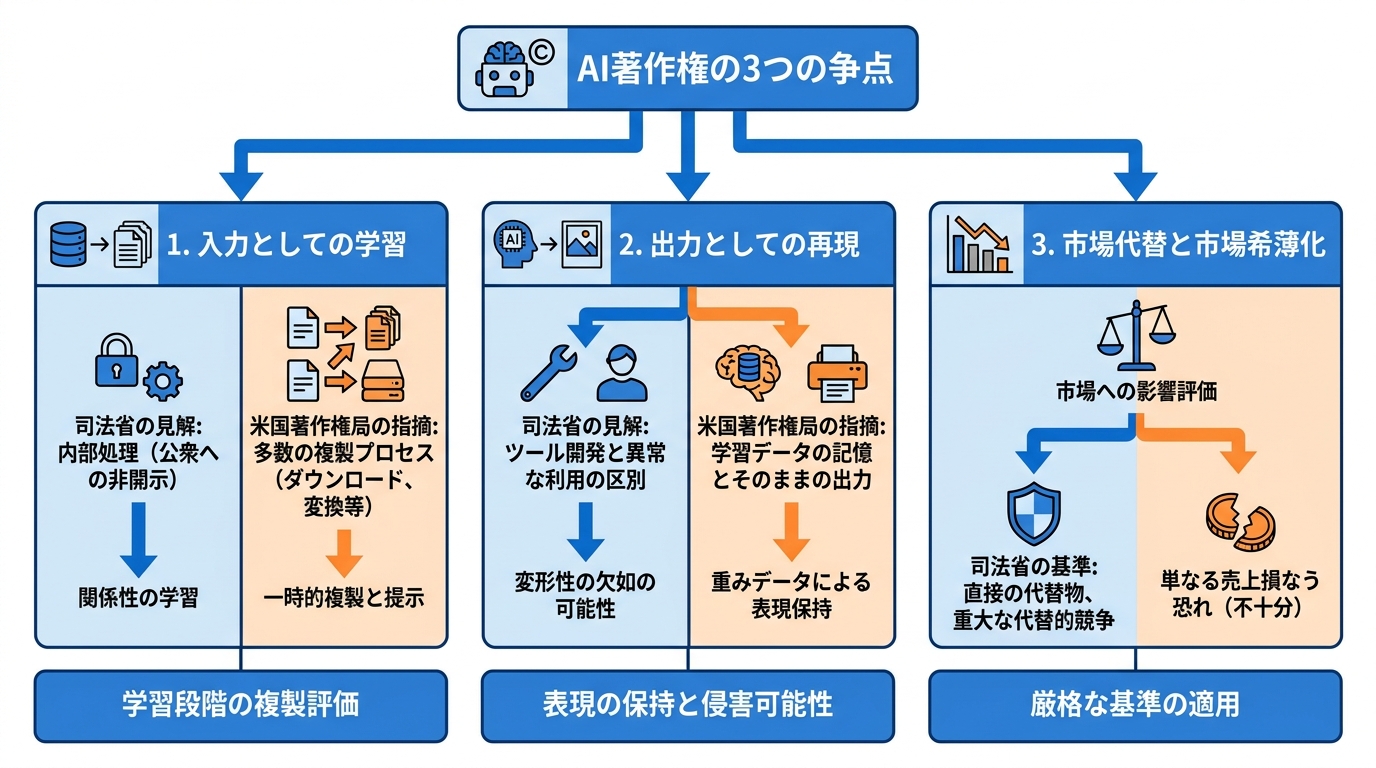
AI学習がフェアユースに当たるかという問いに対し、米司法省は意見書で「著作権で保護された資料を用いたAIモデルの学習それ自体は著作権法に違反しない」との立場を示しました。ただし、これは判決ではなく、裁判所の最終結論はまだ下されていません。この議論を読み解くカギは、入力・出力・市場代替という3つの争点に整理することです。
- 米司法省は2026年9月1日、ニューヨーク南部地区連邦地裁に意見書を提出し、学習段階の複製を極めて変革的なフェアユースとして扱うよう助言しました。
- 意見書に裁判所への拘束力はなく、ニューヨーク・タイムズ対OpenAIの訴訟が決着したことを意味するわけではありません。
- 争点は、学習時の複製という入力、逐語的な再現という出力、同種の作品の市場が奪われる市場代替という3点に整理できます。
- AI学習用のライセンス契約が広がる一方で、ニューヨーク・タイムズは開発済みモデルの破棄まで求めています。
司法省が示した立場
意見書の中心的な主張
米司法省は、著作権で保護された資料を用いたAIモデルの学習それ自体は著作権法に違反しないとする見解を裁判所に示しました。ただし、これは判決ではなく、あくまで行政機関の意見書です。この点は、報道を読む際に最初に押さえておくべき事実です。
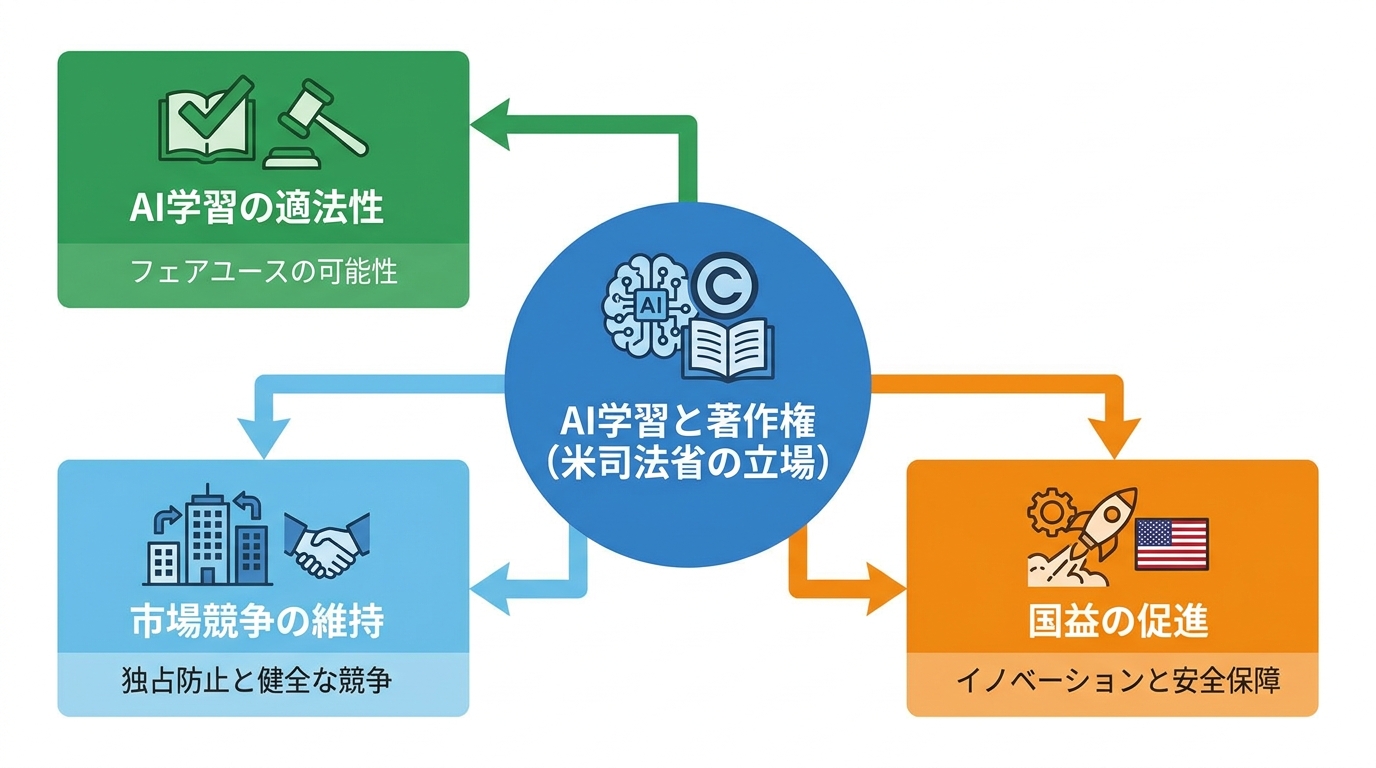
司法省の意見書は、イノベーションと表現の自由を促進する国益に沿うものとして、著作権で保護された資料を用いたAIモデルの訓練自体は著作権法に違反しないと述べています。また、本訴訟におけるニューヨーク・タイムズの主張は、OpenAIの大規模言語モデル(LLM)の訓練を適用対象から除外するようフェアユースの法理を狭めるものだ、と位置づけました(参照*1)。
司法省は、AIをめぐる一連の行為を段階別に整理しています。意見書では、各段階が著作権法上の異なる問題を提起しうるとしたうえで、訓練段階において著作物を学習データとしてモデルに入力するために複製する行為が、フェアユースに該当するかという論点に焦点を当てると説明しました(参照*1)。
この意見書は、2026年9月1日に合衆国法典第28編第517条に基づいて提出されました。出力を生成する段階とは切り離し、モデルの学習を現行法上で「極めて変革的な」フェアユースとして扱うよう裁判所に助言する内容です(参照*2)。
ただし、この文書はあくまで意見書であり、裁判所の判決ではありません。第517条に基づく利害関係者意見書は裁判官の心証に影響を与える可能性はあるものの、裁判所を直接拘束する力はなく、ニューヨーク・タイムズ対OpenAI事件の訴訟に決着がついたわけでもありません(参照*3)。私がこの議論を追っていて最も気になるのは、「司法省が合法と言った」という見出しだけが独り歩きし、意見書と判決の区別が曖昧になることです。この混同は、コンテンツ制作やメディア運営の現場でも無関係ではありません。
国家安全保障と競争という理由
司法省は、著作権の解釈を論じる中で、国家安全保障と公正な競争という政策的な観点を挙げています。
意見書は、AI技術の効果的な統合が米国の国家安全保障能力にとって重要だと主張しています。その根拠として、米政府説明責任局(GAO)が数年前、AI技術を導入して適切に統合できなければ安全保障上の支障が生じかねないと警告した事例を挙げました(参照*1)。
市場競争への影響も理由の一つです。司法省は、フェアユースに関する判断を誤ればLLM市場の健全な競争が阻害され、ライセンス料を支払える資本力を持つ最大手IT企業だけが生き残る恐れがあると指摘しました。加えて、そうしたライセンス料は、膨大な出版物を保有する一部の既存メディアへ不均衡な利益をもたらすと警鐘を鳴らしています(参照*1)。この「大手だけが残る」という論理は、小規模なAIスタートアップやメディア企業にとって現実的な問題です。私自身、Webメディアを運営する立場から見ても、ライセンスコストが特定の大企業に集中するという構図には素直に賛成しかねます。
意見書が提出されたのはニューヨーク南部地区連邦地裁です。司法省は、世界的なAIの利活用や手続きの標準を担う、強固で競争力ある人工知能産業の発展に米国は強い関心を寄せていると述べ、OpenAIに有利な司法判断こそが米国のイノベーションや安全保障能力を高めると結論づけました(参照*4)。
争点を3つに分ける
入力としての学習
入力段階における論点は、学習目的で作品のコピーが作成される行為をどのように法的に評価するかという点です。
司法省の見解では、訓練プロセスそれ自体は公衆へ著作物を開示するものではありません。保護対象である著作物を複製し、LLMにデータ間の関係性を学習させて新たな情報に適応させる内部処理にすぎない、と説明されています(参照*1)。
一方で米国著作権局は、複製の発生は一度きりにとどまらないと指摘しています。同局の報告書によれば、データの収集や整理の段階において、著作物のダウンロードや記憶媒体間の転送、フォーマット変換、改変版の作成、絞り込んだサブセットへの組み込みなどを通じ、多数の複製物が作られます。さらに学習段階でもデータセットが高性能ストレージへ転送され、作品全体やその本質的部分が一時的に複製されたうえでモデルに提示されるのです(参照*5)。
このように同じAI学習という行為を巡っても、公衆に直接提示されるか否かを重視する立場と、制作プロセスで幾重にも生じる複製に着目する立場とが対立しています。私はこの争点を整理するとき、AIに記事の下書きを作らせる自分自身の業務を重ねて考えます。学習という行為が内部処理にすぎないとしても、その処理が繰り返しコピーを作る実態を持つなら、「公衆への提示がない」という論拠だけでは説得力に限界があると感じます。
出力としての再現
出力段階における論点は、学習データをモデルがそのまま再現して出力してしまう可能性をどう捉えるかです。
米国著作権局は、生成AIモデルが学習データをそのまま記憶してしまう現象を指摘しています。モデルが学習データを逐語的、あるいは実質的に類似した形で出力できるなら、その表現はモデルの重み(パラメータ)の中に何らかの形で保持されているはずだという解釈です。そのため、重みデータが保護対象の表現を保持している場合、その重みを複製する行為自体が複製権や翻案権などの侵害に関わる可能性があると警鐘を鳴らしています(参照*5)。
司法省も、出力段階で権利侵害などの問題が生じうる可能性自体は否定していません。意見書では、訓練段階ではなく出力段階において、LLMが著作権で保護された原著作物をそのまま再構成して頒布する場合、その利用は変形性を欠く可能性があると認めました。しかし利用ごとの分析によれば、言語パターンを理解し入力に応じて予測を行うツールの開発自体と、人がそのツールを仮に、または異常な形で利用して特定の出力を生成する行為とは厳密に区別されるべきだと論じています(参照*1)。
市場代替と市場希薄化
3つ目の争点は、AIの利用が原著作物の市場にどのような影響を及ぼすかという評価の相違です。私はこれが今回の3争点の中で最も実務に直結すると見ています。コンテンツを作り、メディアで収益を得ている立場からすると、「直接の代替物かどうか」という問いは、自分の仕事の価値を守れるかどうかに直結するからです。
司法省は、市場への影響についてかなり厳格な基準を適用しています。意見書によると、市場への悪影響を法的に認めるには、AIの利用が原著作物の直接の代替物として機能していなければならないとされました。単に売上の一部を損なう恐れがあるという程度ではなく、通常の競合関係を超えた「重大な代替的競争」が生じているかどうかが肝心だという論理です(参照*1)。
これに対置されるのが「市場の希薄化(ダイリューション)」という懸念です。米国著作権局は、AIの出力が既存の特定著作物と実質的に類似していなくても、学習データと同種の作品市場で直接競合し、市場全体を希薄化させる恐れがあると指摘しています。AIによる大量かつ高速なコンテンツ生成により、同種の著作物市場が希薄化する重大なリスクがあるとしています(参照*5)。この「希薄化」という概念は、SEO記事やコタツ記事を量産する業者が増えた際にコンテンツ市場全体の質が下がった現象と構造的に似ています。特定の記事が盗まれるのではなく、市場そのものが薄まるという問題です。
この論点は法廷でも実際に議論されています。Metaをめぐる訴訟においてヴィンセント・チャブリ判事は、AIモデルの出力が学習元となった作品カテゴリー全体と一般的に競合関係に立つ場合、モデルが市場の希薄化を招いていると主張する余地があるとの判断を示しました(参照*6)。
地方紙と著者側の反論
新聞社が問題にしていること
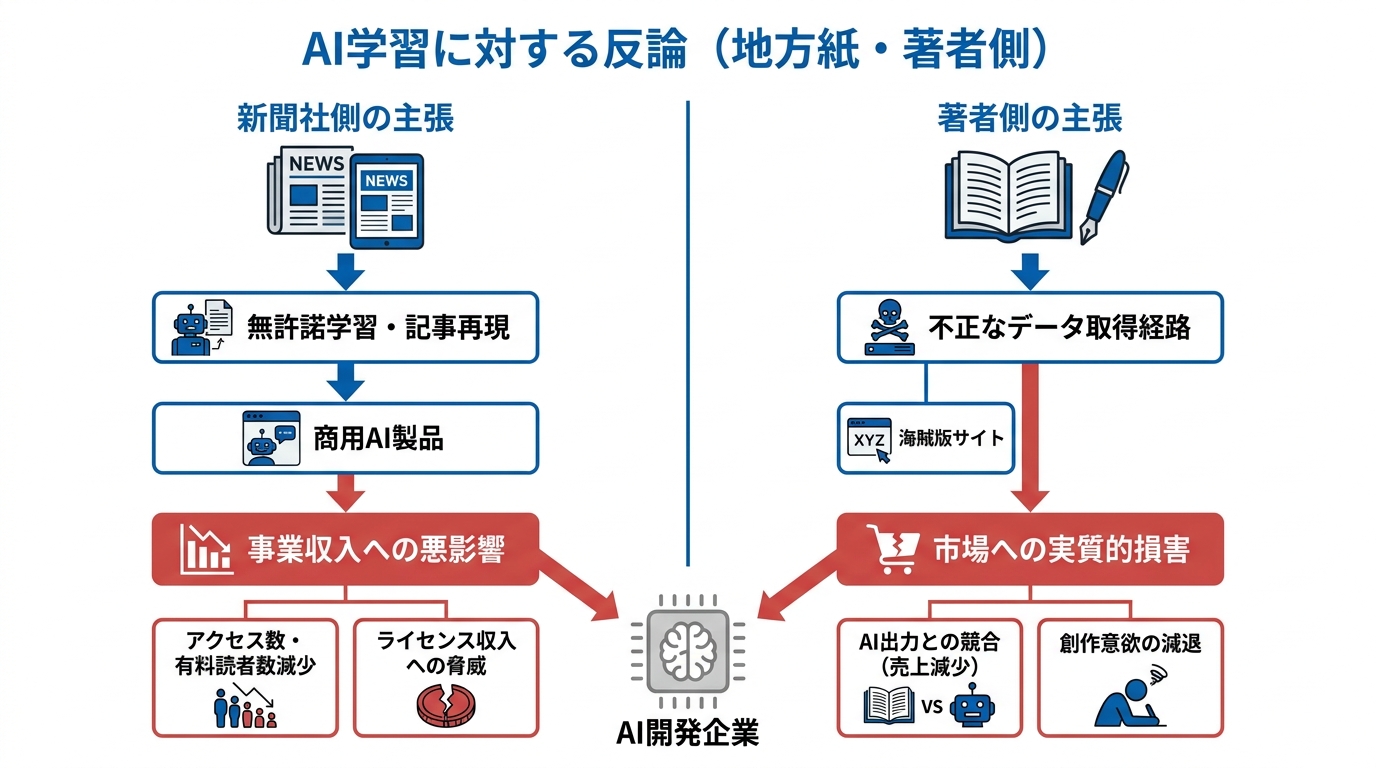
新聞社側が問題視しているのは、単なる学習行為そのものというより、記事を再現できる製品化とそれに伴う事業収入への悪影響です。
Seattle TimesとNewsdayの両紙は、自社の著作物である報道記事を無許諾でAIモデルの学習に使用したとして、OpenAIとMicrosoftを提訴しました。ニューヨーク連邦地裁への訴状において両紙は、有料購読者限定の記事を含む可能性のある報道内容を無断複製し、ニュース記事を再現・要約可能な商用AI製品を開発したと主張しています。この不当な利用によって自社サイトのアクセス数や有料読者数、正規のライセンス収入が脅かされている、というのが提訴の趣旨です(参照*7)。
ニューヨーク・タイムズも強く反論しています。同紙広報のグラハム・ジェームズ氏はメール声明において、AI技術とクリエイターは本来共存共栄できるはずだと表明しました。そのうえで、AI開発企業は著作権法の理念に則り、自社製品の基盤となるコンテンツに対して公正な対価を支払うべきなのだと主張しています(参照*8)。
著者側が示した証拠と主張
作家などの著者側も、学習データの入手経路と市場への実質的損害を根拠に、フェアユースの成立を真っ向から否定しています。この主張で注目すべきは、「何が盗まれたか」より「どこから持ってきたか」が争点になっている点です。
作家団体が提出した申立書は、まず学習データの取得ルートを問題視しました。OpenAIが、米通商代表部(USTR)から海賊版等の「悪名高い市場」に指定されているLibGenなどのサイトから、原告の著作物を含む書籍群をダウンロードしたと主張しています(参照*9)。
市場への損害についても具体的に提示されました。申立書は最大の被害として「市場希薄化の損害」を掲げ、OpenAIやMicrosoftのGPT搭載製品による出力が、学習元の書籍と売上を奪い合う競合関係になると指摘しています。
さらに、そうしたAI生成コンテンツが本来の売上を奪うことで、作家の創作へのインセンティブを減少させると警告しました(参照*9)。なお、これらは訴訟における原告側の主張であり、裁判所の確定判断ではありません。
ライセンスと破棄が同時に走る現実
買う側と破棄を求める側
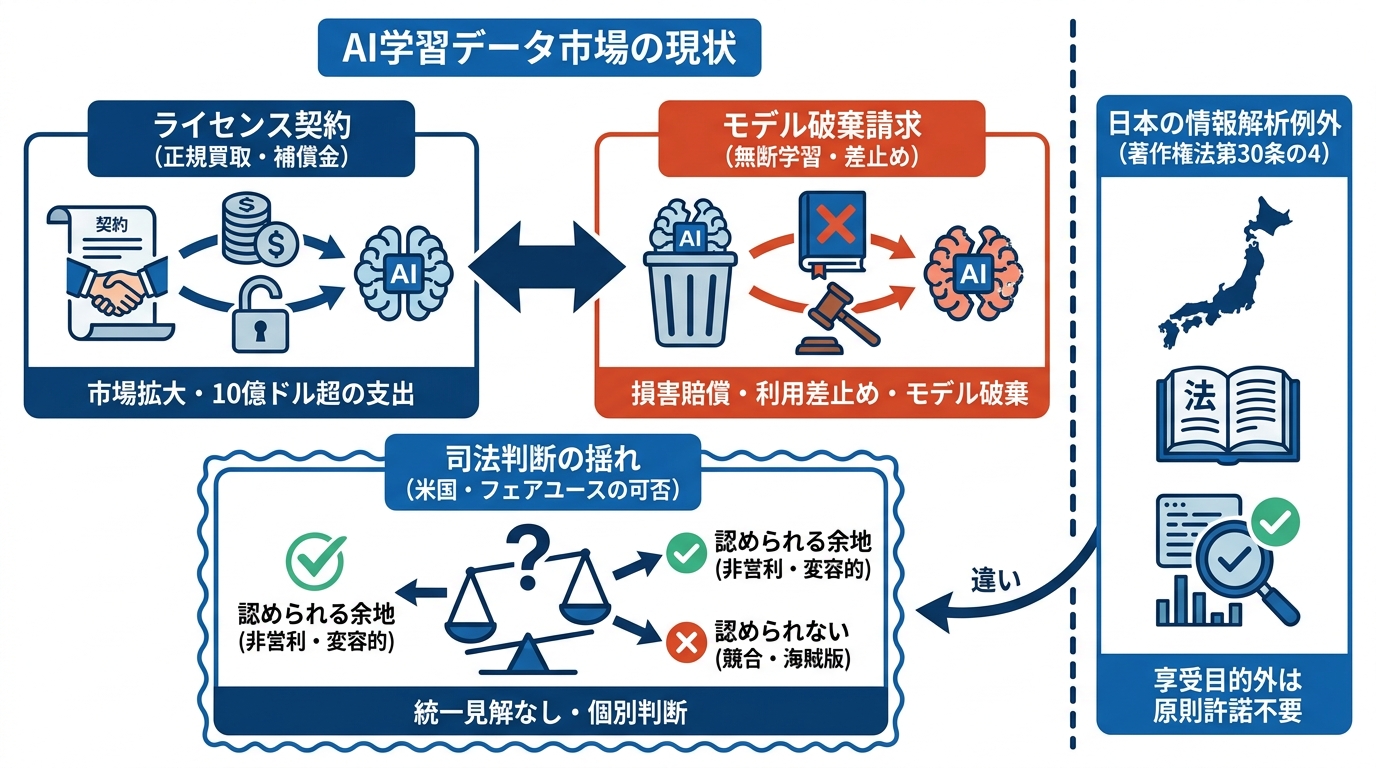
現在の市場では、正規に学習データを買い取る動きと、無断学習されたモデル自体の破棄を迫る動きとが併走しています。
作家団体の申立書によれば、LLMの学習に供する著作物のライセンス市場はすでに確立し、急速に拡大しています。公表済みの契約だけでも、コンテンツホルダーとAI企業の間で既に120件を超えるライセンスが締結されているとのことです。業界全体を見ても、AI企業は書籍等の利用ライセンスを結んだり過去の学習利用に対する補償金を支払ったりしており、その支出総額は10億ドルを遥かに超えると指摘されています(参照*9)。
権利者側が求めている救済措置は、金銭補償だけにとどまりません。ニューヨーク・タイムズは損害賠償金の支払いに加え、自社のコンテンツを用いた学習の差止め命令や、自社記事を学習させて構築された既存モデルそのものの破棄を裁判所に請求しています(参照*2)。
判断が割れている司法の現状
米国の裁判所における司法判断は決して一様ではなく、確立された統一見解はまだ存在しません。私がこの状況を見て思うのは、「判例がない」という事実そのものが、現時点でコンテンツを作る側にとっての最大のリスクだということです。
Thomson Reuters v. Ross Intelligence訴訟において、デラウェア州連邦地裁は、Ross社がWestlawの要約文(ヘッドノート)を自社AI法務検索ツールの学習に利用した行為について、フェアユースには該当しないと判示しました。この判断は、状況次第ではAI学習であってもフェアユースが認められないことを示す重要な先行事例となっています(参照*7)。
学習データの入手経路によって司法判断が分かれた事例も存在します。Bartz v. Anthropic訴訟(カリフォルニア州北部地区、2025年6月)において裁判所は、合法的に取得された書籍データによるLLM学習を「極めて変容的な」フェアユースと認定しました。その一方で、海賊版データを利用した学習については、たとえ最終的な利用に変容性があったとしてもフェアユースには当たらないと結論づけています(参照*10)。つまり現時点では、「何を学習させたか」よりも「どこから取ってきたか」が法的評価の分岐点になりうるということです。
米国著作権局もまた、個々の事案に応じた個別判断が必要だとの見解を示しています。同局は、非営利の研究・分析を目的とし、出力物に作品の一部が複製されない利用であればフェアユースと認められる余地があるとする一方、違法コピー源から創作的表現を複製したり、合理的にライセンスを利用できる状況で市場競合を生むコンテンツを無制限に生成したりする利用は、フェアユースと認められる可能性が低いと分析しました(参照*5)。
日本の情報解析例外との違い
日本の著作権法には、米国のフェアユース規定とは異なり、権利者の許諾なく「享受を目的としない利用」を認める明確な条文が存在します。日本でAI活用の議論をしていると、この第30条の4を根拠に「日本では何でも学習に使える」と単純化して語られる場面に遭遇します。しかし実際の解釈はそう単純ではありません。
米国著作権局の報告書でも、日本の著作権法第30条の4が言及されています。同条は、著作物に表現された思想や感情の享受を目的としない利用行為を、原則として許諾なく行えるものと定めています。文化庁等の議論の整理において「享受」とは、著作物を鑑賞・利用することで人の知的・感情的欲求を満たす利益を得ることを指すと説明されています(参照*5)。
ただし、この例外規定の適用には明確な境界線があります。同報告書は、原著作物と類似した表現を意図して生成させる行為は享受目的に該当する可能性があり、利用目的の一部にでも享受が含まれる場合は第30条の4の例外は適用されない、と解説しました(参照*5)。このように明文規定を置く日本の法体系は、事案ごとの総合考慮で決まる米国のフェアユース法理とは異なるアプローチといえます。
おわりに
AIによる学習は単なる著作物の複製なのか、それとも新たな創作へと至る変換なのか。この根源的な問いに対し、米司法省はいち早く、著作権で保護された資料を用いたAIモデルの学習それ自体は著作権法に違反しないとする明確な見解を示しました。しかし、これは行政機関の意見書であり、裁判所を拘束する判決ではありません。私がこの問題で繰り返し確認したいのは、「合法と言ったのは誰か」という一点です。司法省の意見書を判決と読み違えたまま「学習は合法」と断言するのは、事実の誤読です。
今後の議論を読み解く上では、データ複製を巡る入力、表現の逐語的再現を巡る出力、そして同種作品との競合を巡る市場代替という3視点に分けて考察することが有益です。作家団体の申立書によれば、120件を超えるライセンス契約が進む一方、司法の場ではモデル破棄まで請求されています。明確な法的ルールが確立せぬまま、AIモデルは今この瞬間も市場を動かし続けています。コンテンツを作る側、メディアを運営する側としては、判決が出るまで待つという選択肢はなく、現時点での法的リスクを自分の判断で織り込みながら動くしかないというのが、私の正直な認識です。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) https://copyrightalliance.org/wp-content/uploads/2026/09/2026-09-01-Letter-dckt-1682_0.pdf
- (*2) Justice Department Files Landmark Statement of Interest Arguing AI Training on Copyrighted Works Is Fair Use
- (*3) Is AI Training Legally Permitted Without Paying Copyright Royalties?
- (*4) Trump Administration Backs OpenAI in NY Times Copyright Suit
- (*5) https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-3-Generative-AI-Training-Report-Pre-Publication-Version.pdf
- (*6) CMU | the music business explained – Donald Trump’s DoJ says OpenAI should be able to do whatever it wants with copyright protected works
- (*7) Built In – AI and Copyright Law: What We Know
- (*8) ABC News – Trump administration backs OpenAI in New York Times' copyright case over training of chatbots
- (*9) https://authorsguild.org/app/uploads/2026/09/2026-09-05-Redaction-dckt-1881_0.pdf
- (*10) CASRAI – AI Training Data: Provenance, Copyright & TDM