この記事のまとめ
Cloudflareは、検索のためのクロールを許可したまま、同一クローラーによるAI学習のみを拒否できる設定を発表しました。従来は兼用クローラーを拒否すると検索結果からも消える恐れがありましたが、両者を切り分けて選択可能です。本記事では仕組みや背景、検索大手3社の対応、推奨設定、運営者が押さえるべき点について解説します。
- Cloudflareの「AI学習の不許可」は、robots.txtに学習拒否ルールを公開し、対応クローラーは検索用クロールのみを継続します。
- AppleとGoogleの兼用クローラーは対応済みで、Microsoftのrobots.txt対応は2027年初頭が目標です。
- 広告掲載サイトには、検索許可、AI学習不許可、広告ページでのAIエージェント遮断という設定が推奨されています。
- robots.txtは紳士協定に基づく任意の仕組みであり、従わないクローラーも存在します。
検索許可・学習拒否を分ける設定
AI学習の不許可という選択肢
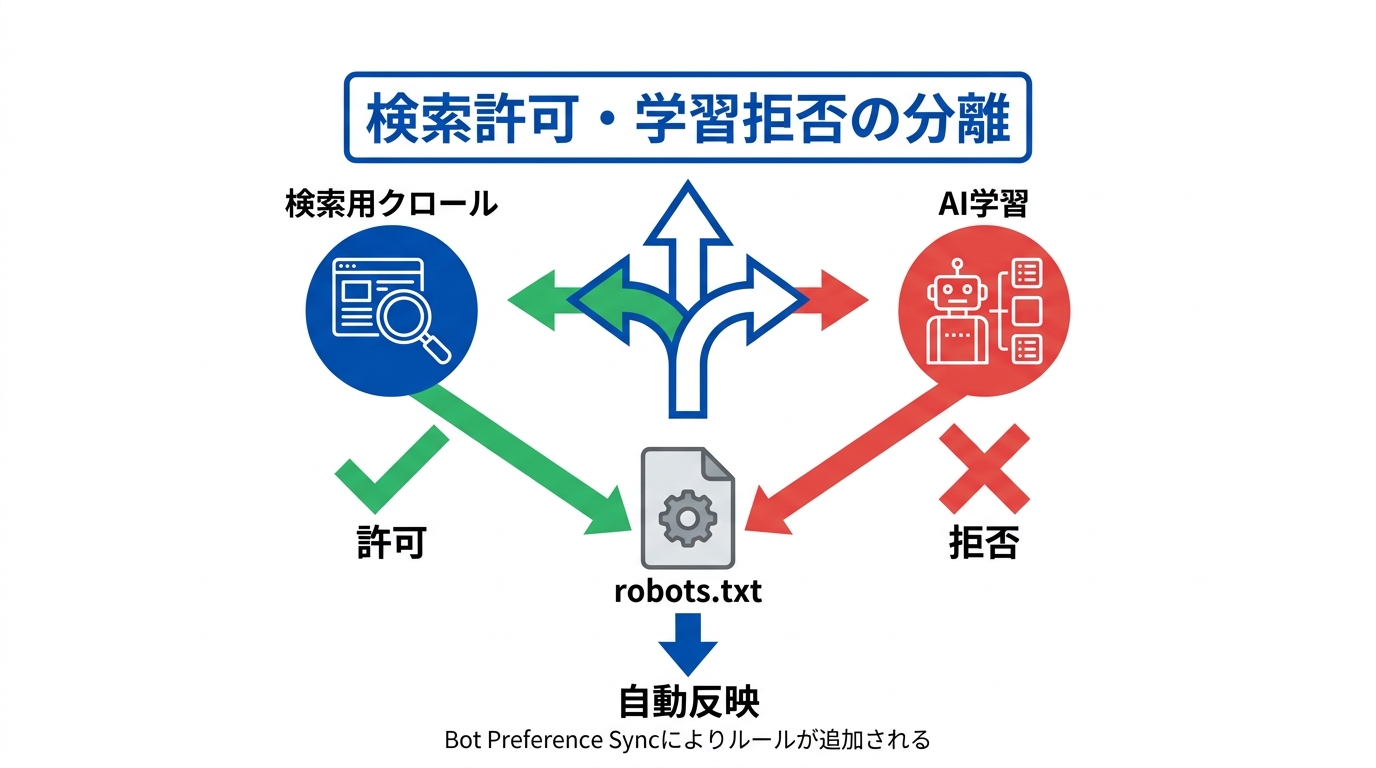
検索流入を維持したまま、AI学習だけを拒否できる設定が利用可能になりました。Cloudflareは9月15日(現地時間)、同社サービスを利用するWebサイト運営者向けに、検索用クロールは許可しつつ、同一クローラーによるAI学習のみを拒否できる新設定「AI学習の不許可」(Disallow AI Training)を発表しました。私がこのニュースを見たとき、「ようやく、というか遅かった」という印象を持ちました。メディア運営者として、この問題はずっと気になっていたからです。
本設定は全プランのユーザーが利用可能です(参照*1)。これにより、検索結果への掲載とAI学習へのデータ提供を、個別に管理できるようになりました。
robots.txtへの反映の流れ
設定を有効にした後、具体的にどのような処理が行われるのかを整理します。
ダッシュボードで選択するだけで、robots.txtに学習を拒絶する記述が追加されます。「AI学習の不許可」を有効にすると、Cloudflareがサイトのrobots.txtに学習を認めないルールを自動記載します。これに対応した兼用クローラーは、検索インデックス作成のためのクロールは継続し、AI学習へのデータ利用のみを取りやめます(参照*1)。
この反映を担う機能がBot Preference Syncです。Cloudflareの解説によると、Bot Preference Syncが該当する学習拒否設定をrobots.txtへ公開することで、信頼のおける混合用途クローラーの検索用途クロールを維持します。
一方、それ以外の学習クローラーは遮断され、ここにはAmazon、Anthropic、Meta、OpenAIなどの学習専用クローラーも含まれます。これらをブロックしても検索には影響しないとされています(参照*2)。
許可・拒否・ブロックの違い
名称が似ている各設定の違いについて、役割ごとに整理します。
学習、検索、エージェントに関する制御は、ドメイン単位で適用されます。利用できる設定は3つあります(参照*2)。
- 「許可」は、他の設定やWAFルールで防がれない限り、全クローラーのアクセスを認めます。
- 「広告があるページでブロック」は、混合用途を含むクローラーを、広告配信が検知されたページ限定で遮断します。
- 「ブロック」を選ぶと、混合用途を含むすべての対象クローラーへのアクセスを完全に遮断します。
広告ページのみを対象とした学習拒否設定は存在しません。「AI学習を拒否」はrobots.txtにルールを公開して機能する仕様上、広告掲載ページだけに絞った制御を記述できないためです。
Cloudflare側で広告配信ページを検出することは可能ですが、該当URLの数が膨大かつ頻繁に変動するため、robots.txtへの網羅が困難です。そのため、広告ページ限定の「AI学習を拒否」という選択肢は用意されていません(参照*2)。
これまで選べなかった理由
兼用クローラーのジレンマ
なぜ従来は検索と学習を個別に制御できなかったのか、背景を整理します。
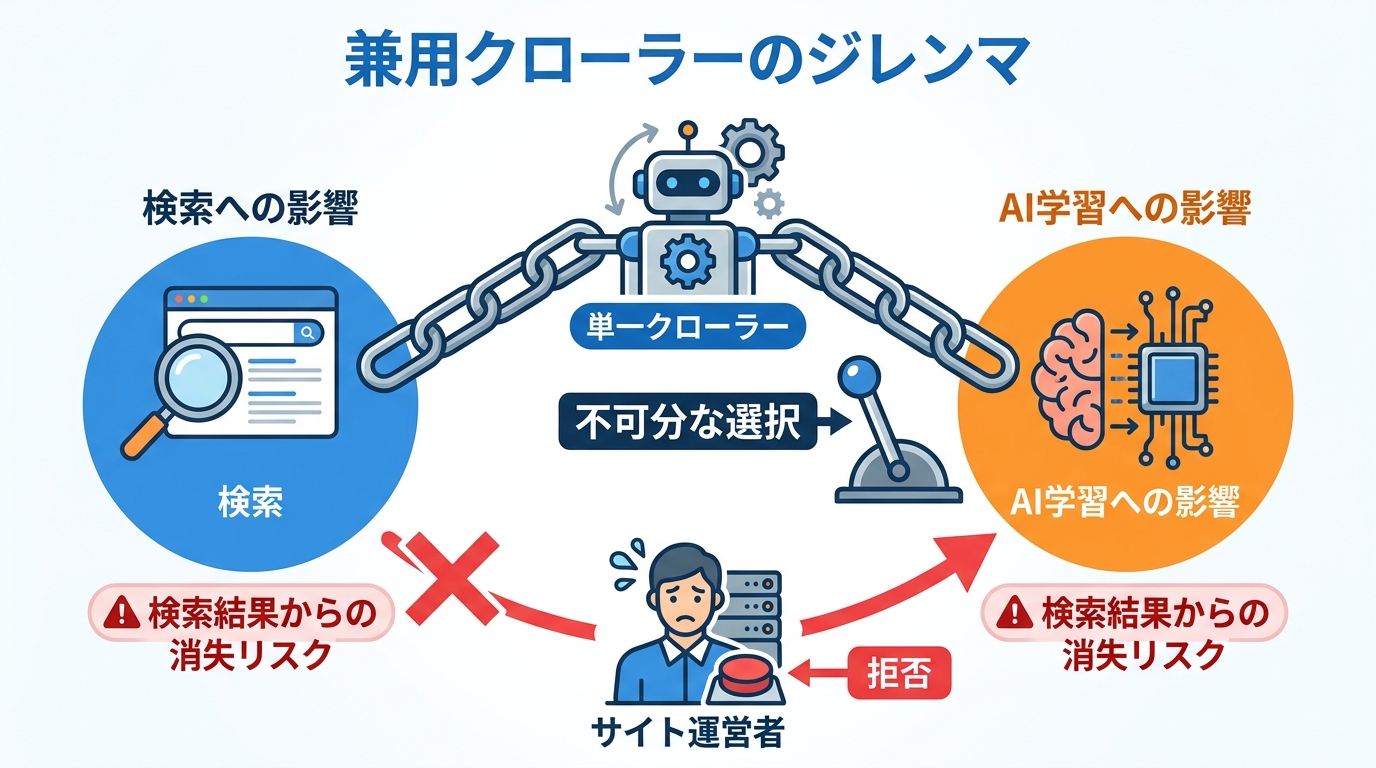
単一のクローラーが検索とAI学習の双方を担っていた点が大きな要因です。AppleやGoogle、Microsoftといった検索とAI開発の両者を手がける企業は、両方の用途を1台で兼ねる「兼用クローラー」(mixed-use crawler)を運用しています。
自サイトをAI学習に使われたくない運営者が兼用クローラーを拒否した場合、検索クローラーまで同時に拒否することになっていました。その結果、学習利用を防ぎたいだけにもかかわらず、検索結果からサイトが消失するリスクを背負わざるを得ませんでした(参照*1)。
私自身、Webメディアを運営する立場として、この「検索か学習かの二択」を迫られる構造は理不尽だと感じていました。自分たちが積み上げてきた記事を、一方的にAIの学習データとして使われることへの違和感はあります。しかし、それを拒否するだけで検索流入が消えるリスクを負うのでは、現実的な選択肢になりえません。今回の仕組みは、その不均衡をようやく解消する一歩だと思っています。
クローラー流量と拒否状況のデータ
実際にどれほどの通信量と拒否が存在しているのか、統計データで確認します。数字を見ると、問題の構造が見えやすくなります。
兼用クローラーは、観測されるボットトラフィックの中で最大の割合を占めています。検索インデックス作成とAI学習の両目的で収集を行う複合用途クローラーは、Cloudflareネットワークで確認されたクローラートラフィックの36.6%に達し、最大の区分となっています。多くのサイト運営者は検索流入を重視しており、検索クローラーを遮断している割合は1%未満にとどまります。
対照的に、17%のサイトがAI学習の制限を行っています(参照*3)。これらはCloudflareの観測データに基づく数値です。
検索大手三社の対応状況
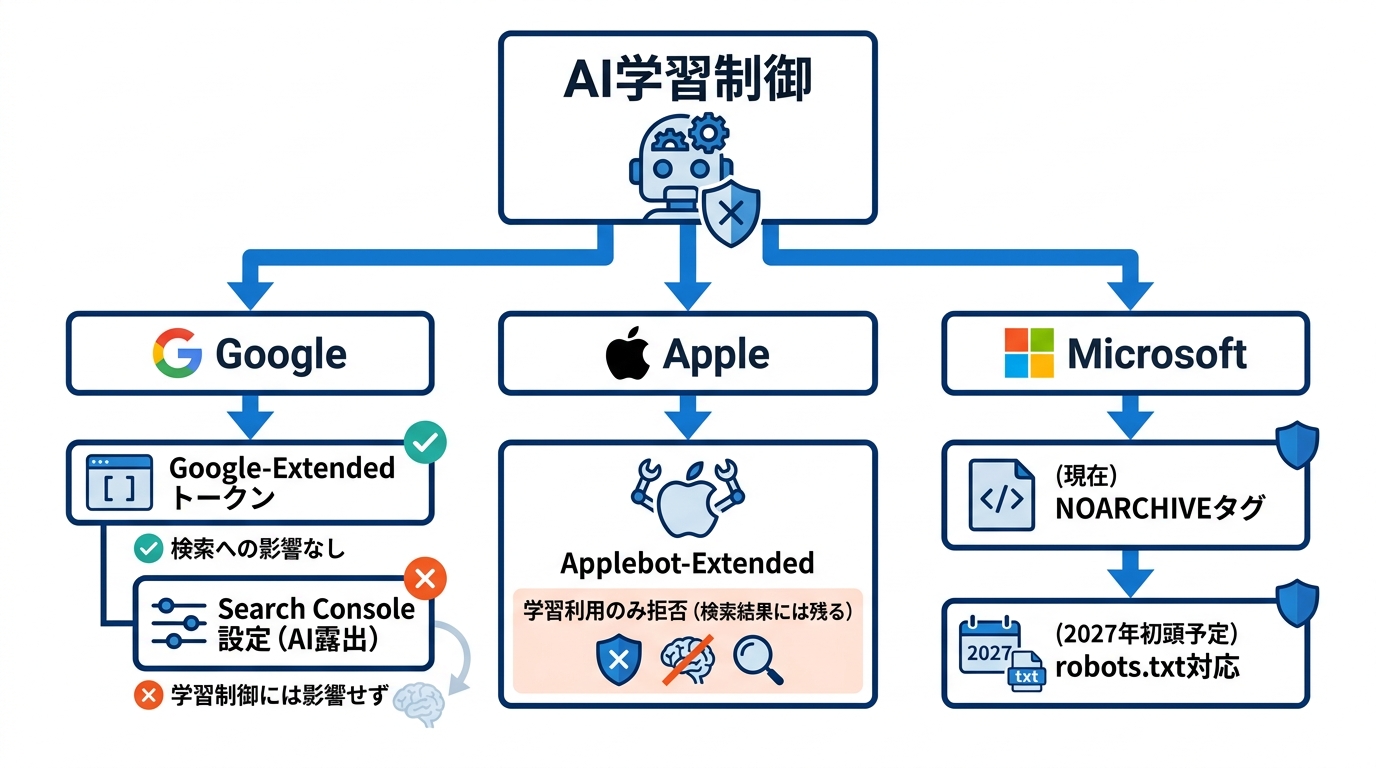
GoogleとGoogle-Extended
Googleでは、専用トークンを用いて学習利用の可否を制御できます。
Google-Extendedは、クロールしたコンテンツをGemini AppsやVertex AI API for Gemini向け次世代モデルの学習、およびGemini AppsやVertex AIのGrounding with Google Searchのグラウンディングに利用することを管理するための独立トークンです。グラウンディングとは、モデル推論時に検索インデックスの情報を参照させ、事実性や関連性を高める技術を指します。Googleは本トークンの利用について、Google検索の掲載可否や検索ランキングの評価指標には影響しないと明言しています(参照*4)。
AI Overviewsなどへの表示制御は、また別の設定項目です。AI OverviewsやAI Mode、DiscoverといったGoogle生成AI機能へのサイト露出は、Search Console内の個別設定で管理されます。Googleの公式ヘルプによると、その露出設定を変更してもAI学習の制御には波及しないとされています(参照*5)。
AppleとApplebot-Extended
Appleも、学習利用のみを明示的に拒絶する仕組みを用意しています。
Applebot-Extendedを利用すると、Webサイトの運営者は、Apple IntelligenceやApple各種サービス、Apple Developer Toolsなど、製品群全体の生成AIを支える基盤モデルの学習に自社コンテンツが使用されるのを防げます(参照*6)。
このトークン自体が独立してWeb巡回を行うわけではありません。Applebot-Extendedは自らページをクロールしません。
そのため、本設定で学習を不許可にしたページであっても、引き続き検索結果に含めることができます。Applebot-Extendedは、通常のApplebotが収集したデータの利用範囲を規定する目的に限定して機能します(参照*6)。
MicrosoftとNOARCHIVE
Microsoftに関しては、現行の運用と将来のロードマップが分かれています。
Bingにおいては当面の間、HTMLタグ側での指定が必要です。AppleやGoogleの兼用クローラーがすでに対応しているのに対し、Microsoftの対応完了は2027年初頭を見込んでいます。それまでの間Bingによる学習利用を防ぐには、HTML内に「NOARCHIVE」メタタグを埋め込むなどの個別措置が求められます(参照*1)。
Cloudflareも同様の見解を示しています。BingbotはWebmaster Toolsで詳細な制御と透明性を提供しており、サイト管理者は現在、BingのNOARCHIVEメタタグを通じて学習拒否の意志を提示できます。
Microsoftは機能拡張を進めており、robots.txtによるドメイン単位の「学習拒否」を尊重するシステムを開発中です。運用の開始時期は2027年初頭を予定しています(参照*2)。
説明責任ある事業者の基準
どのクローラーを信頼できる事業者と位置づけるのか、判断基準を確認します。
事業者は、4要件を満たすか、期日内に遵守することを約束しなければなりません(参照*3)。
- robots.txt等を通じてサイト所有者にAI学習オプトアウトの明確な手段を提供すること。
- AI要約表示からのオプトアウト手段を提供すること。
- コンテンツが検索と学習にどのように利用されているかをURL単位で確認できる機能を提供すること。
- 学習を拒否しても従来の検索順位に悪影響を与えないと公式に明言すること。
CloudflareはApplebot、Googlebot、Bingbotのほか、Amazon、Anthropic、Meta、OpenAIの関連クローラーをAccountableとして認定しました。後者4社はすでに検索と学習でクローラーを分離運用しているため、検索順位に悪影響を及ぼすことなく学習クローラーのみを遮断可能です(参照*7)。
サイト種別ごとの推奨設定
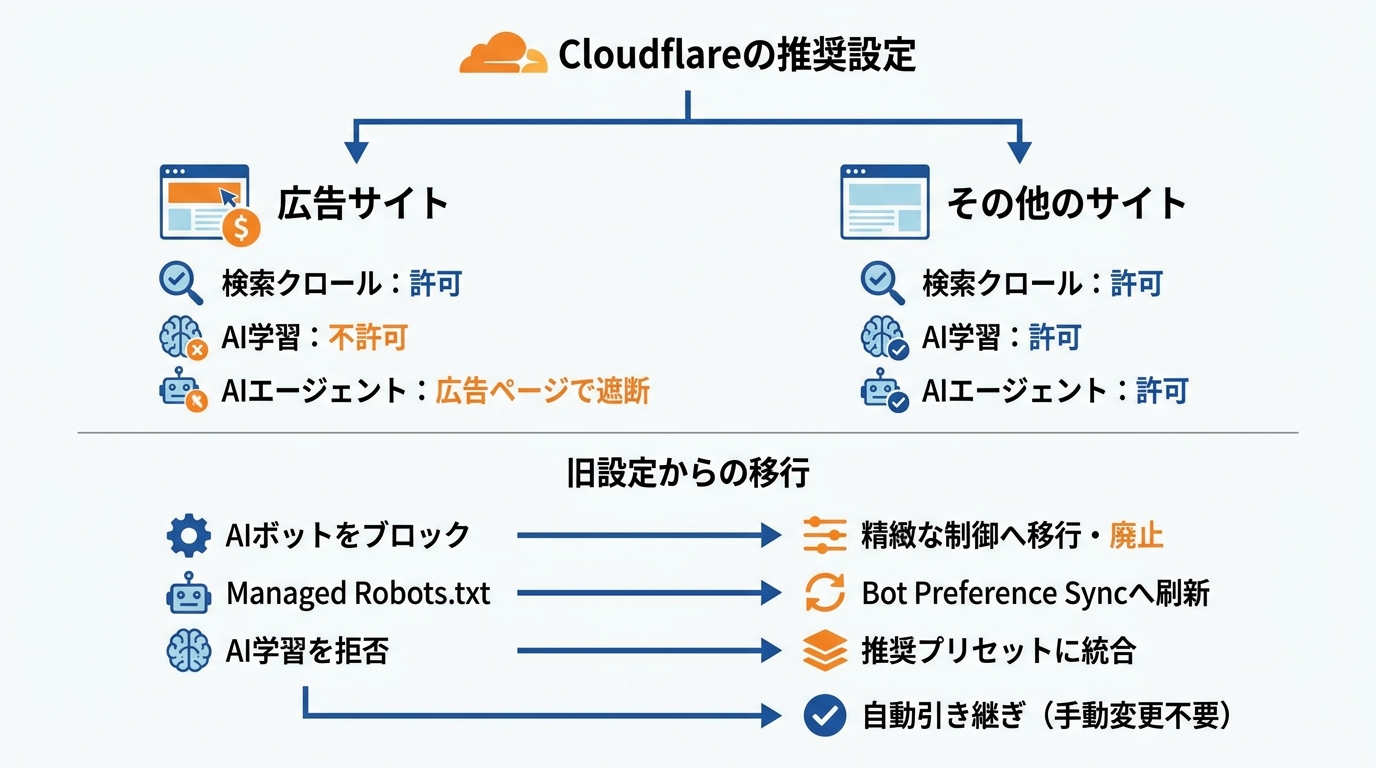
広告サイトとその他のサイト
Webサイトのビジネスモデルにより、推奨される構成は異なります。
Cloudflareは2通りの推奨設定を提示しています。広告掲載サイトに対しては、検索クロール許可、AI学習不許可、広告表示ページでのAIエージェント遮断を推奨しています。それ以外のサイト全般では、検索、AI学習、AIエージェントのすべてを許可する形です。
これは広告収益に依存しない多くのWebサイトで従来採用されてきた方針と合致すると説明されています(参照*3)。これらはあくまで目安であり、強制的な規則ではありません。
旧設定の廃止と移行
従来の制御設定は、新しい体系へ順次統合されます。
「AIボットをブロック」機能は、より精緻な検索・学習・エージェント制御へと移行し廃止されます。Managed Robots.txtもBot Preference Syncへと刷新され、従来の設定を有効にしていた利用者は新方式へ自動移行されます。「AI学習を拒否」は、特定の新設ドメインにおける推奨プリセットの一部として組み込まれます(参照*2)。
過去に設定した内容は自動的に引き継がれます。Cloudflareによると、大半の利用者は手動での変更手続きを必要としません。
学習制御でBlockまたはBlock on pages with adsを選んでいたサイトは、Disallow AI Trainingへと移行します。旧来のBlock AI Botsで遮断設定をしていたサイトは、検索がAllow、学習がDisallow AI Training、エージェントがBlock on pages with adsへ自動更新されます(参照*5)。
書き手が押さえる注意点
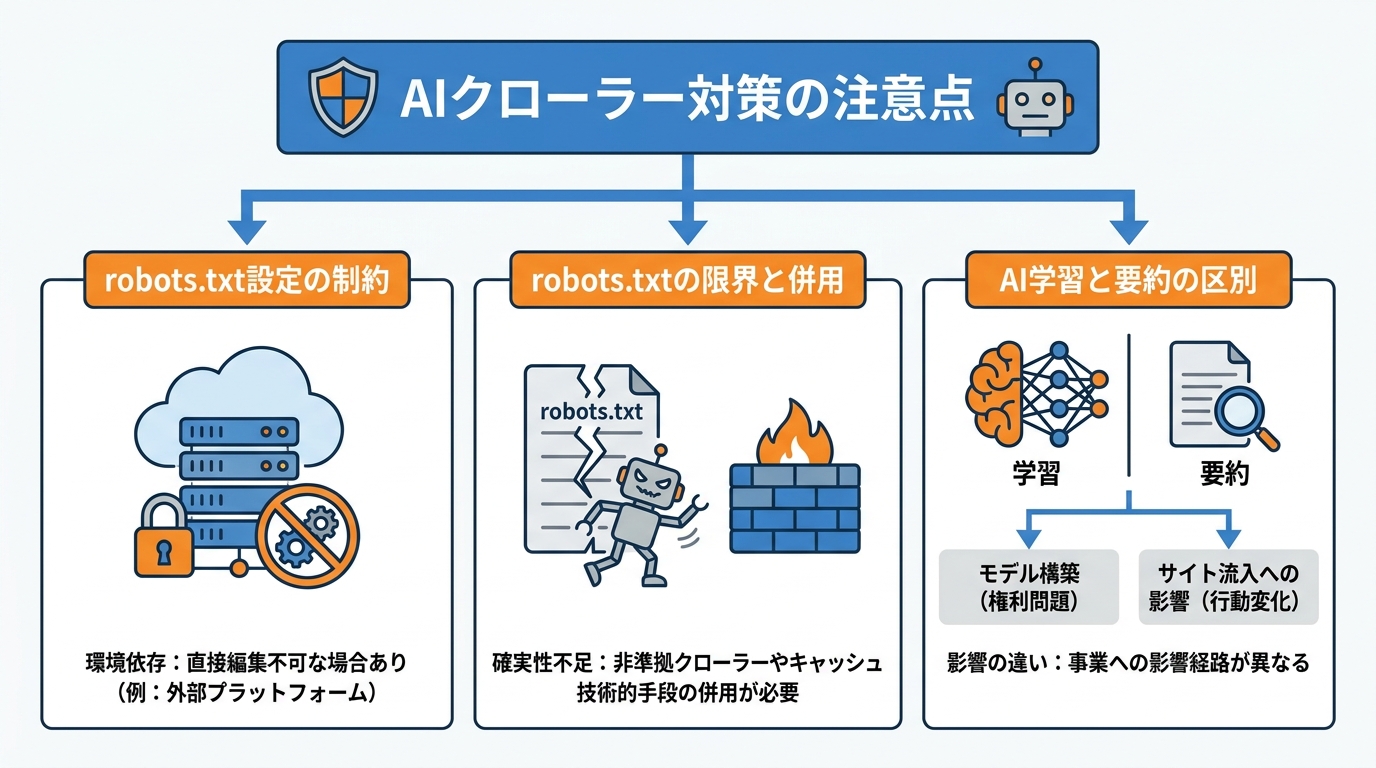
設定を自分で変えられない場合
発信者側の利用環境によっては、設定の変更自体が難しい場合があります。
robots.txtを直接編集できないホスティング環境も存在します。調査では、対象となったアーティストの大半がrobots.txtの編集に対応していない外部プラットフォームを利用していました。
調査対象の主要サービスの中でrobots.txtを直接変更できたのはWixの有料プランのみで、SquarespaceはAIクローラー禁止の選択肢を用意するにとどまりました(参照*8)。これは調査対象群のデータですが、利用中のサービスがrobots.txtのカスタマイズに対応しているかを事前に確認する必要があります。
robots.txtの限界と併用
設定ファイルを配備しても、必ず巡回が防げるわけではありません。
robots.txtはクローラー側の信頼に基づく仕組みであり、すべてのボットが準拠する保証はありません。Bytespiderのように指示に従わず巡回した事例も存在します。また、クローラーが古いrobots.txtをキャッシュしたまま、過去の記述に基づいて巡回を継続するケースも報告されています(参照*8)。
前述の調査でも、技術的手段の併用が提唱されています。AIクローラーから包括的にデータを守るには、robots.txtの宣言と能動的な遮断を組み合わせ、遮断設定が意図通り稼働しているかを確認する必要があります(参照*8)。
学習とAI要約の違い
モデルの追加学習と、検索結果での要約表示は区別して捉える必要があります。
Cloudflareは、学習利用とAI要約がサイト運営にもたらす課題は異なると指摘しています。学習は自社の文章をAIモデルの構築に用いてよいかという権利の問題です。
一方で要約は、ユーザーがサイトを認知・評価し、訪問に至るプロセスに直結します。どちらも重要ですが、事業に及ぼす影響経路は異なります(参照*2)。
要約が及ぼす行動変化の統計も公表されています。ユーザーの半数以上が検索結果の要約を閲覧しており、要約を読んだ層はサイトを訪れず検索を終了する確率が40%以上高まります。閲覧流入の減少を招く懸念がある一方、AI検索経由で流入した訪問者の成約率は、従来検索の3倍から5倍以上というデータも示されています(参照*2)。私はこの数字を、単純にポジティブとは受け取っていません。流入量が減っても成約率が上がるのは、ある意味で「量から質へ」の移行ですが、そもそも認知の入口が狭まれば、成約の絶対数は落ちる可能性があります。AIO/GEO(AI検索最適化)の文脈で引用率やブランド言及を測ることが重要になるのは、まさにこの構造変化があるからです。
おわりに
「検索にヒットすること」と「AIの学習データに使われること」は、長らく単一のクローラー内で不可分に結びついていました。Cloudflareの「AI学習の不許可」によって、検索流入を維持しながら学習のみを拒否する柔軟な制御が現実のものとなっています。私たちのようにコンテンツを積み上げてきたメディア運営者にとって、これは選択肢が増えたという意味で、素直に前進だと受け止めています。
AppleやGoogleの兼用クローラーは対応を完了しており、Microsoftもrobots.txtによる学習拒否を尊重する枠組みを2027年初頭に向けて構築中です。ただし、robots.txtはあくまで紳士協定であり、すべてのクローラーが必ず従うわけではない点は忘れないようにする必要があります。広告運用の有無など自サイトの特性を踏まえ、何を許容し何を制限するのか、Cloudflareのダッシュボードを一度開いて現状の設定を確認してみることをお勧めします。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Yahoo!ニュース – AI学習は拒否、検索クロールは維持……Cloudflareの新機能「AI学習の不許可」 Google、Apple、Microsoftが対応
- (*2) Cloudflare Blog – Have it both ways: stay discoverable in search while disallowing AI training
- (*3) Yahoo Finance – Cloudflare Helps End the Search-or-AI-Training Tradeoff
- (*4) Google for Developers – Google's common crawlers | Google Crawling Infrastructure | Crawling infrastructure | Google for Developers
- (*5) Search Engine Journal – Cloudflare Lets Sites Disallow AI Training Without Blocking Googlebot
- (*6) Apple Support – Apple サポート (日本)
- (*7) Techstrong.ai – Cloudflare Separates AI Training From Search With New Crawler Controls
- (*8) https://people.cs.uchicago.edu/~ravenben/publications/pdf/crawlers-imc25.pdf