この記事のまとめ
Decisions APIとJevは、どちらも長文を生成せず、あらかじめ定めた選択肢から判断結果を返す仕組みです。比較対象となるのは登場時期・出力形式・速度・料金・入力・入手性の6項目ですが、公開情報量には差があります。まずは、これら6項目の要点を整理します。
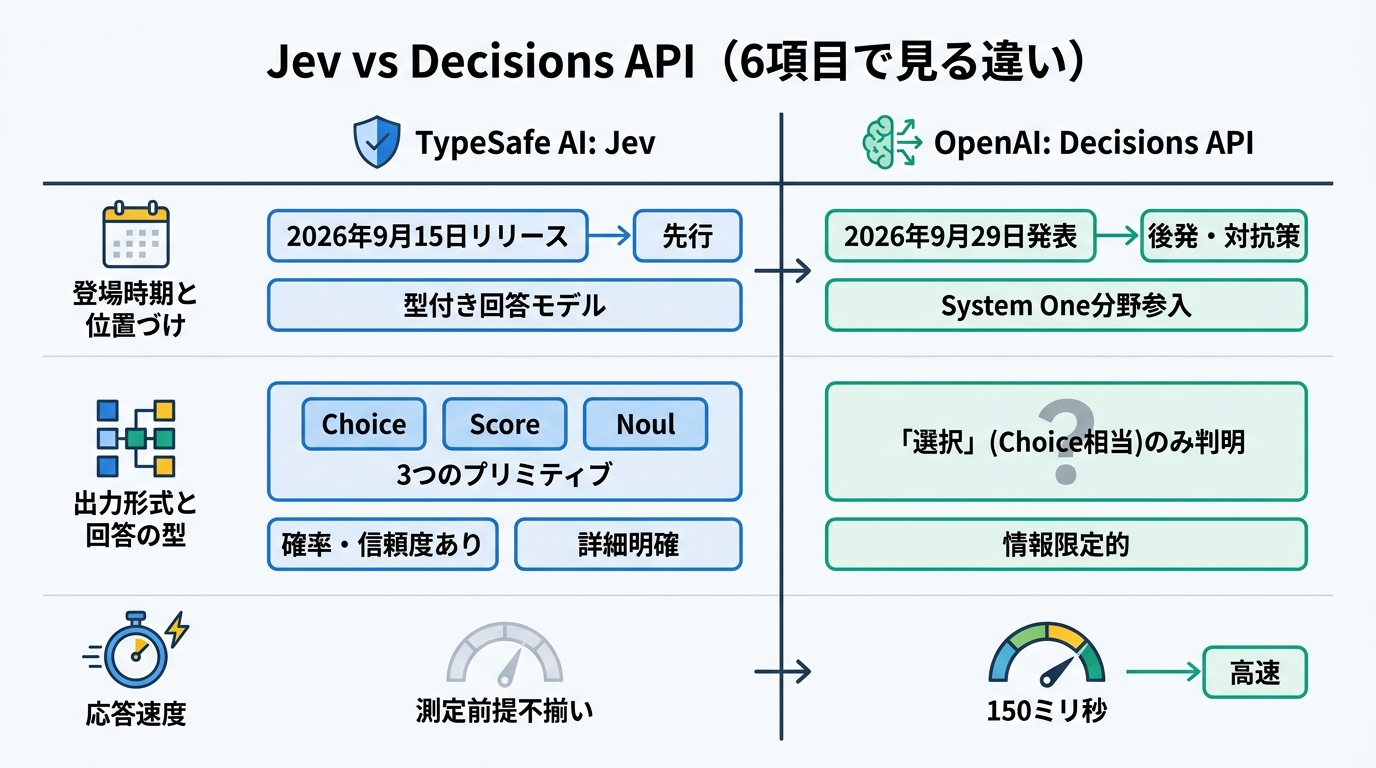
- Jevは2026年9月15日にTypeSafe AIがリリースし、OpenAIは同年9月29日のDevDayでDecisions APIを発表しました。
- JevはChoice・Score・Noulの3つの型で確率を返し、ChoiceとScoreは信頼度も返します。Decisions APIは現時点でChoiceに相当する回答のみ確認されています。
- 速度面ではDecisions APIが150ミリ秒、Jevはベンダー公表値で70〜500ミリ秒ですが、測定条件は揃っていません。
- Jevは入力100万トークンあたり0.042ドルで出力無料、Decisions APIは料金やドキュメントが未公開で、プレビューは一部顧客に限定されています。
6項目で見る違い
登場時期と位置づけ
まず、どちらが先に登場し、どのような位置づけの製品として扱われているかを整理します。登場時期を見ると、OpenAIがJevを意識して発表を急いだ可能性が高く、その経緯自体がこの市場の注目度を物語っています。
TypeSafe AIは2026年9月15日、文章ではなく型付きの回答を返すモデルJevをリリースしました(参照*1)。
OpenAIは2026年9月29日のDevDayでDecisions APIを発表しました。
質問ごとに固定した選択肢を定義し、テキストや画像で状況を渡すと、そのリストから判定結果が返る仕組みです(参照*2)。
the-decoderは、OpenAIがDecisions APIによっていわゆるSystem Oneモデルの分野へ参入したと報じています。同記事は、9月中旬にDiogo Almeida氏のスタートアップTypeSafe AIがJevを発表した点に触れ、強力なモデルを指揮役に据えつつ高速な判断モデルを組み合わせる手法は有望だとしています(参照*3)。私が注目したのは、この「指揮役と実行役の分離」という発想です。大規模モデルにすべてを任せるのではなく、判断専用モデルを挟むことで速度とコストを下げる設計は、エージェント構築の現場では非常に実用的な考え方です。
The New Stackは、Decisions APIがTypeSafeやJevへの対抗策である可能性が高く、OpenAIがDevDayに間に合わせるため発表を急いだと分析しています。同誌に対しOpenAIの広報担当者は、一般提供の開始時に詳細な情報を共有する予定だとコメントしました(参照*4)。こうした「競合への対抗で急いだ発表」は、詳細情報の欠落を生みやすい。実際、料金もドキュメントも未公開という状況は、導入を検討する現場にとって判断材料が乏しすぎます。
出力形式と回答の型
続いて、両者が返す出力形式の違いを見ていきます。
TypeSafeの公式ドキュメントでは3つのプリミティブが定義されています。Choiceはリストから1つを選定し、選択肢ごとの確率と信頼度を返します。
Scoreは順序付けられた評価基準のレベルに基づいて状態を評価し、確率と信頼度を返します。Noulは、特定の記述が真である確率を0から1の範囲で返します(参照*5)。
一方、Decisions APIに関して公開されている情報は限定的です。OpenAIによるX上の投稿では「選択」と表現され、単に回答を返すことのみが示されています。
The New Stackは事前定義された回答と信頼度スコアの存在を報じているものの、OpenAI公式はレスポンス形式やスコアの確率性、較正の有無、ScoreやNoulのような質問への対応可否を明かしていません。現時点で確認できるのはChoice相当の形式のみです(参照*2)。
応答速度
処理速度に関しては両者とも公表値が存在するものの、測定の前提条件が揃っていません。この点は見落とされがちですが、実際の業務で使えるかどうかは、カタログ値ではなく自分のワークロードで計測するまでわかりません。
The New Stackによれば、意思決定モデルは実用的な信頼度スコアを算出できるうえ、極めて高速に応答する傾向があります。OpenAIは自社モデルが150ミリ秒で結果を返すとしており、これはGPT-6 Lunaの1.6秒と比較しても大幅な高速化です(参照*4)。
Jev側はベンダー公表のレイテンシが70〜500ミリ秒とされ、OpenRouter経由での中央値は175ミリ秒と報告されています(参照*5)。
TypeSafeは応答時間を70〜500ミリ秒と公表しているものの、実際のレイテンシはリクエスト内容やワークロードに左右されます(参照*6)。いずれの数値も計測環境が同一ではないため、単純な直接比較はできません。
料金
料金体系は、比較する6項目の中で最も明確な違いが見られる要素です。現時点では、比較そのものが成立しない非対称な状況です。
2026年9月時点で、Jevの直接利用料金は入力100万トークンあたり0.042ドルであり、出力は無料に設定されています(参照*6)。
一方のDecisions APIは、価格情報が一切開示されていません。2026年9月30日時点において、OpenAIはドキュメントページやエンドポイント、料金、利用制限、SDK対応、ベンチマーク、較正に関する方針のいずれも公表していません(参照*2)。そのため料金比較は現時点で成立せず、Jev側の費用のみが確認可能な状況です。
なお、1件あたりのコストを見積もる手がかりとして、ユースケース別の実測値が参考になります。人手でラベル付けした30件のQAデータを用いた検証では、Jev 1.13.0の1,000判定あたりの推定コストは0.0247ドルでした(参照*7)。
入力できるデータ
入力として受け付けるデータ形式にも、明確な違いが存在します。
Decisions APIにおいて、OpenAIは低コストモデルであるGPT-6 Lunaの派生版を採用しています。開発者は事前定義された有限の選択肢セットを用意し、テキストまたは画像でコンテキストを与えることで回答を取得できます(参照*3)。
これに対しJevは、JSONオブジェクトやリスト形式に構造化されたテキストを含む、テキストデータのみを受け付けます。画像や音声、動画の入力には非対応で、自由文の返答やコード、解説の生成も行えません(参照*6)。画像情報を踏まえて判定させたいユースケースでは、この対応可否が選定の決め手となります。
入手性とドキュメント
最後に、現時点で実際に試用できるかどうかという入手性の違いです。
Decisions APIのプレビューアクセスは、選定された一部のAPI利用者に限定されています。OpenAIは数日以内の一般公開を予告しているものの、メディアのEveryは数週間以内の開始と予測しています。また同日現在、ドキュメントやエンドポイント、SDK対応に関する詳細も公開されていません(参照*2)。
Jevの利用開始方法としては3つの手段が案内されています(参照*6)。
- Braintrust上で利用する方法で、AIの応答検証や採点を行えるほか、TypeSafeのAPIキー連携やBraintrust経由での組み込みアクセス申請が可能です。
- TypeSafe公式サイトのウェイトリストに登録し、直接アクセスを申請する手順です。
- OpenRouterを経由し、Jev 1.13をアプリケーションに組み込んで利用する方法です。
判断専用モデルの仕組み
3つの質問タイプ
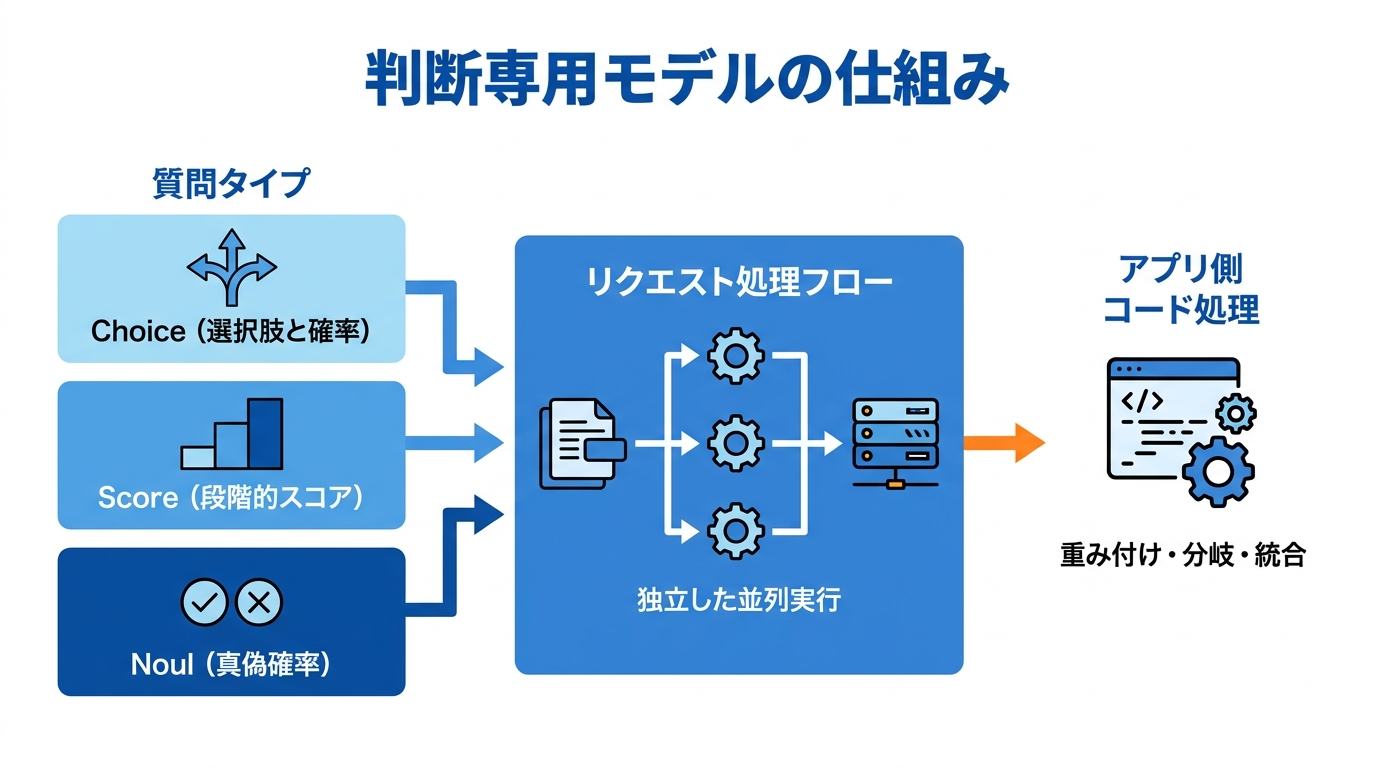
Jevが提供する質問タイプは3種類あり、入力パラメータと出力形式がそれぞれ定義されています(参照*8)。
- Choiceでは名前付きの選択肢と説明を入力することで、選定されたキーと選択肢ごとの確率、および信頼度が返されます。排他的な分類ラベルの付与や処理ルートの分岐に適した形式です。
- Scoreでは2〜10段階の昇順レベルを渡すと、確率加重されたスコアと各段階の生起確率が出力されます。重大度や品質、リスク判定の基準策定に有効です。
- Noulでは二値で回答可能な命題(必要に応じて判定基準も指定)を渡すことで、それが真である確率が返され、単一の事実確認に活用されます。
出力値の解釈には注意が必要です。チュートリアルでは「スコアは正確性を表すものではない」と明記されています。この点はAI全般に共通する話で、数字が出るほど読み手はそれを正確性の保証と錯覚しやすい。スコアが返ってくること自体に安心してしまうのが、導入初期に起きやすい誤解です。
例えば0〜2の尺度における1.5というスコアは期待水準を示すものであり、75%正しいという意味ではありません。スコアやChoiceの信頼度数値を、正確性の直接的な保証として扱わないことが推奨されています(参照*8)。
リクエストの組み立て方
リクエストの実行は、状態と質問をまとめて送信し、判定結果をアプリケーション側のコードで処理する流れとなります。
チュートリアルでは、独立した質問群を並列実行する仕組みが解説されています。同一リクエスト内の質問は同じ状態コンテキストを参照しつつ、それぞれ独立して処理されるため、ある判定結果が別の判定に影響を与えることはありません。また、複雑な業務ロジックを巨大プロンプトに内包させるのではなく、通常のコード上で型付きの出力に対して重み付けや閾値処理、分岐、統合を適用する設計が推奨されています(参照*8)。
APIエンドポイントとしてはPOST /v1/systemoneが提示されており、次のモデルを指定して実行可能です(参照*9)。
- typesafe/jev-1.13
- liquid/d1
- upstage/solar-decide
- togethercomputer/tev1-4b-experimental
- jaredpalmer/kev-4b
- laya-english
- laya-multilingual
- laya-auto
用途別の選び方
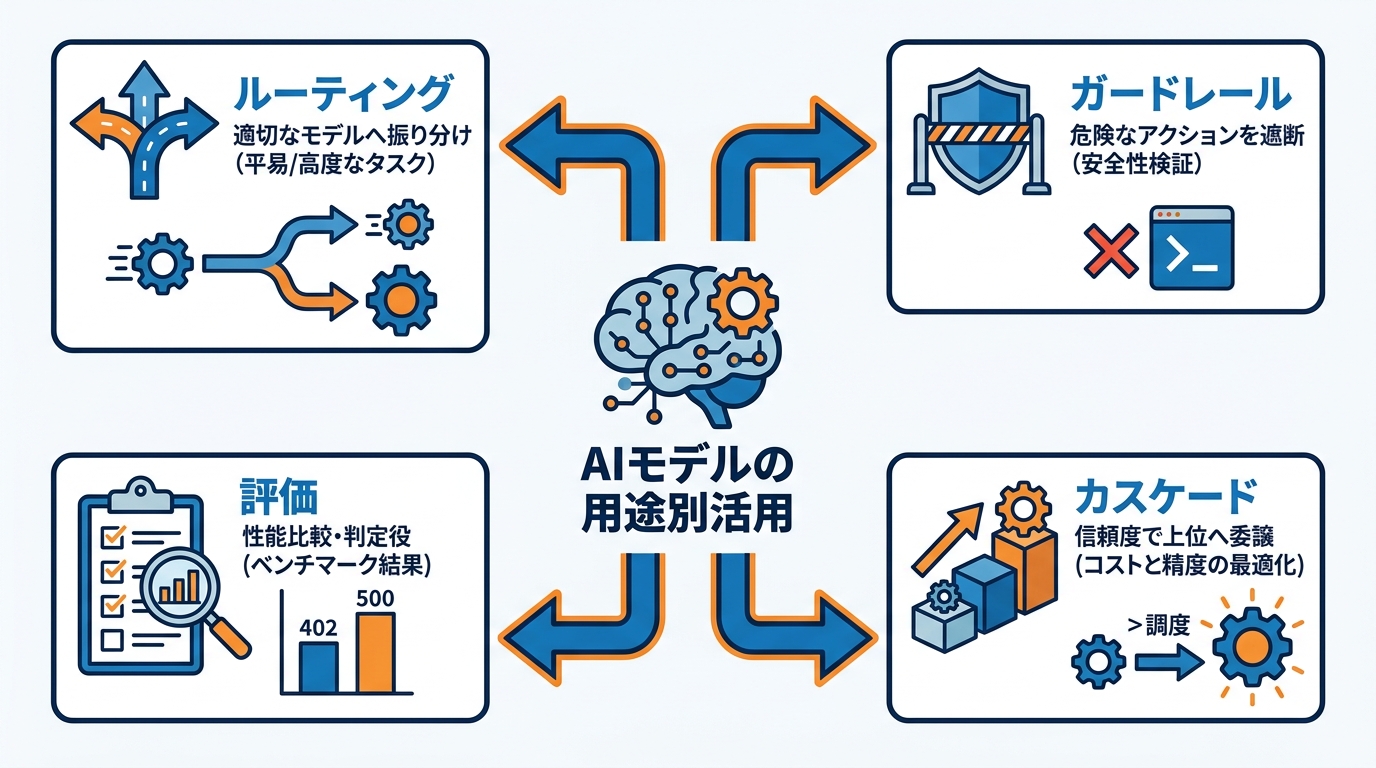
ルーティングとガードレール
エージェント構築においては、利用モデルの適切な振り分けや、危険なアクションを遮断する安全弁として活用されています。私がこのユースケースを重要だと考えるのは、エージェントの「暴走」を防ぐ仕組みをどう設計するかが、実用化の最大の壁になっているからです。
LangChain公式ブログの解説では、ルーティング用ミドルウェアを介してJevがリクエストを評価し、設定した基準に沿ってモデルを選択できるとされています。平易なタスクには高速かつ低コストなモデルを割り当て、高度な処理には高性能モデルを振り分ける運用形態です(参照*10)。
もう一つの用途はツール実行前の安全性検証です。AutoModeMiddlewareではJevを利用してツール呼び出しのリスク判定を行い、危険な操作が実行される前に処理を未然に遮断します(参照*10)。判断を下すレイヤーと実行を担うレイヤーが明確に分離されている点が特徴です。
評価とカスケード
評価判定役としてのベンチマーク結果や、信頼度に応じて上位モデルへ委譲するカスケード処理の知見も報告されています。コスト削減と精度担保を両立する設計として、実務上の参考になります。
MLflowのブログでは、人手でアノテーションされた30件のQAデータを用いて評価性能を比較検証しました。Jev 1.13.0は人手ラベルとの一致率が30/30(100%)、レイテンシ中央値369ミリ秒、p95が411ミリ秒、1,000判定あたりの推定コストは0.0247ドルを記録しました。
GPT-5.6 Terraも一致率は30/30(100%)だったものの、中央値1,091ミリ秒、p95が1,924ミリ秒、推定コストは0.8960ドルとなっています(DeepSeekのコストはオフピーク料金を適用)(参照*7)。一致率は同じでも、コストは約36倍の差があります。ただし、30件という小規模なサンプルである点は差し引いて読む必要があります。
また、モデルカスケード構成の検証も行われています。閾値0.9の設定は、1,610件の検証用データ(ホールドアウト)を評価する前に、96件のパイロット選好ペアから導出されました。
保持された出力を用いたオフラインシミュレーションでは、JEVからGPT-6へ繋ぐカスケードは正解率93.4%を達成し、GPT-6単独の92.5%を上回りました。全ペアの31.5%が上位モデルへエスカレーションされ、その中にはJEV単体の誤りの85%が含まれており、GPT-6単独運用の推定コストに対して41.4%の出費に抑えられています(参照*11)。
導入前の注意点
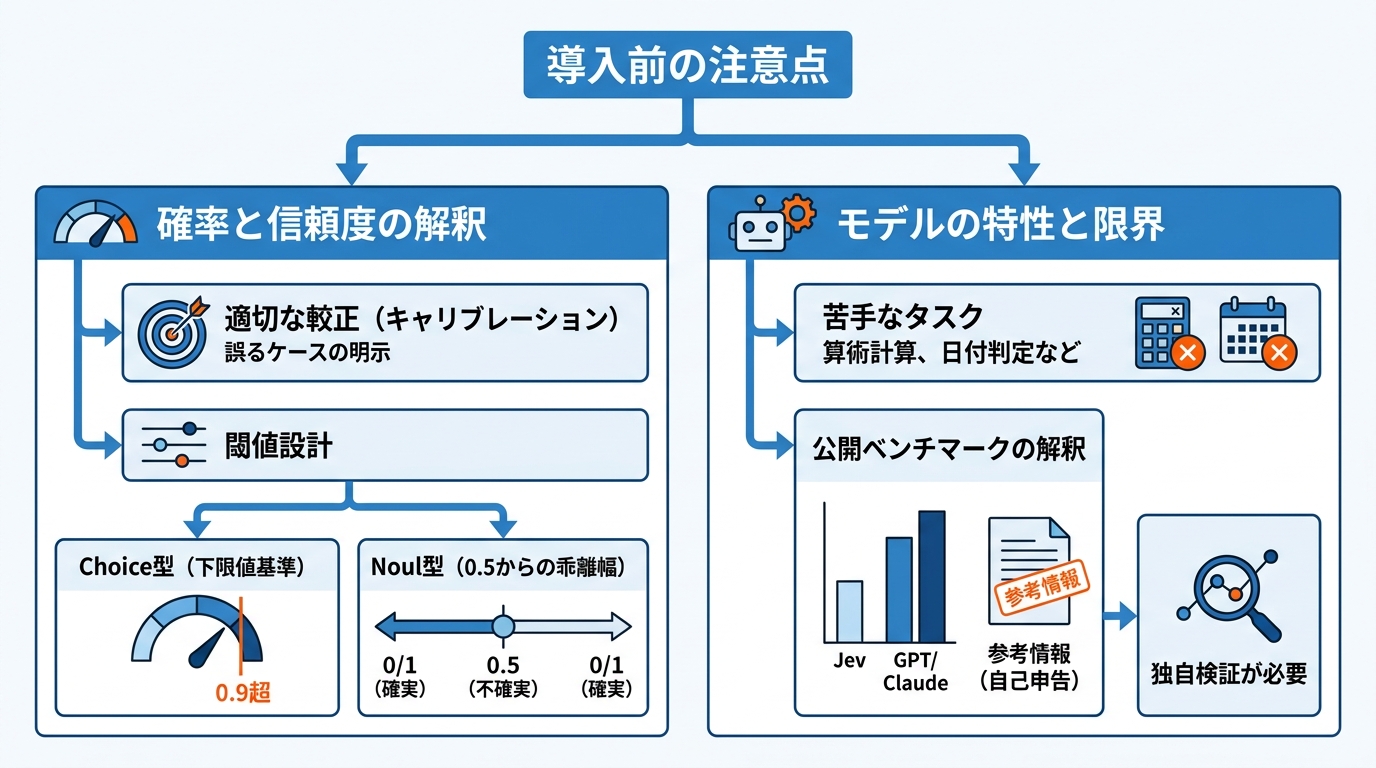
確率と信頼度の読み方
確率値の取り扱いは、運用上の閾値設計と密接に関連する重要なポイントです。ここを曖昧にしたまま導入すると、「高い確率が出たから正しい」という誤読が現場で起きやすくなります。
freeCodeCampの解説記事では、この特性を較正(キャリブレーション)と呼び、それこそがモデルの主要な狙いであると述べています。重要なのは単純な正解率ではなく適切な較正であり、「30%の確率で誤るが、どのケースで誤るかを明示できるモデル」のほうが、「誤答率は10%だが、いつ誤るか予測できないモデル」よりも実用上はるかに有用であるという論理です(参照*12)。
閾値の設計方針は型によって異なります。Choiceでは信頼度スコアの下限値を基準とし、例えば0.9を超えた場合のみ後続処理を実行するよう設定します。一方、Noulでは確実性が0または1の両端に位置し、中央の0.5付近が不確実性を示すため、判定の確度は0.5からの絶対的な乖離幅によって評価します(参照*13)。
苦手なタスクと公開数値の扱い
モデルが不得手とするタスクや、公開されている性能指標の前提条件についても把握しておく必要があります。ベンダー公表のベンチマークは、自社のユースケースと測定条件が違うことがほとんどです。導入前に自分のデータで検証することは必須と考えてください。
TypeSafeの技術文書では、Jev 1.13の弱点(失敗モード)として初歩的な算術計算や個数のカウント、日付の前後関係の判定が挙げられています。さらに、無関係なコンテキストの混入による精度低下や、敵対的プロンプトを事前に防御しない点も指摘されています。型付き出力によりフォーマット崩れは防止できるものの、許容された選択肢の中から誤った判断を下す可能性は依然として存在します(参照*6)。
公開ベンチマークの解釈にも前提の理解が欠かせません。TypeSafe独自の4ワークフローによるベンチマークにおいて、Jevのスコアは67.8%となり、GPT-5.6 Solの74.1%やClaude Opus 5の73.1%を下回りました。
ただし、ここで示される正確度とは絶対的な正解データとの比較ではなく、合意ラベルとして採用された2つの最先端モデルとの一致度を意味します。自社のドメイン固有データで独自検証を行うまでは、Jevの公表数値を参考情報(自己申告)として捉える姿勢が求められます(参照*14)。生成AIの導入支援をしていると、ベンダー数値をそのまま信じて進めてしまうケースは少なくありません。「性能が良さそうだから使う」ではなく、「自分たちのタスクで検証してから判断する」という手順を踏むことが現場定着への近道です。
おわりに
Decisions APIとJevは、いずれも回答をあらかじめ定めた候補に限定し、判定結果のみを高速に出力するモデルです。比較対象の6項目のうち、出力形式や料金体系、入手性については、現時点でJev側の具体的な情報が充実しています。対するDecisions APIは限定プレビューの段階にとどまり、料金やレスポンス形式の仕様は未公開です。今すぐ試して業務に組み込みたいのであれば、現時点ではJevを選ぶほかありません。
TechCrunchは、これら意思決定モデルの出力が実際のユースケースにどこまで適合するかが本質的な課題であると指摘しています。登場から間もない技術ではあるものの高いポテンシャルを秘めており、有望な活用先の一つとしてAIエージェントの動作監視やガードレール機能が挙げられています(参照*15)。私自身、生成AI導入支援の現場で感じるのは、「何をAIに判断させ、何を人間が判断するか」を設計する難しさです。判断専用モデルという発想は、その線引きをシステム的に実装する一つの答えになり得ます。ただし、閾値設計や失敗モードの把握、自社データでの検証を省略すれば、速くて安価なまま間違い続けるシステムができあがるだけです。技術の可能性と、現場導入の難しさは切り離して考える必要があります。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) DuckDB – Jev and DuckDB: Plain-English Conditions in SQL
- (*2) System One Models – OpenAI Decisions API
- (*3) The Decoder – OpenAI expands Codex and its API at DevDay with security scans, a Decisions API, and Ultrafast
- (*4) The New Stack – OpenAI answers TypeSafe's Jev with a Decision API built on Luna
- (*5) MarkTechPost – 20 Agentic Use Cases of TypeSafe AI's Jev
- (*6) Braintrust – What is Jev? A guide to AI that makes decisions
- (*7) MLflow AI Platform – Can Jev replace your LLM judge? Evaluating quality, cost, and latency
- (*8) Jev Tutorial – Choice, Score, Noul, SDKs and LangChain
- (*9) Decisions API – Decision Models, Playground & API
- (*10) What Is Jev? A Guide to TypeSafe AI’s System One Model
- (*11) alphaXiv – JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
- (*12) freeCodeCamp.org – How to Build an AI Résumé Screening Tool with Next.js, Supabase, and TypeSafe Jev
- (*13) Sanity.io – What is a Noul in the Jev API? Definition and examples
- (*14) Real-Time Content Linting in the Editor With Typed Decisions
- (*15) TechCrunch – OpenAI's Jev clone could help the frontier lab stop its swarming agents