この記事のまとめ
Muse Wonderは、MetaがMuse Sparkの技術基盤をもとに開発したモデルシリーズです。第三者機関のArtificial AnalysisによるIntelligence Indexでは、上位版のMuse Wonder Fullが56点を獲得し、58点のClaude Opus 5.5に次ぐ2位につけました。標準版Muse WonderのAPI料金はOpus 5.5と同等のトークン単価ですが、利用できる環境には一定の条件が設けられています。
Muse Wonderの要点は4つあります。
- Muse WonderとMuse Wonder Fullは、2026年10月12日にMetaが発表したエージェント向けモデルです。
- Artificial AnalysisのIntelligence Index v4.3では、Wonder Fullが56点、Wonderが52点を記録し、Opus 5.5の58点に迫る結果となりました。
- 標準版Muse WonderのAPIは入力100万トークンあたり4ドル、出力100万トークンあたり20ドルであり、Opus 5.5と同価格です。
- 上位版のWonder FullはMuse Codeの加入者限定で提供されており、API経由では利用できません。
Muse Wonderの概要と位置づけ
Muse SparkからWonderへの進化
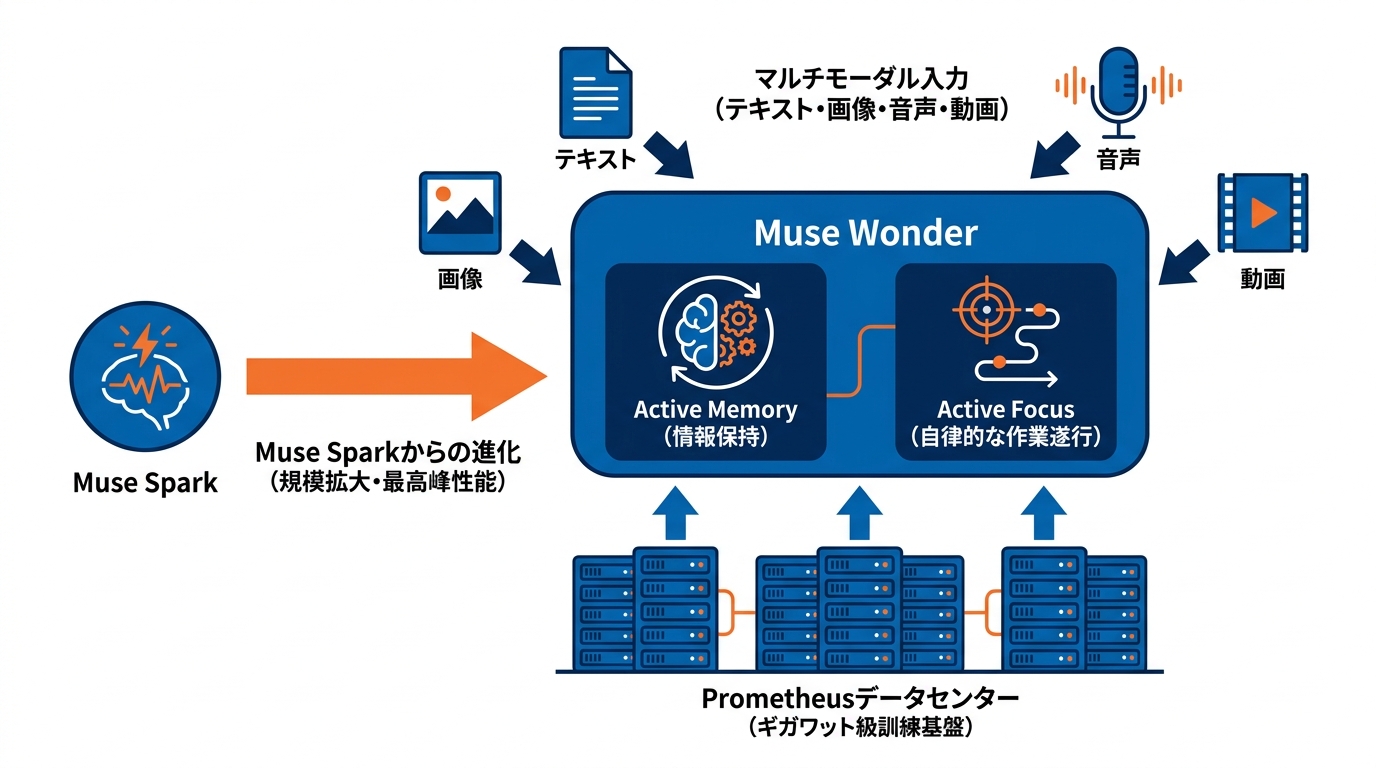
Muse Wonderは、軽量モデルであるMuse Sparkの系譜を継ぎつつ、規模を大幅に拡大したモデルです。Sparkが低遅延・軽量を優先した設計だったのに対し、Wonderは処理能力と規模の両立を狙っており、方向性が明確に分かれています。
Metaは2026年10月12日にMuse Wonderシリーズを発表し、Muse WonderおよびMuse Wonder Fullを、個人や業務向けのエージェント処理に適した最先端モデルとして公開しました(参照*1)。
発表によると、両モデルはMuse Sparkで培った基盤技術の上に構築されており、同社史上最高峰の性能を誇ります(参照*2)。
低遅延な動作を追求した軽量モデルのSparkに対し、Wonderは規模と処理能力を重視しており、プログラミングなどの複雑なタスクでも優れた成果を発揮します(参照*3)。
モデルの学習基盤となったのは、Metaの大規模データセンターです。Metaの研究ブログによると、両モデルはギガワット級のPrometheusデータセンターで訓練され、社内各チームの技術を結集することで、業務や日常生活における高度な作業を完遂できる能力を獲得しました(参照*4)。計算資源に関しては、他の大手と比べても引けを取らない規模の投資が行われています。
Active MemoryとActive Focus
長時間の連続した作業を支える機能として、MetaはActive MemoryとActive Focusの2つを実装しました。
Metaの説明によると、Active Memoryは複数回のやり取りをまたいで重要な情報を保持し、当面の作業に必要な詳細を呼び戻す機能です。一方のActive Focusは、難度の高い作業でも目標を見失わずに進め、代替手段の検討やエラーからの自律的な回復を重ねて完了へと導く役割を担います。さらに、必要に応じた判断伺いや、重要な操作を実行する前のユーザー確認も行います(参照*2)。私がこの2機能を見て注目したのは、「目標を見失わない」という設計思想です。エージェントが途中で脱線せず、かつ自律的にエラーから回復するという挙動は、実務への組み込みを考えるうえで重要な要件です。
対応する入出力の形式も多岐にわたります。新モデルは入力としてテキスト、画像、音声、動画を受け付け、テキストで回答を返します。処理可能なコンテキストウィンドウは約100万トークンです(参照*5)。
開発名Watermelonと開発体制
Muse Wonderは、開発段階ではWatermelonというコードネームで呼ばれていました。
MetaのAI責任者を務めるアレクサンドル・ワン氏は月曜日のインタビューで、同社がWatermelonの名称でMuse Wonderを開発してきた経緯を明かしました。その目的は、個人向け・法人向け双方のエージェント機能を強化し、飲食店の予約やスケジュールの空き状況確認といった実作業で処理が停滞しないようにすることだと説明しています(参照*6)。
体制の面では、新たな指揮系統のもとで結実した最初の成果にあたります。今回の発表は、Scale AIの創業者であるAlexandr Wang氏が昨年8月にMetaのAI部門を統括・再編して以来、初となるフロンティアモデルの投入となりました(参照*3)。
ベンチマークで見た実力
総合スコアと競合モデルとの差
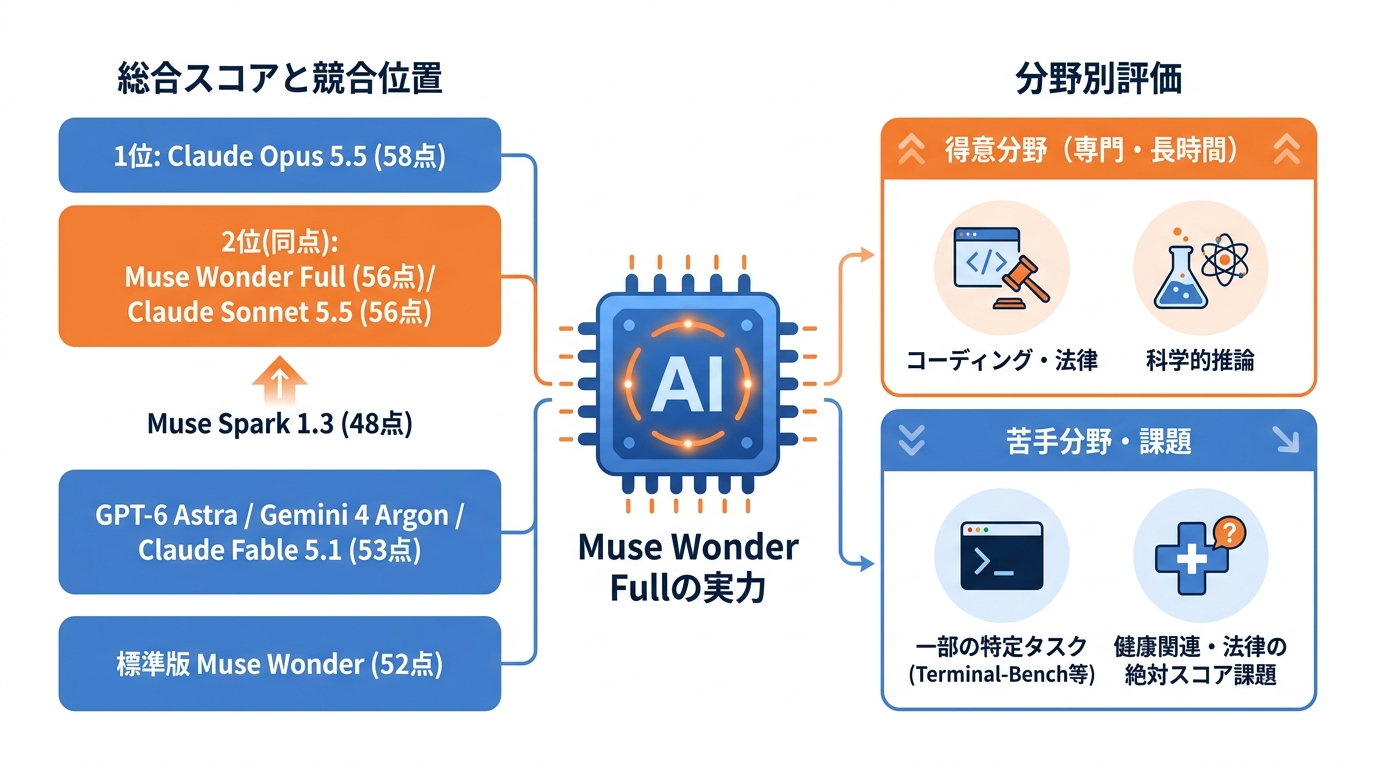
総合ベンチマークにおいて、Muse Wonder FullはClaude Opus 5.5の直下に位置する高スコアを記録しました。ベンチマークの数字だけで実力を断定するのは危険ですが、第三者機関であるArtificial Analysisの検証結果は、一定の信頼性があると私は見ています。
Artificial Analysisの検証によると、最大推論設定におけるArtificial Analysis Intelligence Index v4.3のスコアは、Muse Wonderが52点、Muse Wonder Fullが56点でした。Muse Spark 1.3(最大)の48点からわずか6週間の間隔で大幅な進化を遂げています(参照*7)。
競合モデルとの関係性も同指標によって明確に示されています。Wonder Fullの56点はAnthropicのClaude Sonnet 5.5と同点であり、OpenAIのGPT-6 Astra、GoogleのGemini 4 Argon、AnthropicのClaude Fable 5.1が記録した53点を上回りました。
これを凌いだのは、Anthropicの最上位モデルClaude Opus 5.5の58点のみです。また、標準版のMuse Wonderも52点を獲得し、GPT-6 Astraに1点差で迫っています(参照*5)。
得意分野と苦手分野
個別項目に目を向けると、長時間のコーディングや専門的な業務では強さを発揮する一方、一部の分野では他社モデルの後塵を拝しています。
Artificial Analysisの検証では、エージェント型のナレッジワークにおいてGDP.pdfが僅差の1位(33%)、GDPval-AA v2.1が2位(1857 Elo)、AA-Briefcase(1729 Elo)とAutomationBench-AA(71%)が3位にランクインしました。科学的推論分野でもCritPtのリーダーボードで33%をマークして首位に立ち、SciCodeでは63%で3位に入っています(参照*7)。
コーディングと法律の領域でも顕著な差が見られます。SWE-MarathonではWonder Fullが57.5点をマークし、Opus 5.5の46.3点やGPT-6 Astraの42.5点を上回りました。
法律関連の指標でも13.1点を記録し、比較対象のモデルを大きく引き離しています。ただし、この法律分野の絶対的なスコアは依然として低く、エージェントが十分に満足できる法律関連の成果物を安定して作成するには課題が残ることを物語っています(参照*5)。
一方、すべてのタスクでトップに立ったわけではありません。Artificial Analysisの総合スコアではOpus 5.5がWonder Fullを上回っており、Terminal-Bench 4.0でもOpus 5.5とGPT-6 AstraがWonder Fullに先行しました。健康に関する問い合わせへの対応でも、Opusが比較群の中で最高水準のスコアを記録しています(参照*5)。
ベンチマーク結果の読み方
公表されたスコアを吟味する際は、測定された環境や検証主体を慎重に見極める必要があります。ここは重要なので、少し丁寧に説明します。
Metaが公開した検証手法の解釈には一定の注意が求められます。モデルカードによれば、比較データには社内検証値、ベンダー提供の数値、第三者の検証結果が混在しています。ソフトウェアエンジニアリングの一部テストではツール環境が統一されておらず、完全な同一条件下での比較ほど厳密ではない側面があります(参照*5)。
測定する指標によってモデルの優劣は反転します。AA-Omniscienceの評価では、Muse Wonder Full(最大)が30点、Muse Wonder(最大)が25点にとどまり、Muse Spark 1.3(最大)と同等で、Claude Opus 5.5(46点)、GPT-6 Astra(43点)、Gemini 4 Argon(42点)、Claude Sonnet 5.5(32点)に及びませんでした。
反面、Wonder Full(最大)のスコア改善はハルシネーション率が33%から23%へと低下した成果であり、Intelligence Indexが45以上のモデル群では、Gemini 4 Argon(高)の15%に次ぐ低率を記録しました。Muse Wonder(最大)も27%で3番目に位置しています(参照*7)。
私自身、新しいモデルが出るたびに宣伝文句ではなく手元のタスクで実力を確かめる姿勢を取っています。Muse Wonderについても、コーディング支援や長文調査といった実務寄りのタスクでどこまで使えるかを検証するつもりです。ハルシネーション率の改善は数字として明確に出ていますが、「見た目が調査レポートらしいほど騙されやすい」というリスクは依然として残ります。スコアが改善されても、出典確認と事実確認は人間が引き受ける必要があります。
料金と使える場所
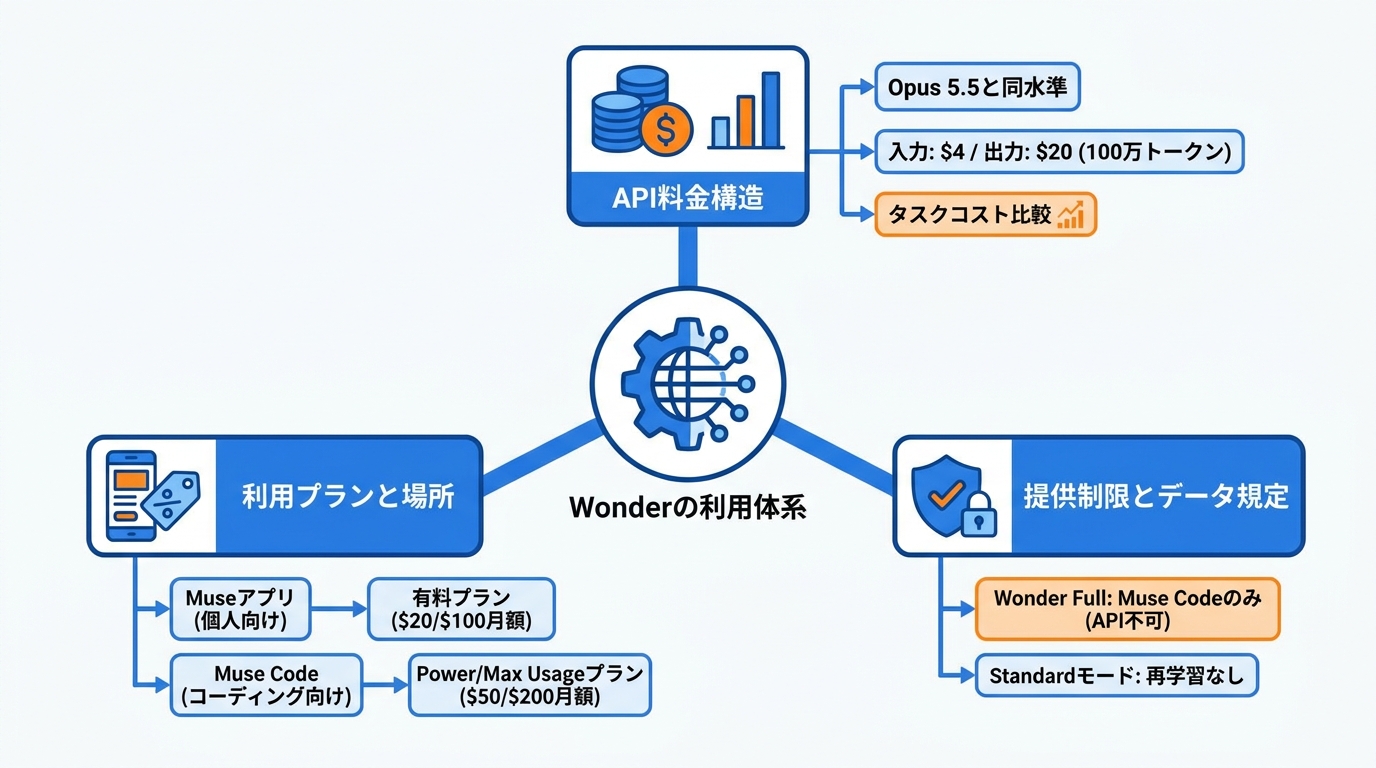
APIの料金とOpus 5.5との比較
APIの利用料金は、競合であるClaude Opus 5.5と完全に同水準に設定されています。
価格体系は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルであり、プロンプトキャッシュ適用時の入力は100万トークンあたり0.20ドルに引き下げられます。Metaはコンテキストウィンドウの消費量にかかわらず一律の単価を適用する方針です。
APIを通じたウェブ検索機能には、1,000回ごとに2.50ドルの追加費用が発生します。この価格設定により、WonderはClaude Opus 5.5と同等でありながら、GPT-6 AstraやClaude Fable 5.1よりも安価に利用可能です(参照*5)。
トークン単価だけでなく、タスクあたりの実効コストも重要な比較軸です。Artificial Analysisによれば、Wonderは出力効率に優れるものの、入力4ドル・出力20ドルという価格帯と入力トークンの多さ(1タスクあたり769万個)が影響し、Muse Wonder(最大)のタスクあたりコストは4.52ドルとなります。これはClaude Fable 5.1(フォールバックあり最大)の7.63ドル、Claude Opus 5.5の5.98ドル、Claude Sonnet 5.5の5.46ドルより割安な一方、GPT-6 Astra(最大)の3.26ドル、Gemini 4 Argon(高)の1.99ドル、GPT-6.1 Sol(最大)の0.72ドル、前世代のMuse Spark 1.3(最大)の1.60ドルを上回っています(参照*7)。コスト比較では、トークン単価だけを見て判断するのは落とし穴です。実際のエージェントタスクで何トークン消費するかを試算しなければ、見かけ上の安さに引きずられます。
サブスクリプションと提供範囲
用途や利用形態によって、選択すべきプランと利用可能なモデルが分かれています。
パーソナルエージェントアプリ「Muse」上で当モデルを利用する場合は、月額20ドルまたは100ドルの有料プランへの加入が求められます(参照*6)。
コーディング向け環境のMuse Codeでは、月額50ドルのPower UsageプランでWonder Fullが解禁され、Everydayプランの20倍の利用枠が付与されます。さらに月額200ドルのMaximum Usageプランでは、80倍相当の利用枠が用意されています(参照*5)。
上位モデルの提供形態は一部に限定されています。Wonder FullはMuse Code加入者のみに提供され、API経由での開放は行われていません。なお、両モデルともにMuseエージェントの中核エンジンとしても組み込まれます(参照*3)。
データ利用モードと制約
送信データの取り扱い方針は、選択した運用モードによって明確に異なります。
Metaの規定では、Standardモードで送信されたデータがモデルの再学習に用いられることはありません。従量課金のWonder APIはこのモードに限定して提供されます。
一方、Muse Codeのサブスクリプションプランは初期設定がContributorモードとなっており、入力プロンプト、ソースコード、添付ファイル、出力内容がモデル改善の学習データとして収集されます。設定を無効化することも可能ですが、適用されるのは変更後の送信分に限られます。加えて規約上、Contributorモード利用時に機密情報や個人情報、センシティブなデータを送信することは厳格に禁じられています(参照*5)。業務利用を検討する企業にとっては、ここが最初の確認事項になります。初期設定がContributorモードという点は、見落とすと後から問題になります。
データ非保持設定の適用には、いくつかの機能制限が伴います。Metaによれば、ゼロデータ保持設定を有効にした場合、サーバー側の対話履歴保持、バックグラウンド処理、ファイル添付、標準ウェブ検索が利用できなくなります。利用可能な機能はモデルごとに差異が生じる点にも留意が必要です(参照*5)。
実務への効き方
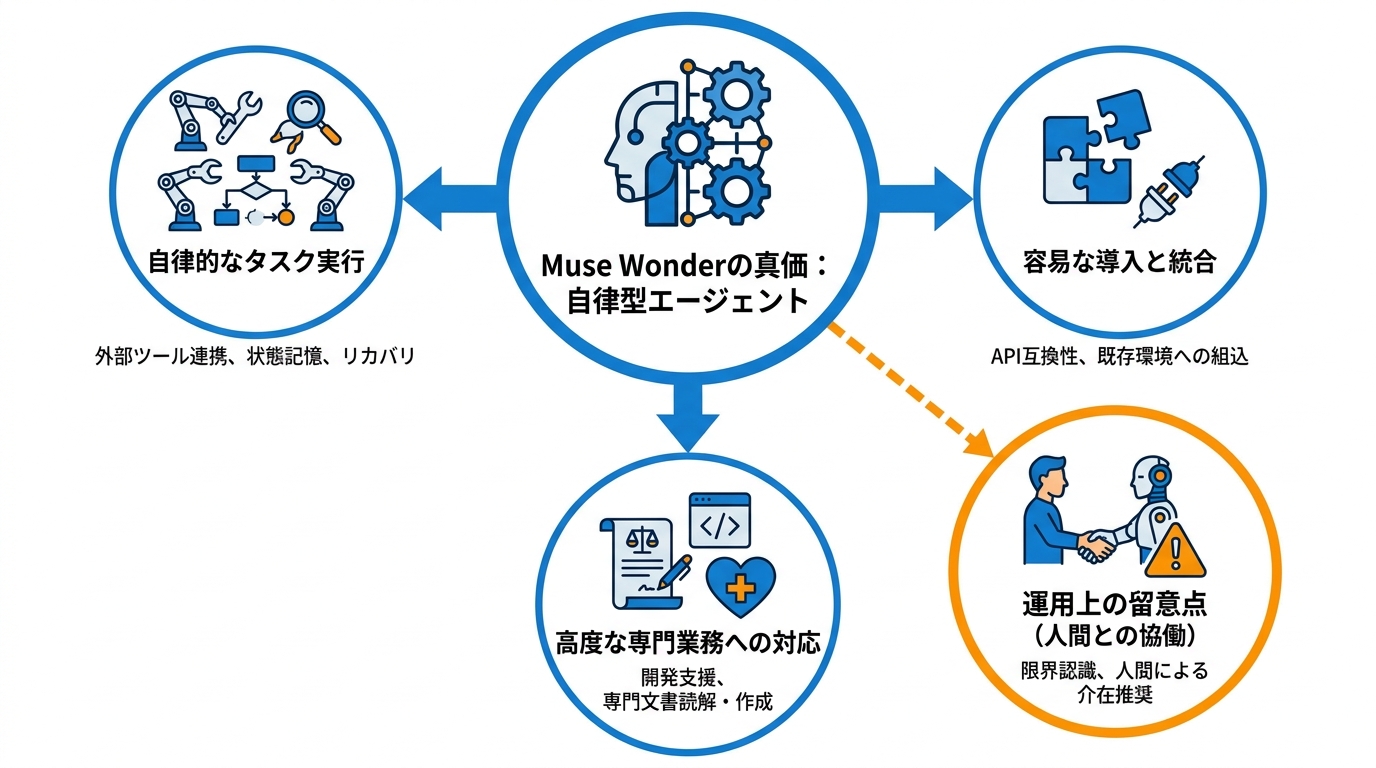
Muse Wonderが真価を発揮するのは、単純なチャット応答ではなく、自律的かつ長期にわたり稼働するエージェントタスクです。私が実務でAIを使う中で実感しているのは、「一問一答型」のモデルと「タスク完遂型」のモデルでは、評価軸がまったく異なるという点です。
Metaは、複数の外部ツールを行き来し、状態を記憶しながら当初の目的達成に向けて自律リカバリを行うユースケースを想定してWonderを設計しました。本モデルの強みは、従来型の対話型ボットのような受け答えにあるわけではありません(参照*5)。
導入に向けた検証条件もすでに公開されています。APIドキュメントによると、レートリミットは毎分3,000リクエストおよび400万トークンで、コンテキスト長は100万トークンを誇ります。既存のOpenAIやAnthropicの開発ツールと互換性のあるエンドポイントを備えているため、構築済みのエージェント環境へも容易に組み込めます(参照*5)。既存のAnthropicやOpenAI環境との互換性は、乗り換えや併用のコストを下げる意味で実務的なポイントです。
開発支援の場面でも、第三者評価でトップクラスの実力を証明しました。Artificial Analysisによると、Muse Code上で最大推論設定を用いたMuse Wonder Fullは、Coding Agents Indexにおいて68点を記録しました。
これはClaude Code上のSonnet 5.5(最大)の68点やOpus 5.5(最大)の66点に匹敵する高水準です。なお、標準版のMuse Wonder(最大)は63点でした(参照*7)。
高度な専門業務では、参照資料を精読した上で成果物へと落とし込む能力が問われます。研究ブログによると、両モデルは賃貸契約書の読解から金融や健康に関する情報の把握まで、実社会の課題に専門知識を適用する目的で訓練されました。法律や金融、医療タスクを取り入れた評価例としてHarveyのLegal Agent Benchmark(LAB)があり、モデルは関連文書を読み解き、指示に沿った法律関連の成果物を作成するタスクを課されています(参照*4)。
実運用にあたっては、Meta自身もモデルの限界を認めています。安全対策の導入を進めつつも、重大な結果を招きかねない操作には人間の介在を推奨しています。経験のない多段階タスクでの判断ミスや、連携する外部ツールの性能による制約を受ける可能性についても注意を促しています(参照*5)。この点はMetaが正直に認めていると評価しています。生成AIの業務導入で重要なのは、チェック・補正・承認をどう低コストに組み込むかです。エージェントが自律動作するほど、人間の確認工程の設計が問われます。
MetaのAI戦略と挽回の道筋
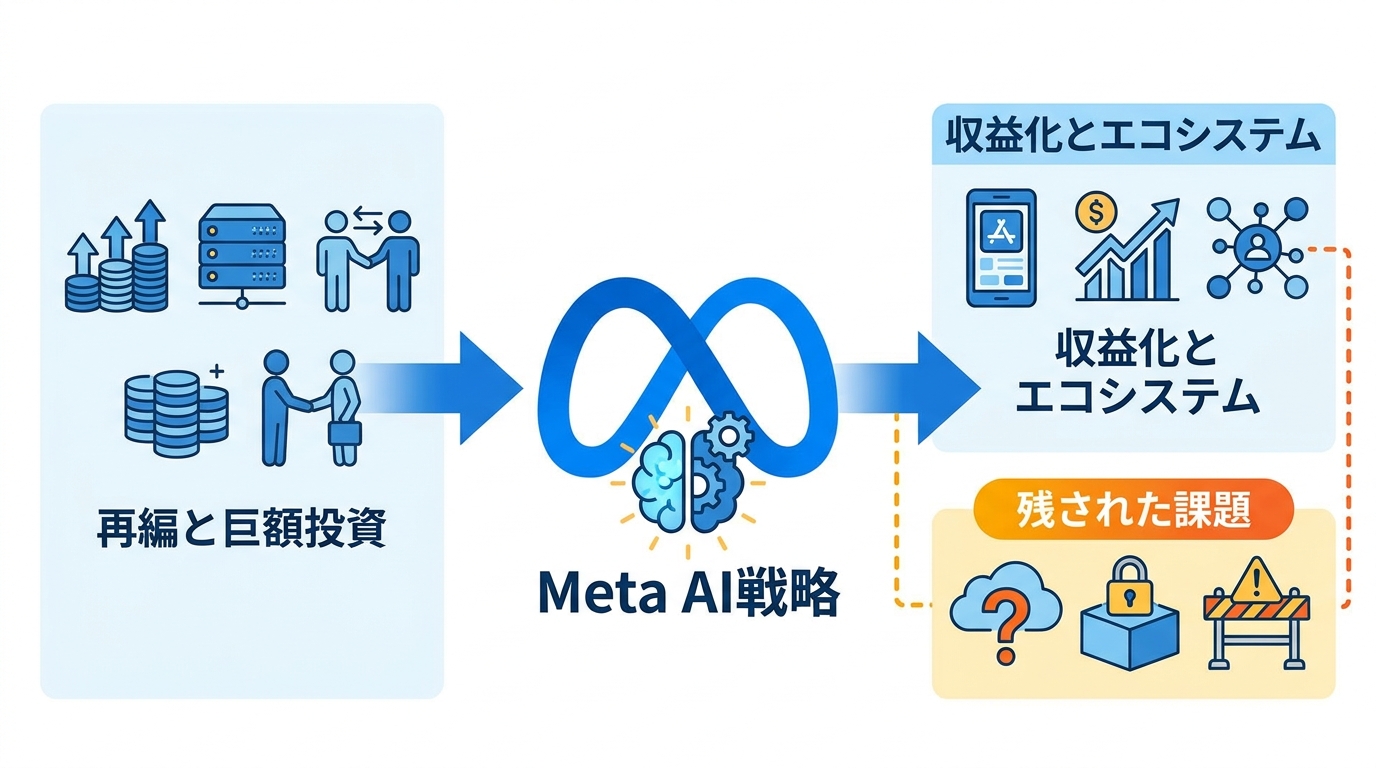
出遅れから再編までの経緯
Muse Wonderの登場は、Metaが人材と計算基盤へ巨額の投資を重ねてきた集大成といえます。出遅れた組織が短期間でフロンティアに戻れるかどうかは、AI業界全体にとっても興味深い問いです。
MetaはかつてAIのパイオニアであり、Llamaシリーズは大手企業による初の最先端オープンウェイトモデルとして脚光を浴びました(参照*8)。
しかしその後、競合大手に対して一時的な後れを取ることとなり、同社とMark Zuckerberg氏は人材獲得やインフラ整備へ向けて大規模な投資を決断しました。Scale AIに143億ドルを投じ、当時28歳だった同社CEOのAlexandr Wang氏を最高AI責任者として招聘した経緯があります(参照*9)。
時間的な経過の観点からも、今回の動きは重要な転換点です。ザッカーバーグ氏が社内のAI開発体制を再編し、新組織MSLを発足させてから約14か月での成果公開となりました(参照*5)。
収益化とMuseエコシステム
Muse Wonderは、ユーザーベースを急速に拡大しているMuseアプリと連携することで、直接的な収益貢献が期待されています。
今回のモデル発表に先立ち、Metaのエージェントアプリ「Muse」は大きな躍進を見せていました。Museは9月時点で500万件以上のダウンロードを達成しています。Metaは人気プロダクトの基盤に最新モデルを組み込む方針を打ち出しており、Muse Wonderもまもなく一般ユーザー向け体験の柱として稼働する見込みです(参照*10)。
ビジネスモデルの将来性については、市場アナリストからも肯定的な分析がなされています。セバスチャン氏は、Muse Codeの購読料やMeta Model APIの利用料を通じた直接的な収益化が可能だと指摘しました。加えて、自社アプリ群の競争力向上や新規市場の開拓、さらなる新事業の創出をWonderが後押しすることによる、間接的な収益拡大も見込めるとしています(参照*10)。
法人向けの事業基盤も着々と整えられています。Meta Platformsは2026年9月29日、AIモデルや開発環境、データセンターの処理能力をエンタープライズ向けに統合して提供する新事業「Meta Enterprise Platform」の立ち上げを発表しました(参照*11)。
残された課題
高い評価を得た性能の一方で、提供体制や情報の透明性には依然として課題が残されています。性能と使いやすさは別の話であり、ここを混同すると導入判断を誤ります。
採用を検討する企業にとっては制約事項が少なくありません。上位のWonder Fullは汎用API経由では提供されず、現時点ではオンプレミスなどでの自社ホスティングも認められていません。機密性の高いデータを扱う組織では、提供モードごとのデータ保護規程を詳細に確認する必要があります(参照*5)。私が企業へのAI導入支援をしていて毎回感じるのは、「便利だが現場導入は難しい」という壁です。Wonder Fullがベンチマーク上で優秀でも、汎用APIで使えなければ多くの開発者には選択肢になりません。
開発プロセスに関する情報開示にも注視が続いています。MetaはMeta Superintelligence Scaling Frameworkの基準に準拠して開発と評価を行っていると主張し、安全性に関する包括的な評価レポートを追って公開する予定です(参照*2)。
同社は今年4月にMuse Sparkを発表したほか、小型モデルのMuse Glimmerをオープンウェイトで公開し、将来的には大型モデルの公開も示唆しています。しかし、今回のMuse Wonderがどのように設計され、いかなるデータで訓練されたのか、その詳細な技術仕様は依然として非公開のままです(参照*8)。Llamaシリーズでオープンウェイトを推進してきたMetaが、フロンティアモデルの技術仕様を非公開にしている点は注目に値します。競争環境の変化が、オープン戦略にも影響を与え始めているということかもしれません。
おわりに
Muse Wonderは、Metaがエージェント領域での主導権奪還を期して投入したモデルです。Artificial AnalysisのIntelligence Index v4.3では、Wonder Fullが56点、Wonderが52点を記録し、Opus 5.5の58点に肉薄する成果を見せました。ただし、AA-Omniscienceをはじめとする一部の知識ベンチマークでは依然として競合の後塵を拝しています。ベンチマーク上の数字は状況の一側面に過ぎず、「どのタスクで使うか」によって評価は変わります。
利用にあたっての前提条件も整理されています。API価格は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルであり、Wonder FullはMuse Code購読者のみに提供されます。データの取り扱いはモード設定に応じて異なり、詳細な安全性検証レポートの公表が今後待たれるところです。私自身も実際にタスクを通じて検証を続けるつもりですが、まずは「どのタスクに入れると効果が出るか」を業務単位で分解することが、導入判断の出発点になると考えています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Unite.AI – Meta Unveils Muse Wonder Series, Its Most Capable AI Models Yet
- (*2) Meta Newsroom – Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents
- (*3) TechCrunch – Meta releases its first frontier model, Muse Wonder
- (*4) Meta AI Research – Muse Wonder: A Frontier Model For Personal & Professional AI Agents
- (*5) Venturebeat – Meta's new Muse Wonder and Muse Wonder Full models achieve frontier performance, but only the weaker one is available via API
- (*6) CNBC – Meta debuts Muse Wonder AI model in test of users' willingness to pay
- (*7) Muse Wonder and Muse Wonder Full: a material jump in intelligence over previous Meta models
- (*8) WIRED – Muse Wonder Puts Meta Back at the AI Frontier
- (*9) Mashable – Meta launches Muse Wonder, catching OpenAI, Anthropic: How to try it, benchmark results
- (*10) Morningstar, Inc. – Meta is back on the AI leaderboard with its new family of Wonder models
- (*11) Tech Insider – What Meta Enterprise Platform Actually Includes