この記事のまとめ
AIが生成した文章に埋め込む透かしは、単語を少し言い換えるだけで検知しにくくなります。OpenAIのtextGrainでは、400トークンの文章において単語の25%を置き換えたところ、検出率が約92%から17%まで低下したと報告されました。本記事では、透かしで判別できる範囲と限界、そして作成履歴を記録する考え方を3つのポイントで整理します。
- OpenAIの検証では、400トークンの文章で単語の10%を類義語へ置き換えると検出率は約92%から66%へ、25%置き換えると17%へと低下しました。なお、この検出率は偽陽性率1%に設定した検出器で測定されています。
- 透かしが検出されても、人の関与度合いや著作権の所在、内容の正確性は判断できません。反対に検出されない場合でも、人間が執筆した証明にはなりません。
- C2PAなどの署名付き来歴情報の活用や、使用モデル・バージョン・作成日・人間の監督状況を記録する実践が、透かしを補完する手段として提示されています。
言い換えで検出率17%という現実
同義語置換と検出率の低下
透かしの検出率は、単語を言い換えるだけで大幅に低下します。これは技術的な問題というより、透かしの根本的な限界を示しています。
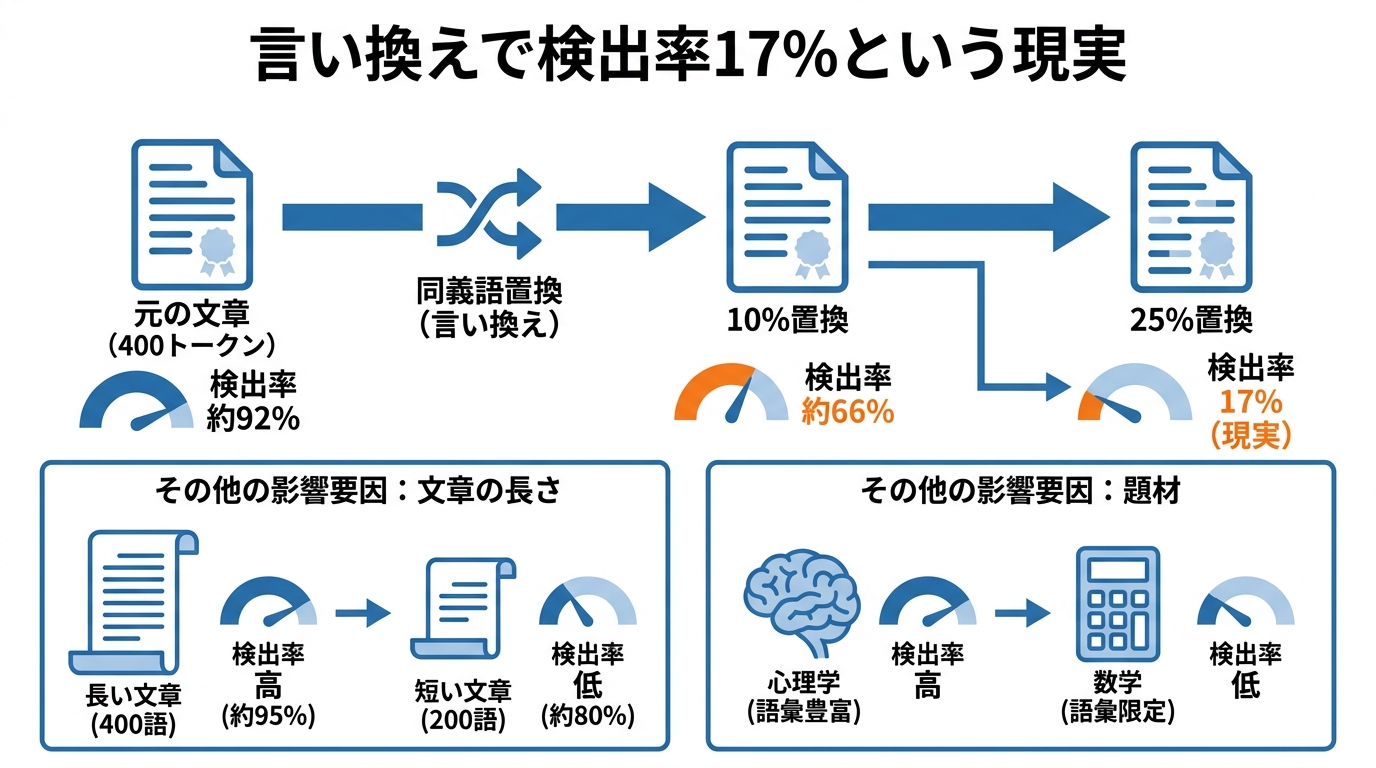
OpenAIによると、単語のわずか10%を類義語に置き換えただけで、400トークンの文章における検出率は約92%から66%へと低下しました。さらに全体の4分の1を置き換えると検出率は17%まで落ち込み、透かしを容易に回避できる状態になります(参照*1)。
同様の数値は、無編集で92%、10%置換で66%、25%置換で17%という同社のテスト結果としても報告されています(参照*2)。
ただし、この比較には留意すべき条件があります。同義語への置き換えに関する数値は、心理学分野の評価とは別の400トークンの文章群を用いた評価に基づいており、置換前の検出率は約92%でした(参照*3)。
文章の長さと題材による差
検出率は常に一定ではなく、文章の長さや扱われる題材によって変動します。
OpenAIの公式ブログには、英語のELI5データセットに含まれる質問への回答を用いて測定された検出率が公表されています。その数値は文章の長さやトピックに応じて異なっており、検出器は偽陽性率が1%となるよう調整されています(参照*3)。
文章の長さによる差は、測定結果に明確に表れています。誤検知率を1%に設定した検出器を用いた場合、心理学分野の400トークンの文章では約95%で透かしを特定できました。しかし、200トークンの文章では検出率が約80%まで低下しました(参照*1)。
題材による違いも報告されています。OpenAIによると、語彙の選択肢が限られる数学分野の文章では検出率が大幅に低下しました。
文章が長くなれば統計的シグナルが強まり検出精度が高まる期待はあるものの、結果はテーマごとに左右される可能性があります。なお、同社はこの仮説を検証する詳細データを提示していません(参照*1)。
検出結果が示せる範囲
透かしが検出できた場合であっても、そこから判明する情報は限られます。
OpenAIの見解によると、透かしはユーザー個人の特定や人間の関与度の測定、所有権の確定、内容の正確性を検証するものではありません。また、透かしが検出されない場合でも、人間が執筆した証明にはならない点に注意が必要です。文章が短すぎるケースや、編集・翻訳を経たケース、あるいは他社のAIモデルで生成された可能性が想定されるためです(参照*4)。
こうした制約は、技術を提供する側自身が明言している事実です。判定結果が陽性であれ陰性であれ、示せる情報は「透かしの信号が存在するか否か」という範囲を出ません。私がAI生成文章を毎日のように扱っている立場からすると、この限界は重要です。文章が自然に見えるほど読者は内容も正しいと錯覚しやすいのと同様に、「検出ツールが陽性を示した」という事実は、それ以上の意味を持たないにもかかわらず、過剰に解釈されがちです。
AIの透かしの仕組み
単語選択に埋め込む統計的信号
AIの透かし技術は、文章内に不可視の文字を挿入するのではなく、単語の選び方に規則的な信号を埋め込む仕組みです。仕組みを理解しておくことで、なぜこれほど簡単に信号が消えるのかが見えてきます。
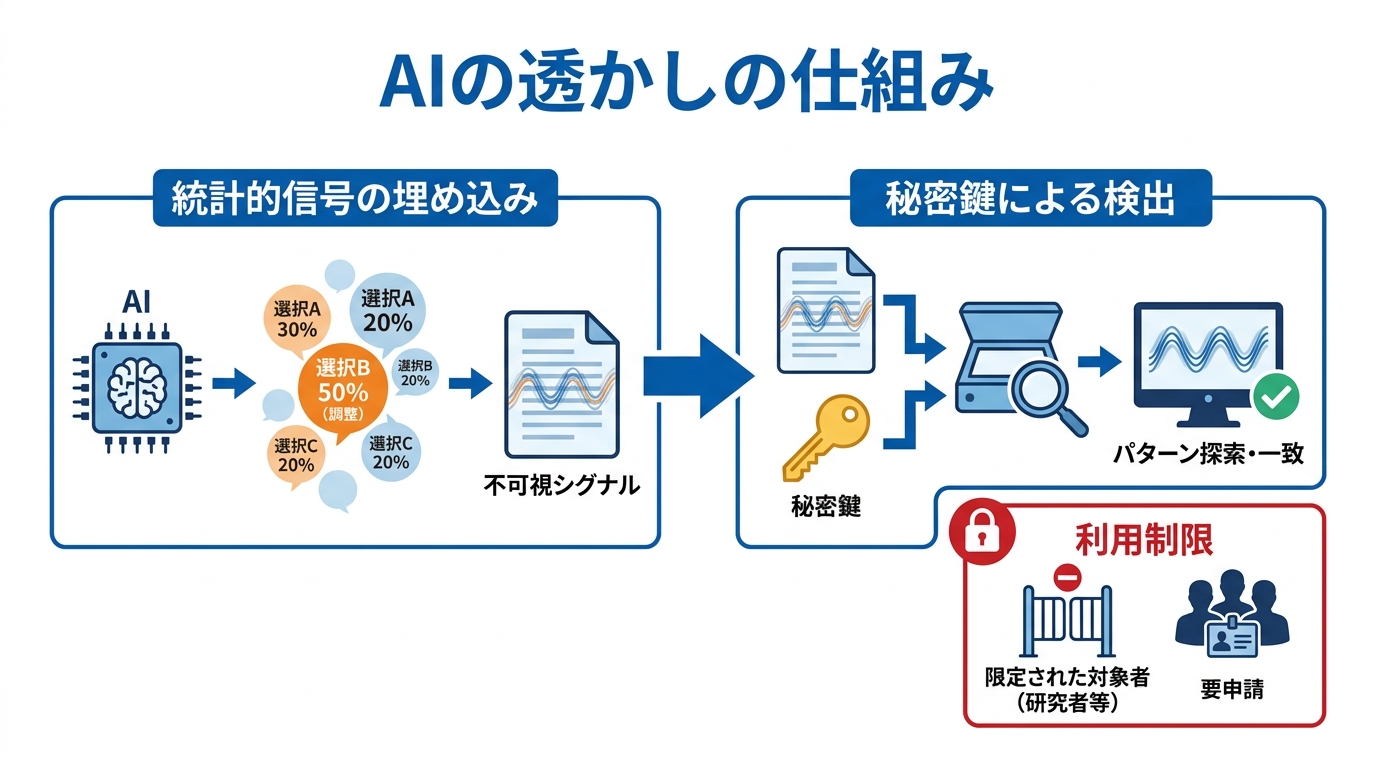
OpenAIの解説によると、textGrainはモデルによる単語選択の過程で不可視の統計的シグナルを生成します。そのうえで、専用の検出器がテキストを走査し、埋め込まれたパターンの痕跡を探索します(参照*5)。
その原理をより詳しく見ると、本質は確率の微細な調整にあります。言語モデルがテキストを生成する際、後続のトークン(単語の構成要素)を確率分布に基づいて順次選択します。
透かしの機構は、所定の秘密鍵に従い、特定の候補トークンが選ばれやすくなるよう確率をわずかに調整できます。個々の選択は自然に見えるものの、文章が十分な長さを持つことで偏りが蓄積され、検出可能な統計的シグナルを形成します(参照*6)。
検出器の仕組みと提供範囲
検出の実行には対象テキストと秘密鍵が必要であり、利用可能な対象者も限られています。
textGrainの技術文書によれば、検出器は生成されたテキストと秘密鍵のみを必要とし、生成時に使われた計算予算を知る必要はないと説明されています(参照*7)。
提供範囲にも制約が設けられています。初期段階においてtextGrainの検出器を利用できる対象は、選定された研究者や専門機関に限られます。
所定の申請フォームから申し込む形式をとり、OpenAIはEUの実践規範に基づいて個別にアクセスを許可しています(参照*1)。したがって、手元の文章を誰でも手軽に検証できる環境ではありません。
透かしが消えやすい条件
編集・翻訳・短文による消失
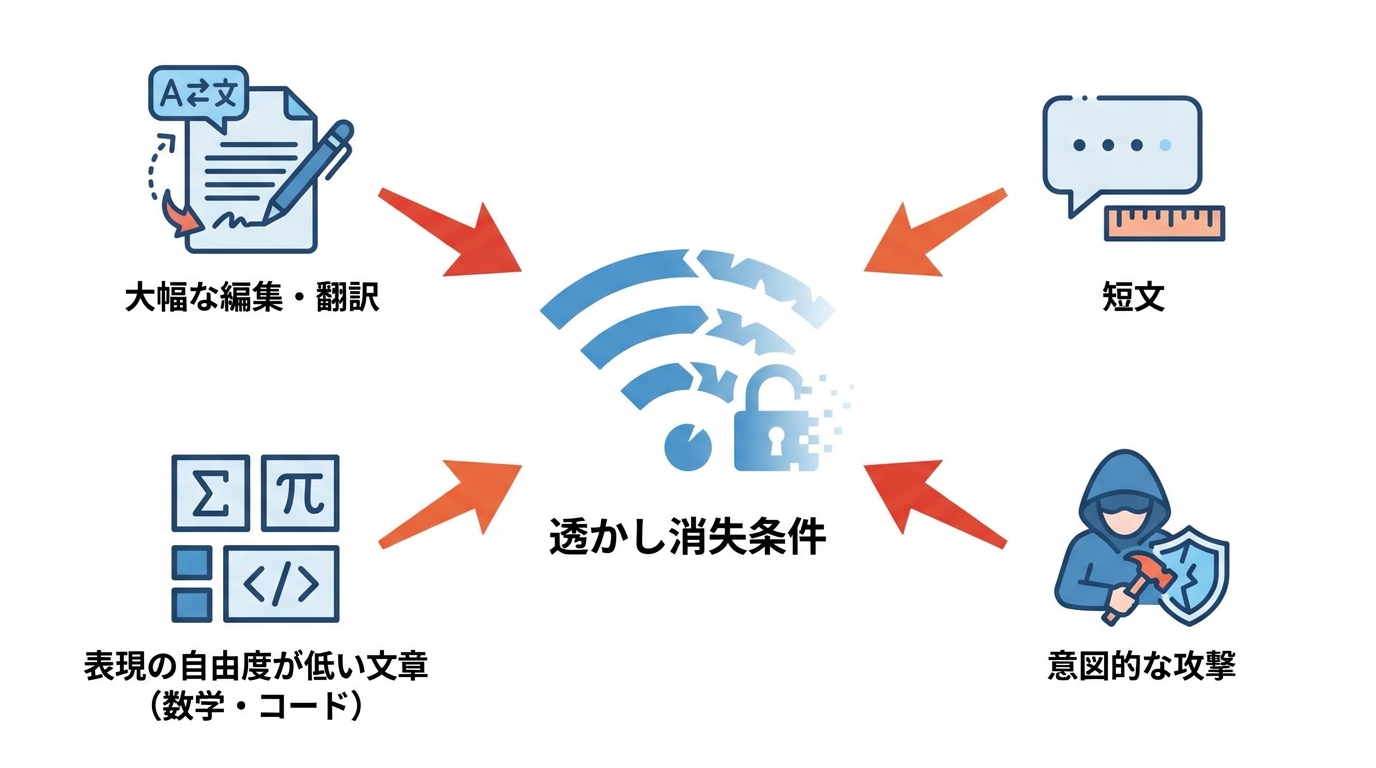
透かしは軽微な編集には耐性を持つものの、大幅に書き換えられた場合には消失しやすくなります。
この信号は、不可視文字や空白文字を追加するのではなく、単語の選択そのものに組み込まれます。OpenAIのヘルプセンターによると、textGrainは小幅な修正やコピー・アンド・ペーストに耐えるよう設計されている一方、大幅な言い換えや翻訳を行うと検出できなくなる場合があります(参照*3)。
短文に対する脆弱性も抱えています。短い文章では、統計パターンを確実に検出するためのトークン数が不足するためです。
大幅な言い換えや編集では、作為的な単語選択が別の表現に置換され、信号は消失します。対照的に、未編集のテキストをそのままコピーして貼り付けた場合は、トークンの選択が維持されるため信号が残ります(参照*8)。
数学やコードと攻撃への弱さ
表現の自由度が低い文章においては、そもそも透かしの信号が乗りにくくなります。
透かしは単語の確率的選択に依存するため、数学、プログラムコード、数式のように言い回しの自由度が低い文章には十分な信号を含められません。また、類義語の置換やパラフレーズ、翻訳など、単語を変える操作によってもシグナルは弱まります(参照*2)。
意図的な攻撃に関する研究も報告されています。LLMのテキスト透かしに対する攻撃手法には、言い換えや翻訳のほか、より標的を絞った「透かし窃取」があります。
透かし窃取では、攻撃者が透かしのパターン構造を学び、その後に信号の偽装や除去を試みます。2024年の研究論文では、この脅威モデルが形式化され、偽装や効果的な除去を可能にする実用的な自動透かし窃取が報告されています(参照*9)。
判定ツールに頼る危うさ
検出結果の誤った解釈
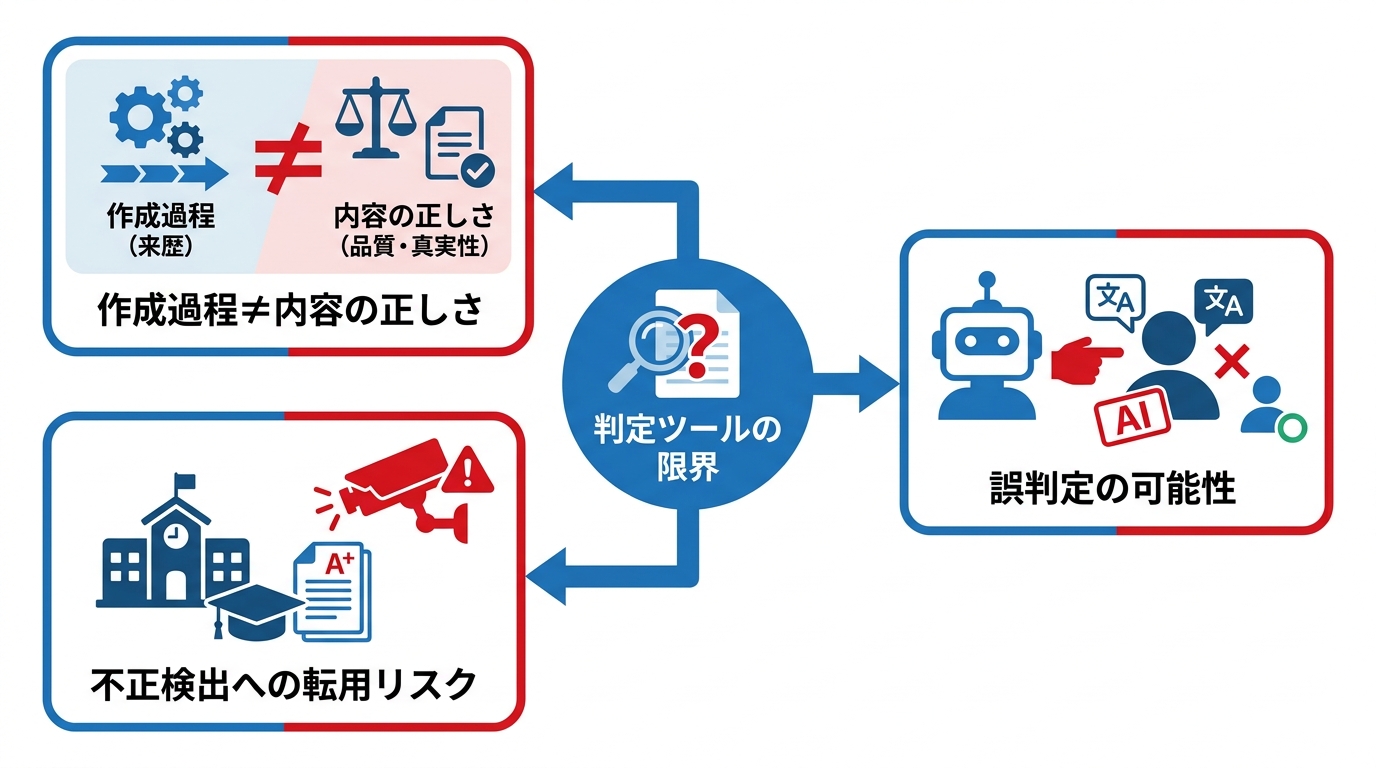
透かしの検出結果が示すのは、文章の作成過程に関する手がかりであり、内容の正しさや信頼性ではありません。ここを混同すると、判定ツールへの依存が誤った安心感を生みます。
作成の来歴と、受け取る側が感じる品質は根本的に異なります。コンテンツの来歴に関するC2PAの解説も同じ点を示しており、来歴情報はデジタル成果物の出所や履歴に関する証拠を示せますが、それだけでコンテンツが真実で、正確で、事実に基づいていると証明することはできません(参照*6)。
同様の整理は、クラウドプラットフォームの技術解説にもあります。出所情報は生成履歴に関する指標を示すものであり、コンテンツが正確、真実、有害、誤解を招く、あるいは信頼できるものかどうかを判断するものではありません(参照*10)。
透かしが検出されたとしても、それは作られ方に関する手がかりにとどまります。また、検出されなかったとしても、AIが関与していないことの証明にはなりません。つまり、陽性でも陰性でも、判定結果だけで何かを断定するのは危険です。
不正検出への転用が招く問題
透かしを不正行為の判定ツールとして運用することには、強い懸念があります。私自身も、生成AIを扱う現場でこの種の誤用を目にすることがあります。
この識別限界は、特に高等教育の現場で重要だと指摘されています。報道の一部は、透かしを学生の不正行為に対抗する新手段として扱っていますが、その解釈はもっともらしく見える反面、危険をはらんでいます。学生のレポートからClaudeの透かしが検出されたとしても、制作過程に関与した事実以上はほとんど判断できないためです(参照*6)。
AI検出器そのものの誤判定リスクも報告されています。Liang et al.(2023)の調査によると、広く使われている7つのGPT検出器はネイティブスピーカーのエッセイに極めて高い精度を示した一方、英語を母語としない人によるTOEFLエッセイの61%以上をAI生成と誤判定しました(参照*11)。不正を疑われた学生が、実際には自分で書いた文章を持っているというケースは、笑い話では済まない問題です。
作成の記録で信頼を支える
来歴メタデータと多層の確認
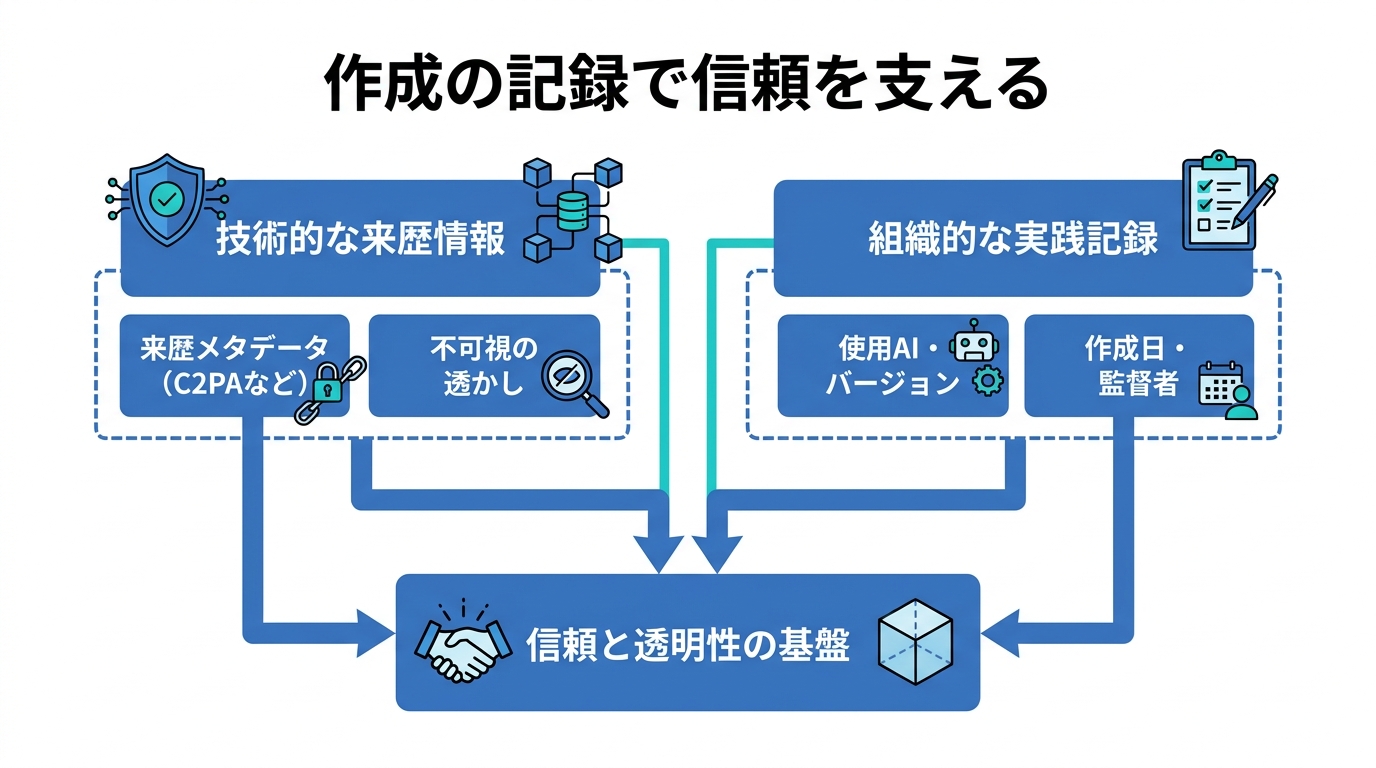
透かし単体に依存するのではなく、署名付きの来歴情報と組み合わせる考え方が示されています。これは現時点では最も現実的なアプローチだと私も考えています。
C2PAなどの暗号学的な来歴基準と不可視の透かしは、コンテンツ認証のための相補的な防御策として位置づけられています。ただし、2つの検証層は技術的に独立しており、どちらか一方の判定が他方の出力を左右するものではありません(参照*12)。
もっとも、来歴情報の側にも弱点が存在します。攻撃者がマニフェストからAI起源の主張を単に省略するケースです。C2PAは署名者に生成起源の申告を義務づけていないため、仕様上こうした抜け道が許されています(参照*12)。
運用面での課題も指摘されています。C2PAは、暗号学的に署名された来歴メタデータであるContent Credentialsを規定していますが、配信プラットフォームによってメタデータが頻繁に削除される実態があります。そのため、メタデータ、透かし、フィンガープリンティングを組み合わせる耐久性の高い方式が求められています(参照*9)。
組織での記録と開示の実践
作成履歴として何を残すべきかについては、教育分野の指針に具体的な実践例が見られます。ただし、これは教育現場に限った話ではありません。企業のコンテンツ発信でも、同じ考え方が応用できます。
1EdTech(IMS Global)の資料では、推奨されるベストプラクティスとして、AI生成コンテンツの起源と履歴を記録する出所記録の維持が挙げられています。記録に含める必要があるとされる情報は4つあります(参照*13)。
- 使用したGenAIシステムまたはモデル
- バージョン
- 作成日
- 人間または専門分野の専門家による監督の役割
この文書の位置づけにも触れておきます。同資料はAI生成コンテンツの責任ある利用を促すための推奨事項を示すものであり、義務的な要件を定めるものではありません。共通の分類体系と代表的なユースケースを含む一連の実践方法を示し、組織の取り組みを支援する内容です(参照*13)。
どのモデルやバージョンをいつ使い、誰がレビューを行ったのかを記録として残す運用は、検出器の結果に頼らずに作成過程の透明性を説明する材料になります。私自身、生成AIを使ったコンテンツ制作では、使用モデル、生成日、人間による確認範囲を記録するフローを採用しています。透かしが消えても、記録は消えません。これが結局、最も確かな「証跡」です。
おわりに
AIの透かしは、文章の出所を示す技術的シグナルのひとつです。OpenAIのtextGrainでは、400トークンの文章で単語の25%を置き換えると検出率が17%まで低下し、透かし単独を判定の決め手にする難しさが改めて示されています。技術として面白いのは確かですが、「透かしがあれば安心」という発想は危うい、と言わざるを得ません。
最も現実的な将来像は、透かしが暗号技術による来歴情報、プラットフォームのメタデータ、開示要件、そして人間による編集プロセスと並行して機能し、互いを補完し合う形です(参照*5)。判定ツールのみに頼るのではなく、作成の記録を残す取り組みこそが、透かしを補う確かな支えになります。AIの出力をそのまま信じるのも、検出ツールの結果をそのまま信じるのも、同じ構造の問題です。何をどう確認したかを明示できる仕組みを持つことが、結局は信頼の基盤になると考えています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) The Decoder – OpenAI will watermark ChatGPT text in the EU but makes it optional for API users worldwide
- (*2) CellCog – OpenAI Text Watermark: ChatGPT EU Rollout and textGrain
- (*3) ActuIA – textGrain, API and the AI Act
- (*4) TNW | Openai – OpenAI starts watermarking ChatGPT and Codex text in the EU
- (*5) TechnologyHQ – AI watermarking explained,” and “content provenance standards.”
- (*6) TZStats aiX Lab | Tian Zheng, Columbia Stats – Claude Is Getting an LLM Watermark. But What Exactly Are We Trying to Detect?
- (*7) https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf
- (*8) AACE – The Brussels Effect: A Conversation with LLMS about Watermarks in AI-Generated Content
- (*9) Watermarks: Protecting Digital Content with Visible, Invisible, and Forensic Watermarking
- (*10) Docs – Content provenance – Azure AI services
- (*11) Explainability-Based Token Replacement on LLM-Generated Text
- (*12) Authenticated Contradictions from Desynchronized Provenance and Watermarking
- (*13) 1EdTech AI-Generated Content Best Practices v1.0