この記事のまとめ
Moonshot AIの「Kimi K3.1 Pro」は、API料金が100万トークンあたり入力2ドル、出力10ドルと、Claude Opus 5.5の半額に設定されています。Terminal-Bench 4.0におけるMoonshotの自社報告値は65.7%であり、Opus 5.5の66.4%を0.7ポイント下回る結果となりました。主な注目ポイントは次の4点です。
- 価格は入力2ドル/出力10ドルで、Kimi K3の3ドル/15ドルから引き下げられました。
- Terminal-Bench 4.0の0.7ポイント差はMoonshotの自社報告で、Claude-Codeハーネスでの評価です。
- 総パラメータ2.8T、アクティブ104B、コンテキスト100万トークンで、K3を追加学習したモデルです。
- 全ウェイトは2026年11月4日までに公開予定で、サイバー関連の学習データを削除したうえで提供されます。
価格とOpusとの0.7ポイント差
API料金の水準とK3からの値下げ
まずは、Kimi K3.1 Proを利用する際の料金体系から確認します。新しいモデルが出るたびに私は価格と性能の両面を手元のタスクで確かめるようにしていますが、今回は価格設定がかなり積極的です。
料金は100万トークン単位で設定されています。Kimi K3.1 Proは入力2.00ドル、出力10.00ドル、キャッシュ済み入力0.20ドルです。
Kimi K3.1 Pro Highspeedは入力4.00ドル、出力20.00ドルで、キャッシュ済み入力は0.20ドルとなります。前世代のKimi K3は入力3.00ドル、出力15.00ドル、キャッシュ済み入力0.30ドルでした(参照*1)。
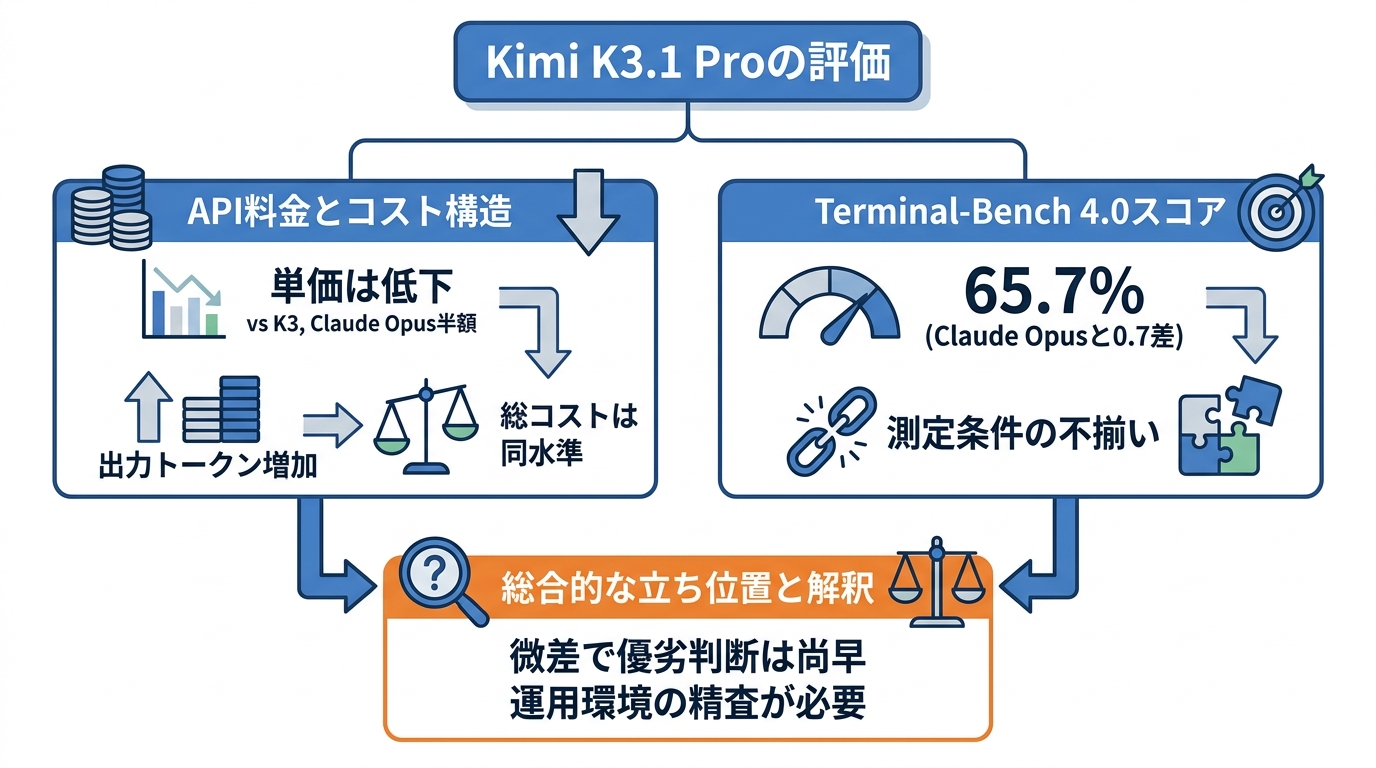
入力2.00ドル、出力10ドルという価格帯はGPT-6.1 Solと同額であり、Claude Opus 5.5の半額に相当します(参照*2)。モデルの性能が拮抗しているなら、価格差は意思決定に直結します。
ただし、トークン単価が下がってもタスク1件あたりの総コストは別の問題です。ここは重要なポイントで、Artificial Analysisによれば、K3.1 ProのIntelligence Index 1タスクあたりの費用は1.98ドルで、Kimi K3とほぼ同水準でした。
K3.1 Proは1タスクあたり5万5,000個の出力トークンを消費し、Kimi K3の4万8,000個より14%増加しています。一方で、ファーストパーティのトークン価格は33%安価であるという関係が成り立っています(参照*3)。
Terminal-Bench 4.0のスコア差
続いて、タイトルにある0.7ポイント差がどのような測定条件で算出されたのかを確認します。
Terminal-Bench 4.0は、リソース制約のある実践的なターミナル操作を、タスクごとの厳密なテストで測定するベンチマークです。Moonshotの報告によると、K3.1 Proのスコアは65.7%でした。GPT-6 Astraの58.2%を上回り、Claude Opus 5.5の66.4%をわずかに下回る水準となっています(参照*4)。
この数値には評価条件が前提として存在します。Moonshotは、Kimi K3.1 ProをClaude-Codeハーネス環境で評価したと説明しています。つまり、数値そのものよりも「どの環境で測ったか」を先に確認する必要があります。
DeepSeek-V4.1-Flash-1017の数値はリリースブログからの引用で、その他のスコアは各モデルの公式ブログやTerminal-Bench 4.0リーダーボード記載の最高値とのことです(参照*4)。すなわち、比較対象間で必ずしも同一の実行条件が揃っているわけではありません。
価格と性能から見た立ち位置
単価の安さと僅差のベンチマーク結果だけで、一概に優劣を判断することはできません。私がモデルを評価するときも、まず「どの業務課題に使うか」を先に決めてから数字を見るようにしています。
0.7パーセントポイントという数値の解釈には慎重さが求められます。複数回試行によるばらつきや評価環境全体の精査がないまま、この微差を日々のコーディング業務における確定的な順位とみなすのは時期尚早であるとの見解もあります(参照*5)。
運用コストの観点からも、単価の比較のみでは実態を把握しきれません。K3.1 Proは推論処理を無効化できず、強度はlow、high、maxの3段階が用意され、明示的に指定しない限りmaxが適用されます(参照*6)。
出力トークン量が増えれば、その分だけ出力課金が嵩みます。Artificial Analysisの検証でも、トークン単価は33%安いものの出力トークンが14%多く消費され、1タスクあたりの費用はKimi K3とほぼ変わらない1.98ドルでした(参照*3)。
Kimi K3.1 Proの基本仕様
3TクラスMoEと1Mトークンコンテキスト
Kimi K3.1 Proの基盤となる構造や仕様数値を整理します。
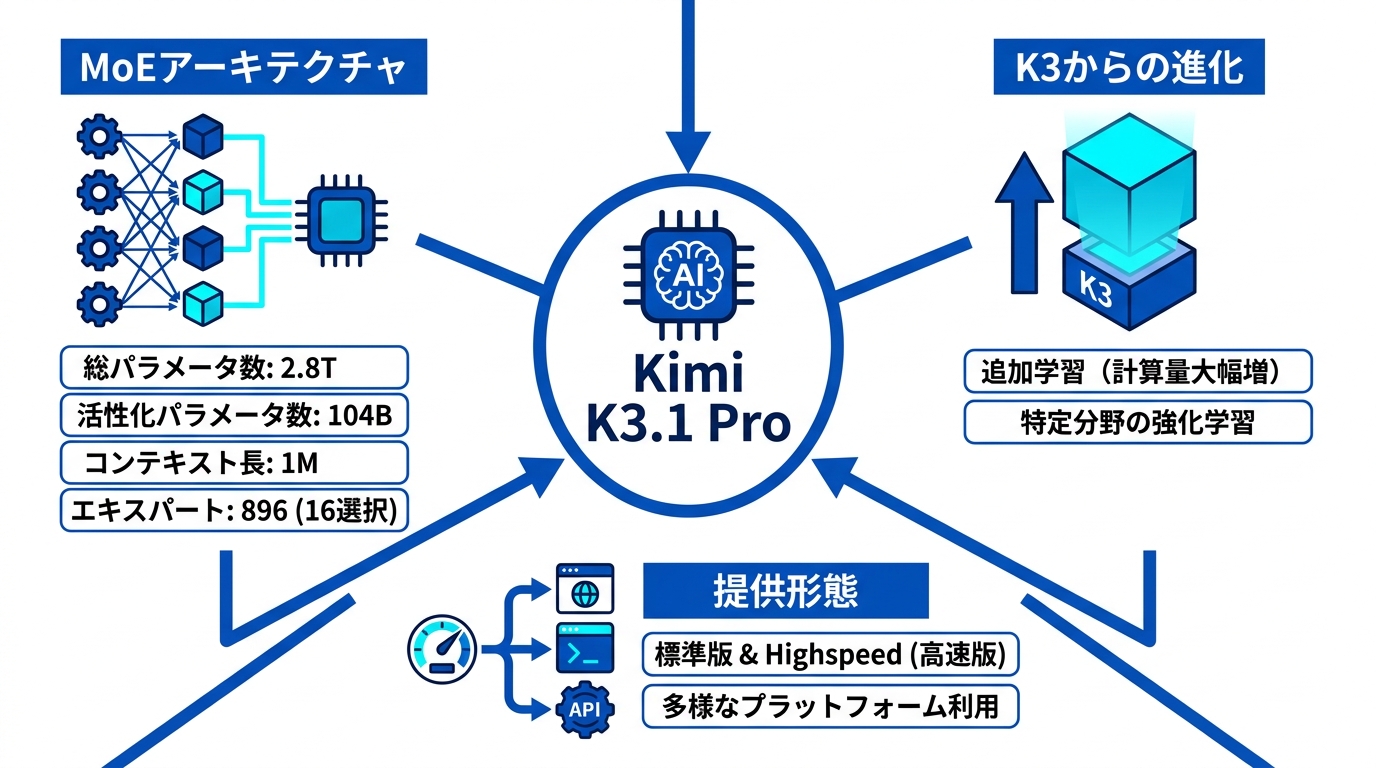
MoE(Mixture-of-Experts)は、内部に多数の専門ネットワークを用意し、入力に応じて必要な一部のみを稼働させる仕組みです。Kimi K3.1 ProのアーキテクチャはこのMoEを採用しており、総パラメータ数は2.8T、活性化パラメータ数は104Bとなっています。
エキスパート総数は896で、トークンごとに16個が選択されます。コンテキスト長は1048576トークンです(参照*7)。
なお、「3Tクラス」という表現の解釈には留意が必要です。Moonshotは自社モデルを「3Tクラス」と呼称していますが、この概算表記を根拠にパラメータ数が正確に3兆個存在すると捉えるべきではないと指摘されています(参照*5)。
K3からの変更点と提供形態
K3.1 Proが前世代からどの程度進化したのか、詳細を確認します。
Kimi K3.1 Proは完全な新規アーキテクチャではありません。Moonshotは「Kimi K3を追加学習させたモデルであり、追加学習の計算量を大幅に増やした」と述べています。
基底モデルはKimi K3と共通で、性能向上はMoonshotが「数百の下流領域」と表現する特定分野での強化学習によって達成されました。重点領域としてはコーディング、3Dモデリング、金融などが挙げられます(参照*1)。
提供形態についても整理しておきます。Moonshotは、Kimi K3.1 Proより2〜3倍高速で応答性に優れたKimi K3.1 Pro Highspeedも併せて展開しています。
両モデルともにKimi.ai、Kimi Work、Kimi Code、Kimi APIから利用可能です。なお、モデルの全ウェイトは2026年11月4日までに一般公開される見込みとなっています(参照*4)。
ベンチマークの読み方
独立評価機関が示した数値
自社公表値とは別に、第三者評価機関による測定結果も公表されています。自社報告と第三者報告を並べて見ることで、初めて数値の意味が見えてきます。
Artificial AnalysisはK3.1 Proを複数のベンチマークで測定しました。GDPval-AAでは1,846 Eloを記録して第3位となり、Kimi K3から312 Eloスコアを伸ばしています。
上位にはClaude Opus 5.5の1,866 EloとMuse Wonder Fullの1,857 Eloが並びます。Terminal-Bench 4.0では全モデル中首位をマークし、K3.1 Proは67%、Kimi K3は13%、Claude Sonnet 5.5は64%という結果でした(参照*3)。なお、Moonshotの自社報告値65.7%と第三者測定の67%に差が出ている点も見逃せません。
総合指数における位置づけも見ていきます。Artificial Analysisの総合指数スコアは55.1で第4位でした。
上位陣はClaude Opus 5.5の57.6、Claude Sonnet 5.5の56.0、Muse Wonder Fullの55.8です(参照*1)。同一のTerminal-Bench 4.0であっても、Moonshot報告の65.7%とArtificial Analysis測定の67%で差が生じており、評価環境の違いが数値に反映される典型例です。
得意分野と弱点の具体値
測定結果からは、モデルの得意領域と不得意領域の明確な差異が見て取れます。
弱点として浮き彫りになったのがTerminal-Bench Science 0.1です。K3.1 Proは38.1にとどまりました。
Kimiの比較データによれば、GPT-6 Astraは68.1、Opus 5.5は63.3を記録しています。その一方で、SWE-Marathonでは51.7を獲得しトップに立ちました(参照*8)。
金融ドメインの文書処理タスクにおいても優れた数値が示されています。OfficeQA Pro v2は、実世界の金融文書をベースに、情報検索、文書間照合、多段階の数値推論を伴う高度な財務分析力を測るテストです。Moonshotは、本テストでK3.1 Proが最高水準となる64.4を達成したと公表しています(参照*4)。
幻覚率の2つの数字
ハルシネーション(幻覚)発生率に関しては、測定基準の異なる2つのデータが存在します。私自身、生成AIを業務に使う中で、ハルシネーションは「文章がうまく見えるほど気づきにくい」という問題を実感しています。だからこそ、数値の前提を確認する習慣が欠かせません。
1つはMoonshotの社内測定指標です。事実性の精度を厳格に問うKimi Hallu Bench Hardにおいて、主張単位の幻覚率はK3の23.4%から8.3%へと減少しました。Moonshotはこのテストについて、モデルの失策傾向を特定するために意図的に作成された高負荷環境であり、日常利用における全体的なエラー率を示すものではないと補足しています(参照*4)。
もう1つは第三者機関の計測結果です。Artificial AnalysisはAA-OmniscienceにおいてK3.1 Proの幻覚率を44%と測定し、K3の53%から改善したと報告しました。
正確性は48%から51%へ上昇しています。両テストは評価対象が異なるため、双方の数値ともそれぞれの条件下で妥当性を持っています(参照*1)。
ハーネスで順位が変わる理由
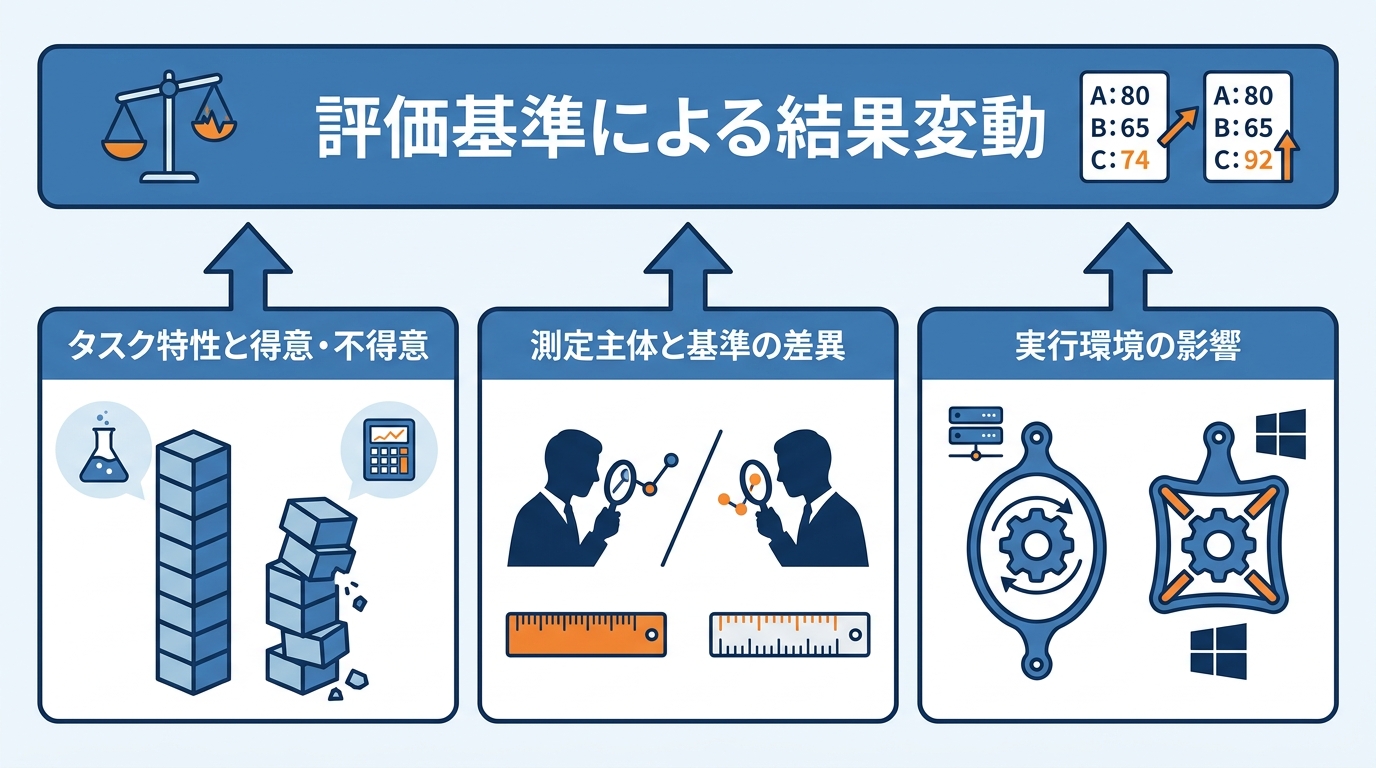
同一のモデルであっても、実行環境となる枠組みが異なれば順位付けは変動します。これはベンチマークを読む際に常に意識すべき前提です。
ハーネスとはモデルに推論タスクを実行させるためのフレームワークです。研究報告によると、モデル間の順位は採用するハーネスによって容易に逆転します。
Terminal-Bench 4において、OpenHands環境ではClaudeがGPTを7.94ポイント上回る一方、PI環境では30.16ポイント下回りました。検証された5モデル中4モデルで、最適となるハーネスがテストごとに分かれています(参照*9)。
この知見は、0.7ポイント差の捉え方にも直結します。反復検証でのばらつきや実行条件の詳細が十分に明かされていない段階で、K3.1 ProとOpus 5.5のスコア差を実務コーディングの絶対的な序列と解釈するのは早計です(参照*5)。私の立場から言えば、ベンチマーク上の僅差よりも、自社の想定タスクで実際に試した結果のほうがよほど意思決定の材料になります。
オープンウェイト戦略と安全性
11月4日までのウェイト公開予定
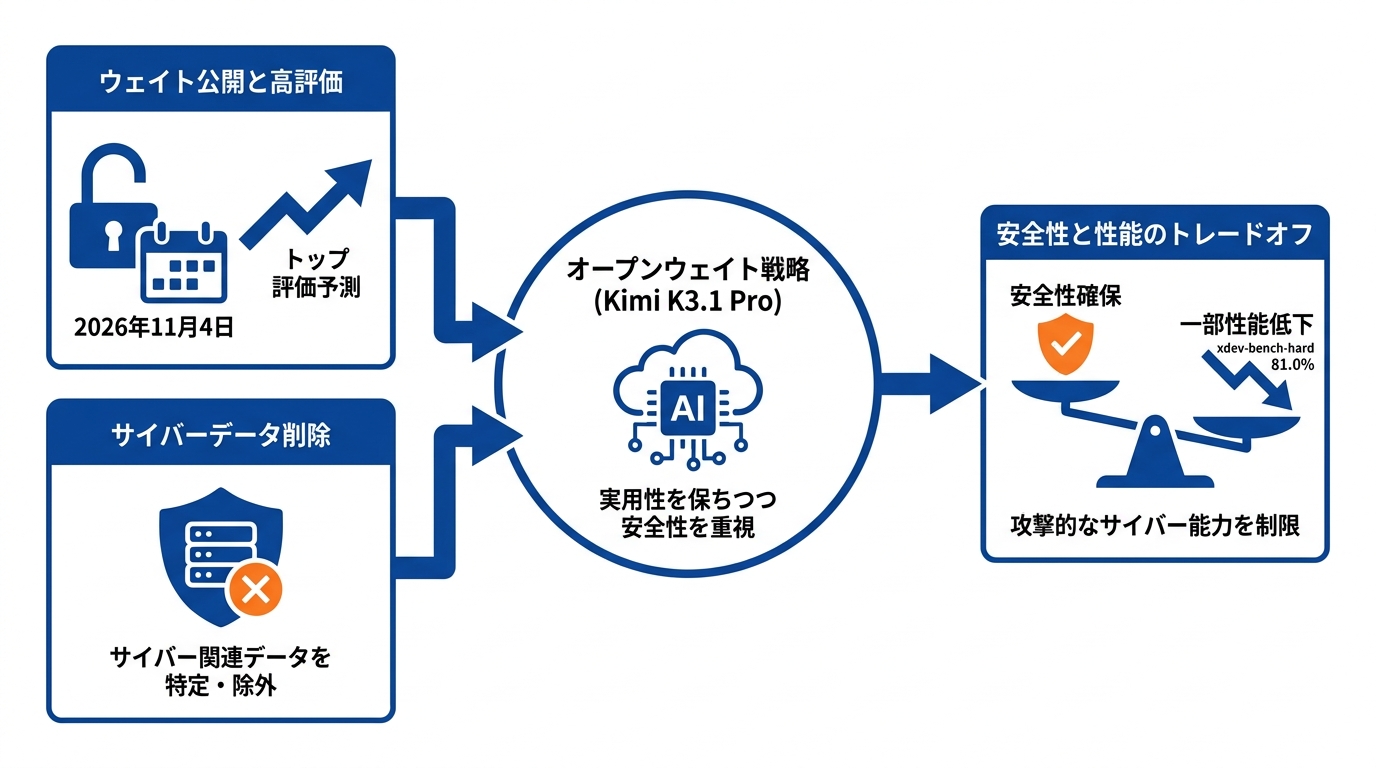
重み(ウェイト)データの一般公開予定は、本モデルにおける最大の注目点の1つです。オープンウェイトになれば、自社インフラでの運用やファインチューニングが可能になり、クラウドAPIに縛られない選択肢が生まれます。
現在はクラウドホスト形式での提供にとどまります。Kimi K3.1 ProはKimi API経由で利用できますが、まだオープンウェイトではありません。Moonshotは「2026年11月4日までに全ウェイトを一般公開する」と表明しています(参照*2)。
この期日が重視される理由は、独立評価機関の予測値にあります。Artificial Analysisは、ウェイトが公開されればKimi K3.1 Proが同機関の評価指数でトップのオープンウェイトモデルになると試算しています。
最上位のオープンモデルと商用独自モデルの格差は、12ポイントから3ポイントへ急縮小する見込みです。Moonshotは過去にも7月16日にKimi K3を発表し、予告通り7月27日にHugging Faceで重みを公開した実績があります(参照*1)。
サイバー関連データ削除とその影響
公開に先立ち、Moonshotはモデルのトレーニングデータに調整を加えています。
削減されたのはサイバーセキュリティ領域のデータです。Moonshotはオープンウェイト公開にあたり、実用性に不可欠な汎用プログラミング能力を保ちつつ、中間学習・強化学習の双方からサイバー関連データを特定・除外したと公表しました(参照*4)。
その処置による性能変化もデータで示されています。xdev-bench-hardにおいて、中間段階でサイバーデータを残しRL環境のフィルタリングも外した中間版は、pass@3で課題の90.5%をクリアしました。対して安全調整を施した最終版K3.1 Proは81.0%となっています(参照*4)。
Moonshotは、攻撃的なサイバー能力は「少なくとも3か月前から公開されている最先端の独自モデルに及ばない」とし、「サイバー能力の絶対的な最先端を更新するようなオープンウェイトは公開しない」方針を示しています。なお、これらの検証値は自社計測によるもので、外部機関による追試は未実施です(参照*1)。
利用時の注意点
推論設定と出力トークンの扱い
実際にモデルの利用を開始する前に、パラメータ設定の仕様を押さえておく必要があります。特に推論設定まわりは、コストに直接影響するため注意が必要です。
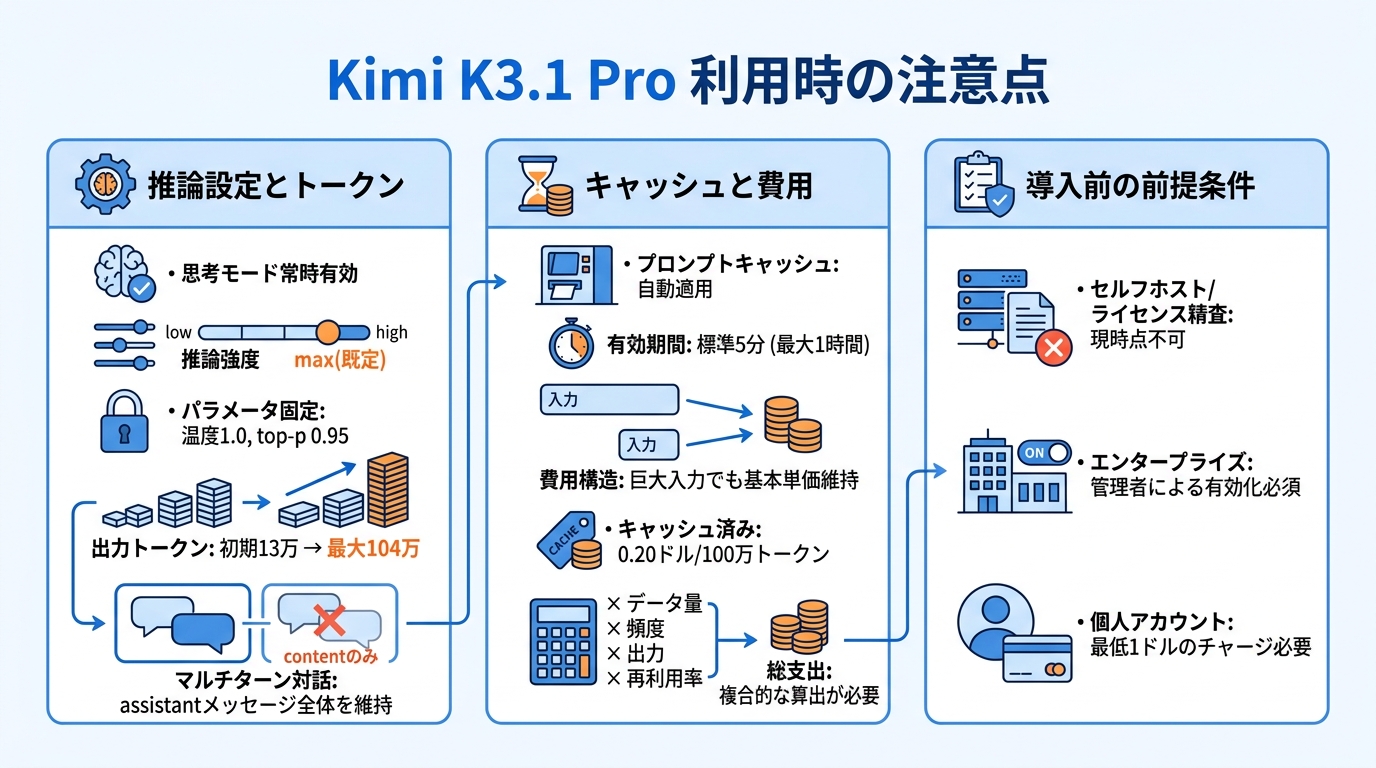
本モデルでは思考モードが常時有効となっています。推論の強度設定はlow、high、maxから選択可能で、既定値はmaxです。
温度パラメータは1.0、top-pは0.95に固定されています。出力トークン数の初期値は131,072で、最大1,048,576トークンまで拡張可能です(参照*8)。
複数ターンの対話を構築する場合、レスポンスの受け渡し規則に注意が必要です。Kimi K3は思考履歴を文脈として維持する形式で学習されています。マルチターン対話やツール連携を行う際は、APIから返却されたassistantメッセージ一式を、reasoning_contentやtool_callsも含めて欠損なくmessagesに引き渡さなければなりません。単にcontent部分のみを渡す形では正常に動作しない仕様です(参照*7)。
キャッシュと費用の考え方
トータルコストの試算においては、プロンプトキャッシュの挙動が大きく作用します。「100万トークン単価」だけを見て安い高いと判断するのは、実務では危険です。
入力サイズが巨大化しても基本単価は跳ね上がりません。100万トークンのウィンドウ全体で同一単価が維持され、長文に応じた段階加算は発生しない構造です。
キャッシュ機能は自動適用され、標準の有効期間は5分間となっています。実行頻度の低いバッチ処理などでは、最大1時間の有効期間を指定することも可能です(参照*6)。
キャッシュ済み入力は100万トークンあたり0.20ドルで計算されます(参照*1)。
単価の多寡のみで総支出を判断することはできません。Kingy.aiは、レポート上の数値はモデル計算例であり、自社ベンチマークの実請求額とは異なると述べています。そのうえで、一律の「100万トークン単価」だけでプロジェクト費用は見積もれず、送信データ量、再送頻度、モデルの総出力量、そしてキャッシュ再利用率を総合して算出する必要があると提言しています(参照*10)。
導入前に確認する条件
採用を判断するにあたり、クリアすべき前提条件がいくつか存在します。私がモデル導入を検討するときは、価格とベンチマークの前に、まず自社の運用要件と照合することにしています。
ローカル環境でのセルフホストやライセンス条項の精査は、現時点では実施できません。自社インフラでの運用が必須な場合や、法務部門によるライセンス条項の厳密なレビューを伴う場合は、モデルウェイトの一般公開を待つ必要があります(参照*6)。
エンタープライズ環境での利用には有効化の設定が求められます。Kimi Enterprise管理者は、組織アカウント内でK3.1 Proの利用権限を付与できます。初期状態ではアクセスが無効化されているため注意が必要です(参照*4)。
なお、個人アカウントで試用する場合は、最低1ドルのクレジットをチャージすることで利用可能となります(参照*8)。
おわりに
Kimi K3.1 Proは、入力2.00ドル/出力10.00ドルというClaude Opus 5.5の半値に近い価格設定でありながら、Terminal-Bench 4.0の自社公表値においてわずか0.7ポイント差と肉薄しました。しかし、Artificial Analysisの測定結果では1タスクあたりの実質費用がKimi K3とほぼ並ぶ1.98ドルとなっており、名目上の単価の低さが直ちに総コストの削減に結びつくわけではありません。この点は、新モデルの発表時に「安い」という見出しだけで飛びつく前に、必ず確認すべき数字です。
もう1つの焦点は、2026年11月4日までに予定される全ウェイトの一般公開と、それに伴うサイバー関連データの除外措置です。xdev-bench-hardでは対策未適用モデルの90.5%から最終版で81.0%へと数値が落ちており、これらも外部検証を待つ段階にあります。モデル性能は採用するハーネスによって順位が変動するため、自社の想定ユースケースに即した条件下で、ベンチマークとコストの両面を精査する姿勢が不可欠です。私自身、新モデルが出るたびに宣伝文句ではなく手元のタスクで実力を確かめることにしています。Kimi K3.1 Proも、ウェイト公開後に実際の業務課題で試すまでは、現時点での評価はあくまで暫定と位置づけています。
監修者
安達裕哉(あだち ゆうや)
デロイト トーマツ コンサルティングにて品質マネジメント、人事などの分野でコンサルティングに従事しその後、監査法人トーマツの中小企業向けコンサルティング部門の立ち上げに参画。大阪支社長、東京支社長を歴任したのち2013年5月にwebマーケティング、コンテンツ制作を行う「ティネクト株式会社」を設立。ビジネスメディア「Books&Apps」を運営。
2023年7月に生成AIコンサルティング、およびAIメディア運営を行う「ワークワンダース株式会社」を設立。ICJ2号ファンドによる調達を実施(1.3億円)。
著書「頭のいい人が話す前に考えていること」 が、95万部(2026年6月時点)を売り上げる。
(“2023年・2024年上半期に日本で一番売れたビジネス書”(トーハン調べ/日販調べ))
参照
- (*1) Fello AI – Benchmarks, Pricing and How to Use It
- (*2) Simon Willison’s Weblog – Introducing Kimi K3.1 Pro
- (*3) Kimi K3.1 Pro launches at 4th on the Intelligence Index and will lead open weights models
- (*4) Advancing Open Intelligence
- (*5) Kingy AI – Features, Benchmarks, Pricing and Access
- (*6) Kimi K3.1 Pro Review: Benchmarks, Pricing and Upgrade Advice
- (*7) OpenLM.ai – Kimi K3.1 | OpenLM.ai
- (*8) MarkTechPost – Moonshot AI Releases Kimi K3.1 Pro: A 2.8T Total/104B Active Params (MoE) Model with 1M Context
- (*9) Finding the Right Fit:
- (*10) Kingy AI – API, Caching & Membership Prices